Módulo 16: Base de datos con Drizzle
Objetivos del módulo
- Entender por qué una aplicación Next.js puede hablar directamente con su base de datos, sin una API intermedia, y qué responsabilidades asumes al hacerlo
- Conocer SQLite y libSQL, y elegir con criterio entre Drizzle, Prisma y SQL escrito a mano
- Definir en TypeScript el esquema EMPRESA completo (nueve tablas) con sus claves primarias, claves ajenas, nulos, restricciones
CHECKe índices - Generar y aplicar migraciones con
drizzle-kit, y saber qué guarda cada fichero que produce - Cargar los datos de
datos.jsoncon un script repetible y atómico, respetando sus nulos reales - Escribir consultas con Drizzle: filtros, joins, agregados, consultas relacionales, inserciones, actualizaciones, borrados y transacciones
- Interpretar los errores de SQLite (claves duplicadas, claves ajenas, restricciones) y convertirlos en mensajes útiles
- Construir una capa de acceso a datos en
lib/db, protegida conserver-only, que devuelve objetos pensados para cada pantalla - Leer la base de datos desde Server Components con
'use cache',cacheTagycacheLife, y escribir en ella desde Server Actions que renuevan la caché conupdateTag - Saber qué cambia si sigues en Next.js 15
💡 Consejo: Todo el código de este módulo se ha compilado con
next buildy ejecutado connext starten Next.js 16.4.3, condrizzle-orm0.45.4,drizzle-kit0.31.11 y@libsql/client0.18.0 sobre Node.js 24. Las salidas que ves (SQL generado, mensajes de error, tablas del build, registros del servidor) son las reales. Las alternativas para Next.js 15 se han compilado en Next.js 15.5.28. Usa siempre el último parche de Next.js 16.4.
📘 Concepto: Este módulo crea la base de datos que usan los módulos 17 a 25: la autenticación del módulo 17 le añadirá usuarios, las pruebas del módulo 21 la simularán y el proyecto final la completará. Todo lo que necesitas para recrearla está en
recursos/empresa-db.zip: el esquema, la configuración dedrizzle-kit, las migraciones, el script de carga y el propiodatos.json.
1. Por qué una base de datos propia
Hasta el módulo 15 los datos venían de la API EMPRESA (recursos/empresa-api.zip): un servidor aparte, en el puerto 3000, al que Next pedía JSON con fetch. Es el esquema clásico de una SPA: el frontend no sabe nada de tablas, solo de URL.
Con Server Components y Server Actions, el código de tu aplicación Next ya se ejecuta en un servidor. Ese servidor puede abrir la base de datos y consultarla igual que lo haría un backend en Java, PHP o Node con Express. La API intermedia deja de ser obligatoria:
Antes (módulos 00-15)                     Ahora (módulos 16-25)

Navegador ──► Next (RSC) ──► API REST ──► datos.json        Navegador ──► Next (RSC + Actions) ──► empresa.db
             fetch()         Express                                     Drizzle ORM
Lo que ganas:
| Aspecto | Con la API intermedia | Con la base de datos en Next |
|---|---|---|
| Saltos de red por página | Navegador → Next → API → datos | Navegador → Next → fichero o servidor SQL |
| Tipos | Escribes a mano el tipo de cada respuesta JSON y confías en que coincida | Los tipos salen del esquema: si cambias una columna, TypeScript te avisa en cada consulta |
| Consultas | Lo que la API ofrezca (/api/empleados?deptId=20) | Cualquier consulta: joins, agregados, transacciones |
| Código que mantener | Dos proyectos | Uno |
Y lo que asumes: Next pasa a ser tu backend. La validación de datos, la autorización y la gestión de errores que antes hacía la API son ahora responsabilidad tuya. Por eso este módulo insiste en una capa de acceso a datos (apartado 8): un único sitio por donde pasa todo acceso a la base de datos.
⚠️ Importante: Hablar con la base de datos desde Next no significa hacerlo desde el navegador. Todo el código de este módulo se ejecuta en el servidor. Si por error importas el cliente de la base de datos desde un Client Component, el
buildfalla (lo verás en el apartado 8.3). Ese fallo es una protección, no un estorbo.
1.1. SQLite y libSQL
SQLite es un motor de base de datos SQL que guarda toda la base de datos en un único fichero (empresa.db). No hay que instalar ni arrancar ningún servidor: la biblioteca lee y escribe el fichero directamente. Es la base de datos más desplegada del mundo (está en todos los móviles y navegadores) y, para un curso, tiene una ventaja enorme: cada alumno tiene su base de datos con un npm install.
libSQL es una variante de SQLite de código abierto mantenida por la empresa Turso. Es compatible con los ficheros de SQLite y añade la posibilidad de conectarse a una base de datos remota con la misma API. El paquete @libsql/client es su cliente para JavaScript:
- Con
url: 'file:empresa.db'abre un fichero local, como SQLite. - Con
url: 'libsql://mi-bd.turso.io'y unauthTokense conecta a una base de datos remota de Turso.
Así, el código que escribes hoy contra un fichero sirve mañana contra un servidor, cambiando solo una variable de entorno. Lo comprobarás en el módulo 23.
📘 Concepto: Su API es asíncrona (todas las consultas devuelven promesas), a diferencia de
better-sqlite3o del módulonode:sqlitede Node, que son síncronos. Este detalle importa más de lo que parece cuando Next prerenderiza páginas: lo verás en el apartado 9.4.
1.2. Drizzle, Prisma o SQL a mano
Para hablar con la base de datos desde TypeScript tienes tres caminos:
| Opción | Cómo se escribe una consulta | Esquema | Tipos | Peso |
|---|---|---|---|---|
SQL a mano (cliente.execute('select ...')) | Texto SQL | Ficheros .sql que mantienes tú | Ninguno: cada fila es Record<string, unknown> | Mínimo |
| Drizzle ORM | Funciones que se parecen al SQL: db.select().from(empleados).where(...) | Fichero TypeScript (schema.ts) | Inferidos del esquema, sin generar código | Ligero, sin binarios propios |
| Prisma | Objetos: prisma.empleado.findMany({ where: {...} }) | Lenguaje propio (schema.prisma) | Generados con prisma generate | Más pesado, con su propio motor de consultas |
Este curso usa Drizzle por tres razones:
- Si sabes SQL, sabes Drizzle.
select,from,where,leftJoin,groupBy… tienen el mismo nombre y el mismo orden que en SQL. Lo que aprendiste en bases de datos de DAM/DAW se aplica tal cual. - El esquema es TypeScript. No hay un lenguaje nuevo ni un paso de generación de tipos: los tipos se deducen al vuelo.
- No esconde el SQL. Puedes ver la sentencia exacta que genera cada consulta (
toSQL()) y escribir SQL a mano cuando lo necesites (sql\…``).
Drizzle tiene dos piezas:
drizzle-orm: la biblioteca que usas en tiempo de ejecución para consultar. Va endependencies.drizzle-kit: la herramienta de línea de órdenes que lee tu esquema y genera las migraciones SQL. Solo se usa en desarrollo: va endevDependencies.
2. Preparar el proyecto
2.1. Instalar los paquetes
Parte de un proyecto creado con create-next-app (el del módulo 01) e instala:
npm install drizzle-orm @libsql/client server-only
npm install -D drizzle-kit tsx
| Paquete | Para qué |
|---|---|
drizzle-orm | Definir el esquema y hacer consultas |
@libsql/client | El driver: abre empresa.db y ejecuta el SQL que genera Drizzle |
server-only | Marca módulos que nunca deben llegar al navegador (ya lo viste en el módulo 05) |
drizzle-kit | Generar y aplicar migraciones |
tsx | Ejecutar scripts TypeScript (el de carga de datos) sin compilarlos antes |
💡 Consejo: No necesitas configurar nada en
next.config.tspara@libsql/client. Next mantiene una lista de paquetes de servidor que no empaqueta, sino que carga desdenode_modulesen tiempo de ejecución, y@libsql/clientylibsqlya están en ella (node_modules/next/dist/lib/server-external-packages.jsonc). Es importante porque libSQL usa un binario nativo por plataforma (en Windows,@libsql/win32-x64-msvc) que no se puede meter en un bundle. Si usas otro driver nativo que no esté en la lista, añádelo aserverExternalPackages.
2.2. El recurso empresa-db.zip
Descarga recursos/empresa-db.zip y descomprímelo. Contiene:
empresa-db/
├── db/schema.ts               esquema de las 9 tablas, relaciones y tipos
├── drizzle.config.ts          configuración de drizzle-kit
├── drizzle/                   migraciones SQL generadas
│   ├── 0000_esquema_inicial.sql
│   └── meta/ (_journal.json, 0000_snapshot.json)
├── scripts/cargar-datos.ts    vacía las tablas y carga datos.json
├── scripts/comprobar.ts       consultas de comprobación
├── datos.json                 los mismos datos que la API EMPRESA
├── package.json               dependencias y scripts db:*
├── tsconfig.json
└── README.md
Puedes usarlo de dos formas:
- Por separado, para practicar las consultas de los apartados 5 a 7 sin Next:
npm install,npm run db:migrar,npm run db:cargar. - Dentro de tu proyecto Next: copia
db/,drizzle/,scripts/,drizzle.config.tsydatos.jsona la raíz del proyecto, y los scriptsdb:*a tupackage.json.
La estructura final del proyecto de este módulo es esta:
mi-app/
├── app/
│   ├── tienda/page.tsx              catálogo (en caché)
│   ├── tienda/[id]/page.tsx         ficha de producto
│   ├── tienda/[id]/acciones.ts      Server Action: cambiar el stock
│   ├── departamentos/page.tsx       listado con alta y baja
│   ├── departamentos/acciones.ts    Server Actions de departamentos
│   ├── departamentos/formularios.tsx  Client Components con useActionState
│   ├── pedidos/page.tsx             pedidos siempre al día
│   └── pedidos/acciones.ts
├── db/schema.ts                     esquema (del zip)
├── drizzle/                         migraciones (del zip)
├── drizzle.config.ts                (del zip)
├── scripts/cargar-datos.ts          (del zip)
├── datos.json                       (del zip)
├── lib/db/                          capa de acceso a datos (apartado 8)
│   ├── index.ts                     cliente de Drizzle
│   ├── errores.ts                   traducir errores de SQLite
│   ├── catalogo.ts
│   ├── departamentos.ts
│   └── pedidos.ts
└── empresa.db                       la base de datos (no se sube a Git)
2.3. Scripts y .gitignore
Añade estos scripts a package.json:
{
  "scripts": {
    "dev": "next dev",
    "build": "next build",
    "start": "next start",
    "db:generar": "drizzle-kit generate",
    "db:migrar": "drizzle-kit migrate",
    "db:cargar": "tsx scripts/cargar-datos.ts",
    "db:comprobar": "tsx scripts/comprobar.ts",
    "db:preparar": "drizzle-kit migrate && tsx scripts/cargar-datos.ts"
  }
}
Y estas líneas a .gitignore:
empresa.db
empresa.db-*
El fichero de la base de datos no se sube al repositorio: cada persona lo crea con npm run db:preparar. Lo que sí se sube es la receta para crearlo: el esquema y las migraciones. El patrón empresa.db-* cubre los ficheros auxiliares que SQLite crea a veces junto a la base de datos (-journal, -wal, -shm).
2.4. Dónde está el fichero: DATABASE_URL
Todos los ficheros de este módulo leen la ubicación de la base de datos de la variable de entorno DATABASE_URL, y si no existe usan file:empresa.db:
const url = process.env.DATABASE_URL ?? 'file:empresa.db'
Una ruta file: relativa se resuelve desde la carpeta en la que ejecutas el comando. npm run dev, npm run build, npm start y los scripts db:* se lanzan desde la raíz del proyecto, así que todos usan el mismo empresa.db. Si lanzas un script desde otra carpeta, libSQL crea allí un fichero vacío nuevo y tus consultas fallan con no such table (apartado 9.6).
💡 Consejo: Next carga automáticamente los ficheros
.env*(módulo 13), perodrizzle-kitytsxno. Si definesDATABASE_URLen.env.local, pásala también a los scripts, por ejemplo con la opción de Node--env-file:"db:cargar": "tsx --env-file=.env.local scripts/cargar-datos.ts". Con el valor por defecto no hace falta nada.
3. El esquema EMPRESA
El esquema es la descripción de las tablas: columnas, tipos, claves y restricciones. En Drizzle se escribe en TypeScript, y de ese mismo fichero salen dos cosas: el SQL que crea las tablas (apartado 4) y los tipos de TypeScript de tus consultas.
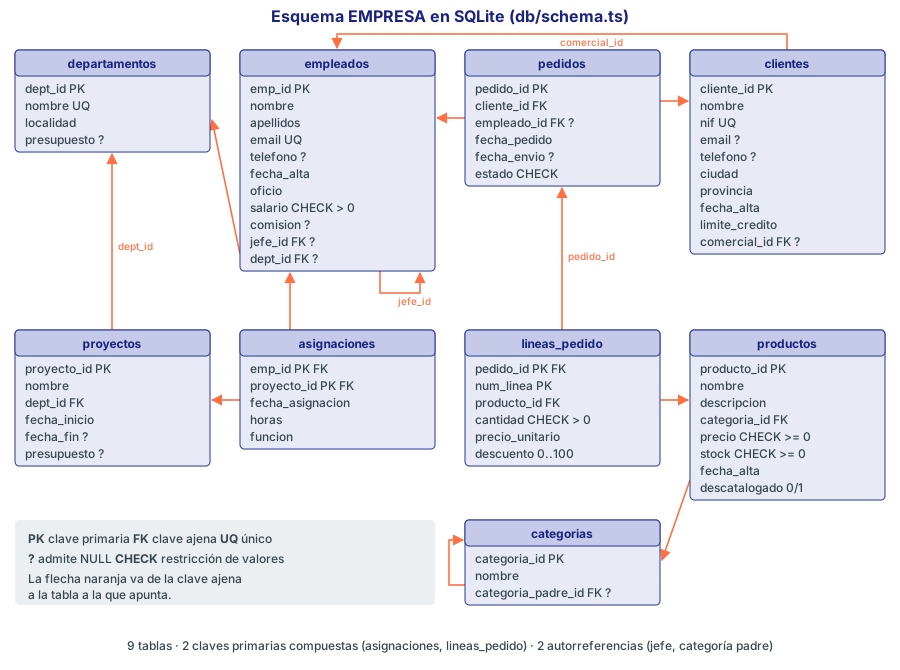
Figura 1. El esquema EMPRESA. Cada flecha naranja va de una clave ajena a la tabla a la que apunta. ? indica una columna que admite NULL.
3.1. De datos.json a tablas
datos.json tiene nueve colecciones. Cada una será una tabla, con las mismas propiedades como columnas:
| Colección | Filas | Clave primaria | Nulos reales en los datos |
|---|---|---|---|
departamentos | 7 | deptId (10 a 70) | presupuesto en el 70 (INVESTIGACIÓN) |
empleados | 24 | empId (desde 100) | comision (20), telefono (3), jefeId (Ana, la directora), deptId (Tomás, el becario) |
clientes | 14 | clienteId (desde 1001) | email (2), telefono (1), comercialId (2) |
categorias | 11 | categoriaId | categoriaPadreId en las 3 categorías raíz |
productos | 20 | productoId (desde 1) | ninguno |
pedidos | 24 | pedidoId (desde 5001) | fechaEnvio (4 sin enviar), empleadoId (2) |
lineasPedido | 51 | pedidoId + numLinea | ninguno |
proyectos | 5 | proyectoId | fechaFin (3 en curso), presupuesto (proyecto 5) |
asignaciones | 14 | empId + proyectoId | ninguno |
Esos nulos no son errores de los datos: significan algo. Un empleado sin jefeId es la cima del organigrama; un pedido sin fechaEnvio todavía no ha salido del almacén. El esquema debe permitirlos exactamente donde aparecen y prohibirlos en el resto. Fíjate también en un detalle: Sergio tiene comision: 0 y otros veinte empleados tienen comision: null. No es lo mismo: 0 significa “cobra comisión, pero este periodo ha sido cero”; null, “no cobra comisión”. Si los mezclas (por ejemplo, convirtiendo los null en 0), pierdes información.
3.2. Los tipos de SQLite y cómo los ve TypeScript
SQLite tiene pocos tipos de almacenamiento. Drizzle los expone con funciones de drizzle-orm/sqlite-core:
| Función de Drizzle | Tipo en SQLite | Tipo en TypeScript | En EMPRESA |
|---|---|---|---|
integer('col') | integer | number | identificadores, stock, horas |
integer('col', { mode: 'boolean' }) | integer (0 o 1) | boolean | descatalogado |
integer('col', { mode: 'timestamp' }) | integer (segundos) | Date | no se usa |
real('col') | real | number | importes: salario, precio, presupuesto |
text('col') | text | string | nombres, fechas 'AAAA-MM-DD' |
text('col', { enum: [...] }) | text | unión de literales | estado de un pedido |
Tres decisiones de diseño que conviene entender:
Las fechas se guardan como texto 'AAAA-MM-DD'. SQLite no tiene tipo fecha. Como datos.json ya trae las fechas en formato ISO, guardarlas como texto tiene dos ventajas: se cargan sin conversión, y se ordenan y comparan bien como texto ('2023-01-09' < '2025-09-01'). Funciona porque el formato ISO va del dato más significativo al menos significativo y usa ceros a la izquierda. Con '9/1/2025' no funcionaría.
El dinero se guarda como real. Es la opción más sencilla para un curso y coincide con datos.json (precio: 19.9). En una aplicación de facturación real se suele guardar en céntimos con integer, para evitar los errores de redondeo de los números de coma flotante (0.1 + 0.2 !== 0.3). Las consultas de este módulo redondean los totales a dos decimales con round(..., 2).
notNull() decide si TypeScript admite null. Una columna sin notNull() tiene tipo number | null o string | null. TypeScript te obligará a tratar el caso nulo cada vez que la uses, que es justo lo que quieres con presupuesto o fechaEnvio.
3.3. Tablas, columnas y nombres
Una tabla se define con sqliteTable(nombreEnSQL, columnas, extras):
import { integer, real, sqliteTable, text } from 'drizzle-orm/sqlite-core'

export const departamentos = sqliteTable('departamentos', {
  deptId: integer('dept_id').primaryKey(),
  nombre: text('nombre').notNull().unique(),
  localidad: text('localidad').notNull(),
  presupuesto: real('presupuesto'), // null: presupuesto sin asignar (dpto. 70)
})
Cada columna tiene dos nombres:
- La clave del objeto (
deptId) es el nombre en TypeScript. Coincide condatos.jsony con la API EMPRESA, así que los objetos del JSON se insertan sin transformarlos. - El argumento (
'dept_id') es el nombre de la columna en SQL. Se usa la convenciónsnake_casehabitual en bases de datos.
Drizzle traduce de uno a otro en cada consulta: escribes departamentos.deptId y el SQL dice "dept_id".
💡 Consejo: Si no quieres escribir cada nombre dos veces, Drizzle admite la opción
casing: 'snake_case'tanto endrizzle()como endrizzle.config.ts, y deducedept_iddedeptId. Aquí se escriben explícitos para que veas la correspondencia.
integer(...).primaryKey() en SQLite es especial: la columna pasa a ser un alias del identificador interno de fila (rowid). Si insertas sin dar un valor, SQLite asigna el mayor existente más uno. Lo verás en el apartado 6.6: el nuevo departamento recibe el 71.
3.4. Claves ajenas y qué pasa al borrar
Una clave ajena se declara con .references():
deptId: integer('dept_id').references(() => departamentos.deptId, {
  onDelete: 'no action', // no se borra un departamento con empleados
}),
La función flecha () => departamentos.deptId permite referirse a una tabla declarada más abajo en el fichero. La opción onDelete decide qué hace SQLite cuando se borra la fila a la que apunta la clave:
onDelete | Qué pasa al borrar el padre | En EMPRESA |
|---|---|---|
'cascade' | Se borran también las filas hijas | Líneas de un pedido, asignaciones de un empleado o proyecto |
'set null' | La clave de las hijas pasa a NULL | El jefe de un empleado, el comercial de un cliente, el empleado de un pedido |
'no action' (por defecto) | Si quedan hijas, el borrado falla | Departamentos con empleados o proyectos, clientes con pedidos, productos vendidos, categorías con productos |
'restrict' | Falla en cuanto hay una hija, incluso a mitad de una sentencia | No se usa (ver la caja) |
Cada elección responde a una pregunta de negocio. ¿Tiene sentido una línea de pedido sin su pedido? No: cascade. ¿Y un pedido cuyo empleado se ha ido de la empresa? Sí, el pedido sigue siendo válido: set null. ¿Se puede borrar un producto que aparece en pedidos antiguos? No, porque se perdería el histórico de ventas: no action. En su lugar, se marca como descatalogado.
⚠️ Importante:
restrictyno actionparecen iguales, pero no lo son. Conno action, SQLite comprueba las claves ajenas al final de cada sentencia; conrestrict, en cada fila. La primera versión de este esquema usabarestrictencategorias.categoriaPadreId, y el script de carga funcionó la primera vez (tablas vacías) pero falló la segunda:delete from categoriasintentaba borrar “Informática” mientras “Portátiles” todavía apuntaba a ella, aunque la misma sentencia iba a borrar las dos. El error real fueSQLITE_CONSTRAINT_TRIGGER: FOREIGN KEY constraint failed. Conno actionla sentencia borra todo y comprueba al final, cuando ya no queda ninguna hija huérfana. Además,restrictda el códigoSQLITE_CONSTRAINT_TRIGGERen vez deSQLITE_CONSTRAINT_FOREIGNKEY, lo que complica distinguir el error (apartado 7).
📘 Concepto: En SQLite las claves ajenas no se comprueban si no se activan en cada conexión con
PRAGMA foreign_keys = ON. El cliente de libSQL las activa por defecto al abrir un fichero: el scriptcomprobar.tsdel zip lo consulta y respondeClaves ajenas activas: sí. Si algún día usas otro driver, compruébalo: sin esa línea, todas las claves ajenas de este apartado son decorativas.
3.5. Autorreferencias: jefes y categorías padre
empleados.jefeId apunta a la propia tabla empleados, y categorias.categoriaPadreId a categorias. TypeScript no puede deducir el tipo de una variable que se usa dentro de su propia inicialización, así que hay que darle el tipo de retorno de la función flecha a mano con AnySQLiteColumn:
import { type AnySQLiteColumn } from 'drizzle-orm/sqlite-core'

jefeId: integer('jefe_id').references((): AnySQLiteColumn => empleados.empId, {
  onDelete: 'set null',
}),
Sin la anotación (): AnySQLiteColumn, TypeScript da el error 'empleados' implicitly has type 'any' because it does not have a type annotation and is referenced directly or indirectly in its own initializer y la tabla entera pierde sus tipos.
3.6. Claves compuestas, índices y restricciones CHECK
El tercer argumento de sqliteTable es una función que recibe las columnas (t) y devuelve un array de extras:
export const lineasPedido = sqliteTable(
  'lineas_pedido',
  {
    pedidoId: integer('pedido_id')
      .notNull()
      .references(() => pedidos.pedidoId, { onDelete: 'cascade' }),
    numLinea: integer('num_linea').notNull(),
    productoId: integer('producto_id')
      .notNull()
      .references(() => productos.productoId, { onDelete: 'no action' }),
    cantidad: integer('cantidad').notNull(),
    precioUnitario: real('precio_unitario').notNull(),
    descuento: real('descuento').notNull().default(0), // porcentaje: 10 = 10 %
  },
  (t) => [
    primaryKey({ columns: [t.pedidoId, t.numLinea] }),
    index('lineas_producto_idx').on(t.productoId),
    check('lineas_cantidad_positiva', sql`${t.cantidad} > 0`),
    check('lineas_descuento_rango', sql`${t.descuento} BETWEEN 0 AND 100`),
  ],
)
primaryKey({ columns: [...] }): clave primaria compuesta. Una línea se identifica por su pedido y su número dentro del pedido: el pedido 5001 tiene las líneas 1, 2 y 3; el 5002, otras líneas 1, 2…index(nombre).on(columna): un índice acelera las búsquedas por esa columna. SQLite no crea índices automáticamente para las claves ajenas (sí para las claves primarias y las columnasunique), así que el esquema los crea para las claves ajenas por las que se consulta a menudo: los empleados de un departamento, los pedidos de un cliente…check(nombre, condición): una regla que SQLite comprueba en cadainsertyupdate. Si no se cumple, la operación falla.
La restricción CHECK del estado de un pedido merece un comentario:
estado: text('estado', { enum: ESTADOS_PEDIDO }).notNull().default('PENDIENTE'),
// ...
check('pedidos_estado_valido', sql`${t.estado} IN ('PENDIENTE', 'ENVIADO', 'ENTREGADO', 'CANCELADO')`),
La opción enum de text() solo afecta a TypeScript: el tipo de estado pasa a ser 'PENDIENTE' | 'ENVIADO' | 'ENTREGADO' | 'CANCELADO', y el compilador rechaza estado: 'PERDIDO'. Pero en SQL la columna sigue siendo text y admite cualquier cosa. Quien escriba en la base de datos sin pasar por tu código (otro programa, una consola SQL, un as never mal puesto) podría guardar un estado inválido. La restricción CHECK cierra esa puerta en la propia base de datos. Comprobado: forzar 'PERDIDO' saltándose los tipos falla con SQLITE_CONSTRAINT: CHECK constraint failed: pedidos_estado_valido.
💡 Consejo: Regla general: TypeScript protege tu código; las restricciones protegen tus datos. Pon las dos. Las restricciones
NOT NULL,UNIQUE,CHECKy las claves ajenas siguen funcionando cuando el código tiene un error, cuando alguien edita la base de datos a mano y cuando, dentro de dos años, otro programa escriba en ella.
3.7. El esquema completo
Este es db/schema.ts, tal como está en empresa-db.zip. Léelo con calma: todo lo de los apartados anteriores aparece aquí aplicado a las nueve tablas.
// Esquema EMPRESA para SQLite con Drizzle ORM.
// Las claves de TypeScript usan camelCase (como datos.json y la API EMPRESA);
// las columnas de la base de datos, snake_case.
import { relations, sql } from 'drizzle-orm'
import {
  check,
  index,
  integer,
  primaryKey,
  real,
  sqliteTable,
  text,
  type AnySQLiteColumn,
} from 'drizzle-orm/sqlite-core'

export const ESTADOS_PEDIDO = ['PENDIENTE', 'ENVIADO', 'ENTREGADO', 'CANCELADO'] as const

// ---------------------------------------------------------------------------
// Tablas
// ---------------------------------------------------------------------------

export const departamentos = sqliteTable('departamentos', {
  deptId: integer('dept_id').primaryKey(),
  nombre: text('nombre').notNull().unique(),
  localidad: text('localidad').notNull(),
  presupuesto: real('presupuesto'), // null: presupuesto sin asignar (dpto. 70)
})

export const empleados = sqliteTable(
  'empleados',
  {
    empId: integer('emp_id').primaryKey(),
    nombre: text('nombre').notNull(),
    apellidos: text('apellidos').notNull(),
    email: text('email').notNull().unique(),
    telefono: text('telefono'),
    fechaAlta: text('fecha_alta').notNull(), // 'AAAA-MM-DD'
    oficio: text('oficio').notNull(),
    salario: real('salario').notNull(),
    comision: real('comision'), // null: no cobra comisión; 0: cobra, pero 0 este periodo
    jefeId: integer('jefe_id').references((): AnySQLiteColumn => empleados.empId, {
      onDelete: 'set null',
    }),
    deptId: integer('dept_id').references(() => departamentos.deptId, {
      onDelete: 'no action', // no se borra un departamento con empleados
    }),
  },
  (t) => [
    index('empleados_dept_idx').on(t.deptId),
    index('empleados_jefe_idx').on(t.jefeId),
    check('empleados_salario_positivo', sql`${t.salario} > 0`),
    check('empleados_comision_no_negativa', sql`${t.comision} >= 0`),
  ],
)

export const clientes = sqliteTable(
  'clientes',
  {
    clienteId: integer('cliente_id').primaryKey(),
    nombre: text('nombre').notNull(),
    nif: text('nif').notNull().unique(),
    email: text('email'),
    telefono: text('telefono'),
    ciudad: text('ciudad').notNull(),
    provincia: text('provincia').notNull(),
    fechaAlta: text('fecha_alta').notNull(),
    limiteCredito: real('limite_credito').notNull().default(0),
    comercialId: integer('comercial_id').references(() => empleados.empId, {
      onDelete: 'set null',
    }),
  },
  (t) => [index('clientes_comercial_idx').on(t.comercialId)],
)

export const categorias = sqliteTable('categorias', {
  categoriaId: integer('categoria_id').primaryKey(),
  nombre: text('nombre').notNull(),
  categoriaPadreId: integer('categoria_padre_id').references(
    (): AnySQLiteColumn => categorias.categoriaId,
    { onDelete: 'no action' },
  ),
})

export const productos = sqliteTable(
  'productos',
  {
    productoId: integer('producto_id').primaryKey(),
    nombre: text('nombre').notNull(),
    descripcion: text('descripcion').notNull().default(''),
    categoriaId: integer('categoria_id')
      .notNull()
      .references(() => categorias.categoriaId, { onDelete: 'no action' }),
    precio: real('precio').notNull(),
    stock: integer('stock').notNull().default(0),
    fechaAlta: text('fecha_alta').notNull(),
    descatalogado: integer('descatalogado', { mode: 'boolean' }).notNull().default(false),
  },
  (t) => [
    index('productos_categoria_idx').on(t.categoriaId),
    check('productos_precio_no_negativo', sql`${t.precio} >= 0`),
    check('productos_stock_no_negativo', sql`${t.stock} >= 0`),
  ],
)

export const pedidos = sqliteTable(
  'pedidos',
  {
    pedidoId: integer('pedido_id').primaryKey(),
    clienteId: integer('cliente_id')
      .notNull()
      .references(() => clientes.clienteId, { onDelete: 'no action' }),
    empleadoId: integer('empleado_id').references(() => empleados.empId, {
      onDelete: 'set null',
    }),
    fechaPedido: text('fecha_pedido').notNull(),
    fechaEnvio: text('fecha_envio'), // null: todavía no se ha enviado
    estado: text('estado', { enum: ESTADOS_PEDIDO }).notNull().default('PENDIENTE'),
  },
  (t) => [
    index('pedidos_cliente_idx').on(t.clienteId),
    index('pedidos_empleado_idx').on(t.empleadoId),
    check(
      'pedidos_estado_valido',
      sql`${t.estado} IN ('PENDIENTE', 'ENVIADO', 'ENTREGADO', 'CANCELADO')`,
    ),
  ],
)

export const lineasPedido = sqliteTable(
  'lineas_pedido',
  {
    pedidoId: integer('pedido_id')
      .notNull()
      .references(() => pedidos.pedidoId, { onDelete: 'cascade' }),
    numLinea: integer('num_linea').notNull(),
    productoId: integer('producto_id')
      .notNull()
      .references(() => productos.productoId, { onDelete: 'no action' }),
    cantidad: integer('cantidad').notNull(),
    precioUnitario: real('precio_unitario').notNull(),
    descuento: real('descuento').notNull().default(0), // porcentaje: 10 = 10 %
  },
  (t) => [
    primaryKey({ columns: [t.pedidoId, t.numLinea] }),
    index('lineas_producto_idx').on(t.productoId),
    check('lineas_cantidad_positiva', sql`${t.cantidad} > 0`),
    check('lineas_descuento_rango', sql`${t.descuento} BETWEEN 0 AND 100`),
  ],
)

export const proyectos = sqliteTable('proyectos', {
  proyectoId: integer('proyecto_id').primaryKey(),
  nombre: text('nombre').notNull(),
  deptId: integer('dept_id')
    .notNull()
    .references(() => departamentos.deptId, { onDelete: 'no action' }),
  fechaInicio: text('fecha_inicio').notNull(),
  fechaFin: text('fecha_fin'), // null: proyecto en curso
  presupuesto: real('presupuesto'), // null: sin presupuesto cerrado
})

export const asignaciones = sqliteTable(
  'asignaciones',
  {
    empId: integer('emp_id')
      .notNull()
      .references(() => empleados.empId, { onDelete: 'cascade' }),
    proyectoId: integer('proyecto_id')
      .notNull()
      .references(() => proyectos.proyectoId, { onDelete: 'cascade' }),
    fechaAsignacion: text('fecha_asignacion').notNull(),
    horas: integer('horas').notNull().default(0),
    funcion: text('funcion').notNull(),
  },
  (t) => [primaryKey({ columns: [t.empId, t.proyectoId] })],
)
3.8. Relaciones para las consultas relacionales
Las claves ajenas viven en la base de datos. Drizzle tiene además una API relacional (db.query, apartado 6.5) que permite pedir “un pedido con su cliente y sus líneas, y cada línea con su producto” sin escribir joins. Para eso necesita saber cómo se relacionan las tablas, y se lo dices con relations(). Estas declaraciones no crean nada en SQL: solo informan a Drizzle.
export const pedidosRelaciones = relations(pedidos, ({ one, many }) => ({
  cliente: one(clientes, {
    fields: [pedidos.clienteId],
    references: [clientes.clienteId],
  }),
  empleado: one(empleados, {
    fields: [pedidos.empleadoId],
    references: [empleados.empId],
  }),
  lineas: many(lineasPedido),
}))

export const lineasPedidoRelaciones = relations(lineasPedido, ({ one }) => ({
  pedido: one(pedidos, {
    fields: [lineasPedido.pedidoId],
    references: [pedidos.pedidoId],
  }),
  producto: one(productos, {
    fields: [lineasPedido.productoId],
    references: [productos.productoId],
  }),
}))
one(tabla, { fields, references })se declara en el lado que tiene la clave ajena: cada pedido tiene un cliente.many(tabla)se declara en el otro lado: cada pedido tiene muchas líneas. Drizzle encuentra la clave ajena mirando elonecorrespondiente en la otra tabla.
En las autorreferencias hay dos relaciones entre la misma pareja de tablas, y Drizzle no sabría emparejarlas. Se desambiguan con un relationName común:
export const empleadosRelaciones = relations(empleados, ({ one, many }) => ({
  departamento: one(departamentos, {
    fields: [empleados.deptId],
    references: [departamentos.deptId],
  }),
  jefe: one(empleados, {
    fields: [empleados.jefeId],
    references: [empleados.empId],
    relationName: 'jefe_subordinados',
  }),
  subordinados: many(empleados, { relationName: 'jefe_subordinados' }),
  clientes: many(clientes),
  pedidos: many(pedidos),
  asignaciones: many(asignaciones),
}))
El fichero del zip declara las relaciones de las nueve tablas con el mismo patrón (departamentosRelaciones, clientesRelaciones, categoriasRelaciones con padre e hijas, productosRelaciones, proyectosRelaciones y asignacionesRelaciones).
📘 Concepto: Cuando se escribe este curso, la versión
latestdedrizzle-ormen npm es la 0.45.4, y Drizzle 1.0 está en fase beta (1.0.0-beta.22, etiquetabeta) con una nueva versión de la API relacional. El curso usa la estable, conrelations(), que es la que verás en la mayoría de proyectos actuales. Cuando salga la 1.0, revisa su guía de migración.
3.9. Tipos que salen del esquema
Cada tabla expone dos tipos:
export type Departamento = typeof departamentos.$inferSelect
export type NuevoDepartamento = typeof departamentos.$inferInsert
$inferSelect: lo que devuelve unselectde la tabla completa. Todas las columnas, con| nullen las que lo admiten.$inferInsert: lo que acepta uninsert. Las columnas connotNull()y sin valor por defecto son obligatorias; las demás, opcionales.
Para departamentos, los tipos quedan así (lo que muestra el editor al pasar el ratón por encima):
type Departamento = {
  deptId: number
  nombre: string
  localidad: string
  presupuesto: number | null
}

type NuevoDepartamento = {
  deptId?: number | undefined          // lo asigna SQLite si no lo das
  nombre: string
  localidad: string
  presupuesto?: number | null | undefined
}
No escribes estos tipos a mano en ningún sitio. Si mañana añades una columna al esquema, aparecen solos en cada consulta y en cada formulario que use NuevoDepartamento.
4. Migraciones con drizzle-kit
Una migración es un fichero SQL que lleva la base de datos de una versión del esquema a la siguiente. Escribes el esquema en TypeScript; drizzle-kit compara ese esquema con el anterior y escribe el SQL de la diferencia.
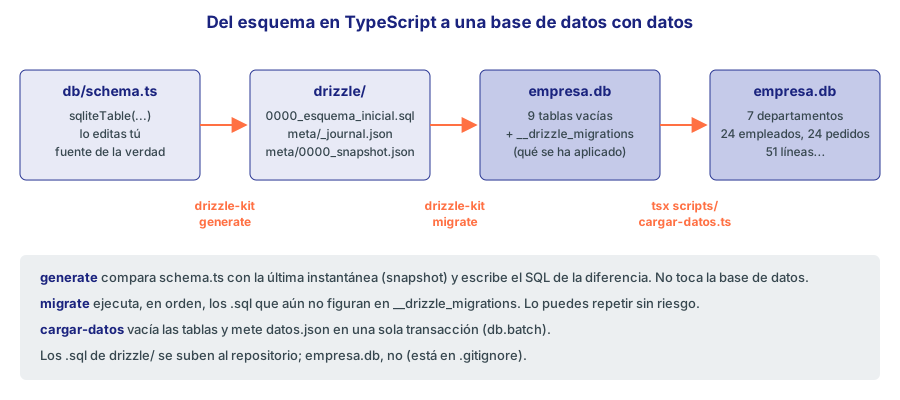
Figura 2. Las tres órdenes: generate escribe SQL, migrate lo aplica, y el script de carga mete los datos.
4.1. drizzle.config.ts
import { defineConfig } from 'drizzle-kit'

export default defineConfig({
  dialect: 'sqlite',
  schema: './db/schema.ts',
  out: './drizzle',
  dbCredentials: {
    url: process.env.DATABASE_URL ?? 'file:empresa.db',
  },
  strict: true,
  verbose: true,
})
| Opción | Significado |
|---|---|
dialect | El tipo de base de datos: 'sqlite', 'turso', 'postgresql', 'mysql'… Para un fichero local, 'sqlite'; drizzle-kit usa el driver @libsql/client que tienes instalado. Para una base de datos remota de Turso se usa 'turso' con authToken (módulo 23) |
schema | Dónde está el esquema |
out | Carpeta de las migraciones |
dbCredentials.url | La base de datos sobre la que actúan migrate, push y studio |
strict | Pide confirmación antes de sentencias que pueden perder datos (en push) |
verbose | Muestra el SQL que ejecuta (en push) |
4.2. generate: del esquema al SQL
npx drizzle-kit generate --name esquema_inicial
Salida real:
No config path provided, using default 'drizzle.config.ts'
Reading config file 'C:\...\empresa-db\drizzle.config.ts'
9 tables
asignaciones 5 columns 0 indexes 2 fks
categorias 3 columns 0 indexes 1 fks
clientes 10 columns 2 indexes 1 fks
departamentos 4 columns 1 indexes 0 fks
empleados 11 columns 3 indexes 2 fks
lineas_pedido 6 columns 1 indexes 2 fks
pedidos 6 columns 2 indexes 2 fks
productos 8 columns 1 indexes 1 fks
proyectos 6 columns 0 indexes 1 fks

[✓] Your SQL migration file ➜ drizzle\0000_esquema_inicial.sql 🚀
(Los recuentos de índices incluyen los únicos: departamentos tiene uno, el de nombre.) Sin --name, drizzle-kit inventa un nombre aleatorio como 0000_brave_hulk.sql; ponerle uno descriptivo ayuda a leer el historial. Este es un fragmento del fichero generado:
CREATE TABLE `departamentos` (
	`dept_id` integer PRIMARY KEY NOT NULL,
	`nombre` text NOT NULL,
	`localidad` text NOT NULL,
	`presupuesto` real
);
--> statement-breakpoint
CREATE UNIQUE INDEX `departamentos_nombre_unique` ON `departamentos` (`nombre`);--> statement-breakpoint
CREATE TABLE `empleados` (
	`emp_id` integer PRIMARY KEY NOT NULL,
	`nombre` text NOT NULL,
	`apellidos` text NOT NULL,
	`email` text NOT NULL,
	`telefono` text,
	`fecha_alta` text NOT NULL,
	`oficio` text NOT NULL,
	`salario` real NOT NULL,
	`comision` real,
	`jefe_id` integer,
	`dept_id` integer,
	FOREIGN KEY (`jefe_id`) REFERENCES `empleados`(`emp_id`) ON UPDATE no action ON DELETE set null,
	FOREIGN KEY (`dept_id`) REFERENCES `departamentos`(`dept_id`) ON UPDATE no action ON DELETE no action,
	CONSTRAINT "empleados_salario_positivo" CHECK("empleados"."salario" > 0),
	CONSTRAINT "empleados_comision_no_negativa" CHECK("empleados"."comision" >= 0)
);
Observa varias cosas:
- Las tablas aparecen en orden alfabético, así que
asignacionesse crea antes queempleados, a la que referencia. En SQLite no importa: la clave ajena se comprueba al escribir datos, no al crear la tabla. --> statement-breakpointsepara las sentencias. El driver de libSQL ejecuta una sentencia cada vez, ymigrateusa esas marcas para trocear el fichero.unique()se convierte en un índice único con nombre automático (departamentos_nombre_unique).- La restricción
CHECK("empleados"."comision" >= 0)admiteNULL: en SQL, una comparación conNULLda “desconocido”, yCHECKsolo rechaza lo que da “falso”. Por eso los veinte empleados sin comisión pasan la restricción.
Además del .sql, generate crea la carpeta drizzle/meta/:
_journal.json: la lista ordenada de migraciones (0000_esquema_inicial,0001_...).0000_snapshot.json: una foto completa del esquema tras esa migración. La próxima vez que ejecutesgenerate,drizzle-kitcompararáschema.tscon esta foto, no con la base de datos.
Si ejecutas generate sin haber cambiado el esquema:
No schema changes, nothing to migrate 😴
4.3. migrate: del SQL a la base de datos
npx drizzle-kit migrate
No config path provided, using default 'drizzle.config.ts'
Reading config file 'C:\...\empresa-db\drizzle.config.ts'
[✓] migrations applied successfully!
Si empresa.db no existe, se crea. migrate ejecuta las migraciones de drizzle/ que todavía no se han aplicado y apunta cada una en una tabla interna, __drizzle_migrations, con un hash del fichero y la fecha. Esto es lo que contiene después de la primera migración:
[
  {
    id: null,
    hash: 'd3b8cee0779c7e96d335d0ff12a9d877c3cb0aa2f7a6bd1e5039ce2be1adc010',
    created_at: 1793623119964
  }
]
Por eso puedes ejecutar migrate tantas veces como quieras: la segunda vez no queda nada pendiente, no cambia nada y muestra el mismo mensaje de éxito.
4.4. Evolucionar el esquema: la segunda migración
Supón que la empresa quiere poder dar de baja a un cliente sin borrarlo. Añades una columna al esquema:
export const clientes = sqliteTable(
  'clientes',
  {
    // ... columnas anteriores
    limiteCredito: real('limite_credito').notNull().default(0),
    activo: integer('activo', { mode: 'boolean' }).notNull().default(true),
    comercialId: integer('comercial_id').references(() => empleados.empId, {
      onDelete: 'set null',
    }),
  },
  // ...
)
Y repites las dos órdenes:
npx drizzle-kit generate --name clientes_activo
npx drizzle-kit migrate
generate compara con 0000_snapshot.json y escribe solo la diferencia, en drizzle/0001_clientes_activo.sql:
ALTER TABLE `clientes` ADD `activo` integer DEFAULT true NOT NULL;
migrate ve que 0000 ya está aplicada y ejecuta solo 0001. Las filas que ya existían reciben el valor por defecto (activo vale 1 en los 14 clientes), y __drizzle_migrations pasa a tener 2 filas. No has perdido ningún dato: esa es la ventaja de migrar frente a borrar y volver a crear la base de datos.
💡 Consejo: Fíjate en el
DEFAULT. Si añades una columnanotNull()sin valor por defecto a una tabla con filas, SQLite no sabe qué poner en las filas existentes y la migración falla. Cuando añadas una columna obligatoria a una tabla con datos, dale undefault()o añádela primero como opcional, rellénala y hazla obligatoria en una segunda migración.
4.5. Reglas de oro de las migraciones
- Los ficheros de
drizzle/se suben al repositorio, junto conmeta/. Son la historia de tu base de datos. Tus compañeros y el servidor de producción ejecutarán exactamente esas sentencias. - No edites una migración ya aplicada. Si alguien ya la ejecutó, su base de datos no volverá a aplicarla, y la tuya y la suya quedarán distintas. Si te has equivocado, genera una migración nueva que lo corrija.
- No borres a mano ficheros de
drizzle/ni entradas de_journal.json. Si el esquema todavía no se ha compartido con nadie y quieres empezar de cero, borra la carpetadrizzle/entera yempresa.db, y vuelve a generar. generateno toca la base de datos;migrateno mira el esquema. Si cambiasschema.tsy ejecutas solomigrate, no pasa nada, porque no hay ficheros nuevos.
drizzle-kit tiene más órdenes (drizzle-kit --help las lista): push aplica el esquema directamente a la base de datos sin crear ficheros de migración, cómodo para prototipos pero sin historial; studio abre un explorador web de la base de datos; introspect hace el camino inverso, generando schema.ts a partir de una base de datos que ya existe. En este curso se trabaja siempre con generate y migrate.
5. Cargar los datos de datos.json
Con las tablas creadas, toca llenarlas. El script scripts/cargar-datos.ts del zip lee datos.json y lo inserta con Drizzle.
5.1. El script completo
// Carga datos.json en la base de datos. Se puede ejecutar tantas veces como
// quieras: vacía las tablas y las vuelve a llenar en una sola transacción.
//
//   npm run db:cargar
//
import { createClient } from '@libsql/client'
import { count } from 'drizzle-orm'
import { drizzle } from 'drizzle-orm/libsql'
import datos from '../datos.json'
import * as schema from '../db/schema'

const {
  asignaciones,
  categorias,
  clientes,
  departamentos,
  empleados,
  lineasPedido,
  pedidos,
  productos,
  proyectos,
} = schema

const url = process.env.DATABASE_URL ?? 'file:empresa.db'
const cliente = createClient({ url })
const db = drizzle(cliente, { schema })

async function cargar() {
  console.log(`Cargando datos en ${url}`)

  // db.batch ejecuta todas las sentencias en UNA transacción:
  // si falla una, no se aplica ninguna.
  await db.batch([
    // 1. Vaciar, de las tablas hijas a las padres
    db.delete(lineasPedido),
    db.delete(asignaciones),
    db.delete(pedidos),
    db.delete(proyectos),
    db.delete(productos),
    db.delete(categorias),
    db.delete(clientes),
    db.delete(empleados),
    db.delete(departamentos),

    // 2. Insertar, de las tablas padres a las hijas
    db.insert(departamentos).values(datos.departamentos),
    db.insert(empleados).values(datos.empleados),
    db.insert(clientes).values(datos.clientes),
    db.insert(categorias).values(datos.categorias),
    db.insert(productos).values(datos.productos),
    db.insert(pedidos).values(
      datos.pedidos.map((p) => ({ ...p, estado: p.estado as schema.EstadoPedido })),
    ),
    db.insert(lineasPedido).values(datos.lineasPedido),
    db.insert(proyectos).values(datos.proyectos),
    db.insert(asignaciones).values(datos.asignaciones),
  ])

  const tablas = {
    departamentos,
    empleados,
    clientes,
    categorias,
    productos,
    pedidos,
    lineasPedido,
    proyectos,
    asignaciones,
  }
  for (const [nombre, tabla] of Object.entries(tablas)) {
    const [{ filas }] = await db.select({ filas: count() }).from(tabla)
    console.log(`  ${nombre.padEnd(14)} ${String(filas).padStart(3)} filas`)
  }
}

cargar()
  .then(() => console.log('Carga terminada.'))
  .catch((error) => {
    console.error('La carga ha fallado; no se ha modificado nada.')
    console.error(error)
    process.exitCode = 1
  })
  .finally(() => cliente.close())
Salida real de npm run db:cargar:
Cargando datos en file:empresa.db
  departamentos    7 filas
  empleados       24 filas
  clientes        14 filas
  categorias      11 filas
  productos       20 filas
  pedidos         24 filas
  lineasPedido    51 filas
  proyectos        5 filas
  asignaciones    14 filas
Carga terminada.
5.2. Cómo funciona
Crear la conexión. Fuera de Next, el script crea su propio cliente con createClient({ url }) y se lo pasa a drizzle(), junto con el esquema. No puede reutilizar lib/db (apartado 8) porque ese módulo importa server-only, que solo funciona dentro de Next.
Importar el JSON. import datos from '../datos.json' funciona gracias a la opción resolveJsonModule de tsconfig.json (la plantilla de Next ya la trae). TypeScript deduce el tipo de cada colección a partir del contenido del fichero, y Drizzle lo compara con el $inferInsert de cada tabla. Si datos.json tuviera una propiedad con un nombre que no existe en el esquema, o un null en una columna notNull(), el script no compilaría.
El caso del estado. TypeScript deduce estado: string del JSON, pero la columna espera la unión 'PENDIENTE' | 'ENVIADO' | .... Por eso se convierte con as schema.EstadoPedido. Es seguro porque la restricción CHECK de la tabla rechazaría cualquier valor que no sea uno de los cuatro.
Los nulos pasan tal cual. El null de comision en el JSON se guarda como NULL en SQLite y vuelve como null al leerlo. Nada que hacer: por eso el esquema permite nulos exactamente en esas columnas.
db.batch([...]) hace todo en una transacción. Recibe una lista de consultas sin await (Drizzle construye la consulta pero no la ejecuta hasta que alguien la espera) y las envía juntas. Si cualquiera falla, SQLite deshace todas: o se carga todo, o no cambia nada. Sin batch, un fallo en la séptima inserción dejaría la base de datos vacía a medias.
El orden importa. Se borra de hijas a padres (las líneas antes que los pedidos) y se inserta de padres a hijas (los departamentos antes que los empleados). Las claves ajenas se comprueban en cada sentencia, y una línea de pedido no puede existir sin su pedido. Dentro de una misma tabla no importa: insert into empleados mete las 24 filas en una sola sentencia, y la comprobación del jefe se hace al final (por eso es importante el no action del apartado 3.4).
Es repetible. Como primero vacía, puedes ejecutar npm run db:cargar cuantas veces quieras para volver a los datos originales. Lo agradecerás después de probar formularios que borran o modifican datos.
⚠️ Importante: El script usa una función
cargar()y.then()en lugar deawaiten el nivel superior del fichero. Es intencionado: elpackage.jsonde Next no declara"type": "module", así quetsxtrata los.tscomo CommonJS, y ahí no existe elawaitde nivel superior. Si lo usas, el error esTop-level await is currently not supported with the "cjs" output format. Alternativas: envolver el código en una función, como aquí, o llamar al fichero.mts.
5.3. Comprobar la carga
El zip incluye scripts/comprobar.ts, que hace cuatro consultas de control. Salida real de npm run db:comprobar:
Claves ajenas activas: sí
┌─────────┬────────┬─────────────────┬───────────┐
│ (index) │ deptId │ nombre          │ empleados │
├─────────┼────────┼─────────────────┼───────────┤
│ 0       │ 10     │ 'DIRECCIÓN'     │ 1         │
│ 1       │ 20     │ 'VENTAS'        │ 6         │
│ 2       │ 30     │ 'INFORMÁTICA'   │ 6         │
│ 3       │ 40     │ 'CONTABILIDAD'  │ 3         │
│ 4       │ 50     │ 'MARKETING'     │ 3         │
│ 5       │ 60     │ 'LOGÍSTICA'     │ 4         │
│ 6       │ 70     │ 'INVESTIGACIÓN' │ 0         │
└─────────┴────────┴─────────────────┴───────────┘
Empleados sin departamento: [ { empId: 160, nombre: 'Tomás' } ]
Pedidos sin fecha de envío: 4
Versión de SQLite: 3.45.1
La suma de la columna empleados es 23, no 24: Tomás no está en ningún departamento. Y el departamento 70 aparece con 0 empleados gracias a un leftJoin, que verás en el apartado 6.3.
5.4. Todo de una vez
El script db:preparar encadena migración y carga:
npm run db:preparar
Es lo único que necesita hacer alguien que clona tu repositorio: npm install, npm run db:preparar y npm run dev.
6. Consultas con Drizzle
Los ejemplos de este apartado se han ejecutado con tsx contra la base de datos recién cargada, con el mismo cliente que el script de carga. En Next escribirás las mismas consultas dentro de lib/db (apartado 8).
6.1. select, where y el SQL que se genera
import { and, desc, eq, gt } from 'drizzle-orm'
import { empleados } from '@/db/schema'

const consulta = db
  .select({ nombre: empleados.nombre, salario: empleados.salario })
  .from(empleados)
  .where(and(eq(empleados.deptId, 20), gt(empleados.salario, 2000)))
  .orderBy(desc(empleados.salario))
  .limit(3)

console.log(consulta.toSQL())
console.log(await consulta)
{
  sql: 'select "nombre", "salario" from "empleados" where ("empleados"."dept_id" = ? and "empleados"."salario" > ?) order by "empleados"."salario" desc limit ?',
  params: [20, 2000, 3]
}
[ { nombre: 'Luis', salario: 4800 }, { nombre: 'Elena', salario: 2300 }, { nombre: 'Carmen', salario: 2200 } ]
Tres cosas que ver:
select({...})elige columnas y da forma al resultado. Las claves del objeto son las propiedades de cada fila. Conselect()sin argumentos obtienes todas las columnas de la tabla.- Los valores van como parámetros (
?), nunca pegados en el texto del SQL. Esto es lo que te protege de la inyección SQL (apartado 6.9). - Una consulta de Drizzle es una “promesa perezosa”: no se ejecuta hasta que haces
await(o.then()). Por eso puedes construirla, inspeccionarla contoSQL()y ejecutarla después.
Los operadores de filtro se importan de drizzle-orm:
| Operador | SQL | Ejemplo |
|---|---|---|
eq, ne | =, <> | eq(pedidos.estado, 'PENDIENTE') |
gt, gte, lt, lte | >, >=, <, <= | lt(productos.stock, 10) |
and, or, not | and, or, not | and(eq(...), gt(...)) |
isNull, isNotNull | is null, is not null | isNull(pedidos.fechaEnvio) |
inArray, notInArray | in (...) | inArray(productos.categoriaId, [2, 3]) |
like, notLike | like | like(empleados.apellidos, 'G%') |
between | between ... and ... | between(empleados.salario, 2000, 3000) |
⚠️ Importante: Para buscar nulos usa
isNull, nuncaeq(columna, null). En SQL,columna = NULLno es verdadero para ninguna fila, ni siquiera para las que tienenNULL. Es el mismo motivo por el que la restricciónCHECKdel apartado 4.2 deja pasar los nulos.
Dos ejemplos reales con nulos:
// Pedidos sin empleado asignado o cancelados
await db
  .select({ id: pedidos.pedidoId, e: pedidos.estado })
  .from(pedidos)
  .where(or(isNull(pedidos.empleadoId), eq(pedidos.estado, 'CANCELADO')))
// [{"id":5008,"e":"CANCELADO"},{"id":5014,"e":"ENTREGADO"},{"id":5023,"e":"PENDIENTE"}]

// Empleados que cobran comisión (aunque sea 0)
await db
  .select({ n: empleados.nombre, c: empleados.comision })
  .from(empleados)
  .where(isNotNull(empleados.comision))
// [{"n":"Carmen","c":500},{"n":"David","c":800},{"n":"Elena","c":300},{"n":"Sergio","c":0}]
Sergio aparece con su comisión 0. Si la carga hubiera convertido los null en 0, esta consulta devolvería los 24 empleados.
6.2. Ordenar y paginar
const porPagina = 5
const pagina = 2

const [{ total }] = await db.select({ total: count() }).from(productos)
const filas = await db
  .select({ id: productos.productoId })
  .from(productos)
  .orderBy(productos.productoId)
  .limit(porPagina)
  .offset((pagina - 1) * porPagina)
// { total: 20, filas: [{id:6},{id:7},{id:8},{id:9},{id:10}] }
limit y offset son la paginación clásica. Necesitas siempre un orderBy: sin él, SQL no garantiza el orden y una fila podría aparecer en dos páginas. count() devuelve el total, para calcular cuántas páginas hay.
Como las fechas son texto ISO, se ordenan sin conversión:
await db.select({ n: empleados.nombre, f: empleados.fechaAlta })
  .from(empleados).orderBy(desc(empleados.fechaAlta)).limit(2)
// [{"n":"Tomás","f":"2025-09-01"},{"n":"Jorge","f":"2023-01-09"}]

await db.select({ n: count() }).from(empleados).where(gt(empleados.fechaAlta, '2020-01-01'))
// [{"n":8}]
6.3. Joins: innerJoin frente a leftJoin
const conInner = await db
  .select({ n: empleados.nombre })
  .from(empleados)
  .innerJoin(departamentos, eq(empleados.deptId, departamentos.deptId))

const conLeft = await db
  .select({ n: empleados.nombre, d: departamentos.nombre })
  .from(empleados)
  .leftJoin(departamentos, eq(empleados.deptId, departamentos.deptId))

// conInner.length → 23
// conLeft.length  → 24, y Tomás aparece como { n: 'Tomás', d: null }
innerJoin solo devuelve las filas que tienen pareja en las dos tablas: Tomás, sin departamento, desaparece. leftJoin conserva todas las filas de la tabla de la izquierda y rellena con null las columnas de la derecha. Drizzle lo refleja en los tipos: en conLeft, d es string | null, aunque departamentos.nombre sea notNull(), porque el join puede no encontrar pareja.
Si haces un join con select() sin argumentos, el resultado se agrupa por tabla:
await db.select().from(empleados)
  .leftJoin(departamentos, eq(empleados.deptId, departamentos.deptId))
  .where(eq(empleados.empId, 160))
[{"empleados":{"empId":160,"nombre":"Tomás","apellidos":"Reyes Fuentes","email":"tomas.reyes@empresa.es",
"telefono":null,"fechaAlta":"2025-09-01","oficio":"BECARIO","salario":900,"comision":null,"jefeId":102,
"deptId":null},"departamentos":null}]
6.4. Agregados y la trampa de los números como texto
import { avg, sum } from 'drizzle-orm'

await db
  .select({ d: departamentos.nombre, medio: avg(empleados.salario), total: sum(empleados.salario) })
  .from(departamentos)
  .leftJoin(empleados, eq(empleados.deptId, departamentos.deptId))
  .groupBy(departamentos.deptId)
  .orderBy(asc(departamentos.deptId))
[{"d":"DIRECCIÓN","medio":"6500","total":"6500"},{"d":"VENTAS","medio":"2500","total":"15000"},
{"d":"INFORMÁTICA","medio":"3133.3333333333335","total":"18800"}, ...,
{"d":"INVESTIGACIÓN","medio":null,"total":null}]
Fíjate en las comillas: avg y sum devuelven cadenas ("6500"), y su tipo en TypeScript es string | null. Drizzle lo hace así a propósito, porque en otras bases de datos una suma puede superar la precisión de un number de JavaScript. Si sumas esos valores con +, concatenarás texto. Cuando sepas que el resultado cabe en un number, conviértelo en la propia consulta con .mapWith(Number):
total: sum(empleados.salario).mapWith(Number) // 15000, tipo number
count(), en cambio, ya devuelve number. Y el departamento 70 tiene null en la media y la suma: no hay empleados que sumar. Si prefieres un 0, usa coalesce (apartado 6.5).
6.5. SQL a medida con sql
Cuando Drizzle no tiene una función para lo que necesitas, escribes el fragmento de SQL con la plantilla sql. El importe de una línea de pedido aplica el descuento, que está en porcentaje:
import { sql } from 'drizzle-orm'

const importeLinea = sql<number>`${lineasPedido.cantidad} * ${lineasPedido.precioUnitario} * (1 - ${lineasPedido.descuento} / 100.0)`

await db
  .select({
    pedidoId: pedidos.pedidoId,
    total: sql<number>`round(sum(${importeLinea}), 2)`.mapWith(Number).as('total'),
  })
  .from(pedidos)
  .innerJoin(lineasPedido, eq(lineasPedido.pedidoId, pedidos.pedidoId))
  .groupBy(pedidos.pedidoId)
  .orderBy(desc(sql`total`))
  .limit(3)
// [{"pedidoId":5010,"total":11657.5},{"pedidoId":5016,"total":8945.05},{"pedidoId":5002,"total":7402.5}]
- Las columnas que interpolas con
${...}se convierten en su nombre SQL ("lineas_pedido"."cantidad"); los valores de JavaScript, en parámetros?. sql<number>declara el tipo que tendrá el resultado en TypeScript. Es una promesa tuya, no una conversión: si además quieres convertir, añade.mapWith(Number)..as('total')da nombre a la expresión para poder ordenarla.100.0, y no100: en SQLite,5 / 100es una división entera y da 0.
6.6. Consultas relacionales con db.query
Con las relaciones del apartado 3.8 y el esquema pasado a drizzle(cliente, { schema }), tienes una segunda forma de consultar, pensada para leer datos anidados:
const pedido = await db.query.pedidos.findFirst({
  where: eq(pedidos.pedidoId, 5001),
  columns: { pedidoId: true, estado: true },
  with: {
    cliente: { columns: { nombre: true } },
    lineas: {
      columns: { cantidad: true },
      with: { producto: { columns: { nombre: true } } },
    },
  },
})
{"pedidoId":5001,"estado":"ENTREGADO","cliente":{"nombre":"Talleres Martín S.L."},
 "lineas":[{"cantidad":1,"producto":{"nombre":"Portátil Gaming 16"}},
           {"cantidad":2,"producto":{"nombre":"Ratón inalámbrico"}},
           {"cantidad":2,"producto":{"nombre":"Monitor 24 FHD"}}]}
Las autorreferencias funcionan igual:
await db.query.empleados.findFirst({
  where: eq(empleados.empId, 100),
  columns: { nombre: true },
  with: { subordinados: { columns: { nombre: true } } },
})
// {"nombre":"Ana","subordinados":[{"nombre":"Luis"},{"nombre":"Marta"},{"nombre":"Pedro"},{"nombre":"Laura"},{"nombre":"Javier"}]}

await db.query.categorias.findMany({
  where: isNull(categorias.categoriaPadreId),
  columns: { nombre: true },
  with: { hijas: { columns: { nombre: true } } },
})
// [{"nombre":"Informática","hijas":[{"nombre":"Portátiles"},{"nombre":"Ordenadores sobremesa"},{"nombre":"Periféricos"}]},
//  {"nombre":"Electrónica","hijas":[{"nombre":"Telefonía"},{"nombre":"Audio"}]},
//  {"nombre":"Oficina","hijas":[{"nombre":"Mobiliario"}]}]
¿Cuándo usar cada API?
| Necesitas | Usa |
|---|---|
| Una entidad con sus hijas anidadas (ficha de pedido, departamento con empleados) | db.query...findFirst / findMany con with |
Listados planos, agregados, groupBy, totales | db.select() con joins |
| Algo muy específico | db.select() con fragmentos sql |
⚠️ Importante: Si creas el cliente con
drizzle(cliente), sin{ schema },db.queryexiste pero está vacío:Object.keys(db.query)devuelve[]ydb.query.pedidosesundefined. TypeScript te avisa con un mensaje bastante claro:Property 'pedidos' does not exist on type 'DrizzleTypeError<"Seems like the schema generic is missing - did you forget to add it to your DB type?">'. Pásale siempre el esquema completo (import * as schema), que incluye tablas y relaciones.
6.7. Insertar, actualizar y borrar
Las tres operaciones admiten .returning(), que devuelve las filas afectadas tal como quedan en la base de datos:
await db.insert(departamentos).values({ nombre: 'CALIDAD', localidad: 'Bilbao' }).returning()
// [{"deptId":71,"nombre":"CALIDAD","localidad":"Bilbao","presupuesto":null}]

await db.update(departamentos).set({ presupuesto: 90000 })
  .where(eq(departamentos.nombre, 'CALIDAD'))
  .returning({ id: departamentos.deptId, p: departamentos.presupuesto })
// [{"id":71,"p":90000}]

await db.delete(departamentos).where(eq(departamentos.nombre, 'CALIDAD'))
  .returning({ id: departamentos.deptId })
// [{"id":71}]
- En el
insertno se dadeptId: SQLite asigna el siguiente (71). Tampocopresupuesto, que queda ennull. returning()sin argumentos devuelve todas las columnas; con un objeto, solo las que pidas.- Si la operación no afecta a ninguna fila (por ejemplo, un
whereque no encuentra nada),returning()devuelve[]. Así sabes si el registro existía.
Sin returning(), el resultado de libSQL trae rowsAffected:
const r = await db.update(productos).set({ stock: sql`${productos.stock}` })
r.rowsAffected // 20
⚠️ Importante: Ese
updateno tienewherey ha tocado las 20 filas de la tabla. Aquí no pasa nada, porque asigna a cada producto su propio stock, pero undb.delete(productos)sinwhereborra toda la tabla sin preguntar. Drizzle no te protege de eso. Revisa cadaupdateydeletebuscando suwhere.
6.8. Transacciones
Una transacción agrupa varias operaciones para que se apliquen todas o ninguna. Con db.transaction, si la función lanza una excepción, todo lo que hizo dentro se deshace:
try {
  await db.transaction(async (tx) => {
    await tx.update(productos).set({ stock: 0 }).where(eq(productos.productoId, 1))
    tx.rollback() // deshace y lanza TransactionRollbackError
  })
} catch (e) {
  console.log(e.constructor.name, e.message) // TransactionRollbackError Rollback
}
// El stock del producto 1 sigue siendo 25
Dentro de la transacción usa siempre tx, no db: lo que hagas con db va por fuera de la transacción.
Una transacción también te deja ver el efecto de una operación antes de confirmarla. Este ejemplo borra a Pedro (102), jefe de Tomás, y comprueba que el onDelete: 'set null' ha funcionado, antes de deshacerlo todo:
await db.transaction(async (tx) => {
  await tx.delete(empleados).where(eq(empleados.empId, 102))
  const tomas = await tx.select({ id: empleados.empId, j: empleados.jefeId })
    .from(empleados).where(eq(empleados.empId, 160))
  console.log(tomas) // [{"id":160,"j":null}]
  tx.rollback()
})
| Herramienta | Cuándo |
|---|---|
db.batch([...]) | Sabes de antemano todas las sentencias y no dependen de resultados intermedios (el script de carga) |
db.transaction(async (tx) => ...) | Necesitas el resultado de una sentencia para decidir la siguiente (crear un pedido y usar su pedidoId en las líneas, ejercicio 5) |
6.9. Inyección SQL: sql frente a sql.raw
Imagina un buscador que recibe el texto del usuario. Con la plantilla sql, el texto va como parámetro:
const texto = "' OR 1=1 --"
await db.select({ n: empleados.nombre }).from(empleados)
  .where(sql`${empleados.nombre} = ${texto}`)
// 0 filas. SQL: ... where "empleados"."nombre" = ?   params: ["' OR 1=1 --"]
Con sql.raw, el texto se pega tal cual dentro del SQL:
const texto = "x' OR 1=1 --"
await db.select({ n: empleados.nombre }).from(empleados)
  .where(sql.raw(`nombre = '${texto}'`))
// 24 filas: la condición quedó  nombre = 'x' OR 1=1 --'
El atacante ha cerrado la comilla, ha añadido una condición siempre verdadera y ha comentado el resto. Ha obtenido todos los empleados. Nunca pases datos del usuario a sql.raw, ni construyas SQL concatenando cadenas. Todas las funciones de Drizzle (eq, like, values, set…) y la plantilla sql normal usan parámetros. Volverás sobre esto en el módulo 22.
6.10. Consultas preparadas
Si una consulta se repite mucho con distintos valores, puedes prepararla una vez y ejecutarla con parámetros con nombre:
const porId = db
  .select({ n: empleados.nombre })
  .from(empleados)
  .where(eq(empleados.empId, sql.placeholder('id')))
  .prepare()

await porId.get({ id: 100 }) // { n: 'Ana' }
await porId.all({ id: 101 }) // [ { n: 'Luis' } ]
get devuelve la primera fila (o undefined); all, todas. Drizzle se ahorra construir el SQL en cada llamada. En una aplicación pequeña la diferencia es mínima; es útil en consultas que se ejecutan miles de veces.
7. Errores de la base de datos
Las restricciones del esquema solo son útiles si tu aplicación sabe qué hacer cuando saltan.
7.1. Cómo llega un error
Cuando SQLite rechaza una sentencia, Drizzle lanza un DrizzleQueryError con la consulta y sus parámetros. El error original del driver, un LibsqlError, va en su propiedad cause. Este es el error real al insertar un departamento con un nombre que ya existe:
DrizzleQueryError: Failed query: insert into "departamentos" ("dept_id", "nombre", "localidad", "presupuesto") values (null, ?, ?, null)
params: VENTAS,X
    at LibSQLPreparedQuery.queryWithCache (...\node_modules\src\sqlite-core\session.ts:80:11)
    ... {
  query: 'insert into "departamentos" ("dept_id", "nombre", "localidad", "presupuesto") values (null, ?, ?, null)',
  params: [ 'VENTAS', 'X' ],
  cause: LibsqlError: SQLITE_CONSTRAINT: UNIQUE constraint failed: departamentos.nombre
      at mapSqliteError (...\node_modules\@libsql\client\lib-cjs\sqlite3.js:678:16)
      ... {
    code: 'SQLITE_CONSTRAINT',
    extendedCode: 'SQLITE_CONSTRAINT_UNIQUE',
    rawCode: 2067,
code es la familia del error (SQLITE_CONSTRAINT), y extendedCode dice exactamente cuál. Estos son los mensajes reales de cada restricción del esquema EMPRESA:
| Qué se intentó | cause.message | extendedCode |
|---|---|---|
| Departamento con nombre repetido | UNIQUE constraint failed: departamentos.nombre | SQLITE_CONSTRAINT_UNIQUE |
Empleado con deptId: 99 (no existe) | FOREIGN KEY constraint failed | SQLITE_CONSTRAINT_FOREIGNKEY |
| Borrar el producto 2, que tiene ventas | FOREIGN KEY constraint failed | SQLITE_CONSTRAINT_FOREIGNKEY |
| Borrar el cliente 1001, que tiene pedidos | FOREIGN KEY constraint failed | SQLITE_CONSTRAINT_FOREIGNKEY |
Precio -5 | CHECK constraint failed: productos_precio_no_negativo | SQLITE_CONSTRAINT_CHECK |
Estado 'PERDIDO' | CHECK constraint failed: pedidos_estado_valido | SQLITE_CONSTRAINT_CHECK |
| Departamento sin localidad | NOT NULL constraint failed: departamentos.localidad | SQLITE_CONSTRAINT_NOTNULL |
| Consultar antes de migrar | no such table: productos | SQLITE_ERROR |
Fíjate en que el mensaje de clave ajena no dice qué clave falló. Es una limitación de SQLite. Por eso conviene que la Server Action compruebe antes lo que pueda (por ejemplo, que el departamento existe) y deje la restricción como última defensa.
7.2. Traducir el error para el usuario
Un usuario no debe ver SQLITE_CONSTRAINT_UNIQUE, pero tampoco un “Error inesperado” cuando el problema es que el nombre ya existe. Este módulo de lib/db hace la traducción:
// lib/db/errores.ts
import 'server-only'
import { LibsqlError } from '@libsql/client'

// Drizzle envuelve los fallos en DrizzleQueryError; el error de SQLite
// (LibsqlError) va en error.cause.
export function codigoSqlite(error: unknown): string | undefined {
  const causa = error instanceof Error ? error.cause : undefined
  if (causa instanceof LibsqlError) return causa.extendedCode ?? causa.code
  return undefined
}

export function mensajeDeError(error: unknown): string {
  switch (codigoSqlite(error)) {
    case 'SQLITE_CONSTRAINT_UNIQUE':
      return 'Ya existe un registro con ese valor.'
    case 'SQLITE_CONSTRAINT_FOREIGNKEY':
      return 'No se puede: hay otros datos que dependen de este registro.'
    case 'SQLITE_CONSTRAINT_CHECK':
      return 'Algún valor no cumple las reglas de la tabla.'
    case 'SQLITE_CONSTRAINT_NOTNULL':
      return 'Falta un dato obligatorio.'
    default:
      return 'Error inesperado en la base de datos.'
  }
}
La usarás en las Server Actions del apartado 10. El mensaje técnico completo se escribe en el registro del servidor con console.error, para que tú puedas depurarlo; al usuario solo le llega la frase.
⚠️ Importante: Durante el desarrollo de este módulo, con
onDelete: 'restrict'en las claves ajenas, borrar VENTAS mostraba “Error inesperado en la base de datos”: el código eraSQLITE_CONSTRAINT_TRIGGER, noSQLITE_CONSTRAINT_FOREIGNKEY. Tras cambiar ano action(apartado 3.4), el mismo borrado daSQLITE_CONSTRAINT_FOREIGNKEYy el mensaje correcto. Si usasrestrict, añade ese código alswitch.
8. La capa de acceso a datos (lib/db)
Ya sabes consultar. La pregunta ahora es desde dónde. Podrías escribir db.select()... directamente en cada página, y funcionaría. Pero la guía de seguridad de datos de Next (docs/01-app/02-guides/data-security.md en tu node_modules/next/dist/docs) recomienda para proyectos nuevos una capa de acceso a datos (Data Access Layer, DAL): una biblioteca interna que es el único sitio del proyecto que habla con la base de datos.
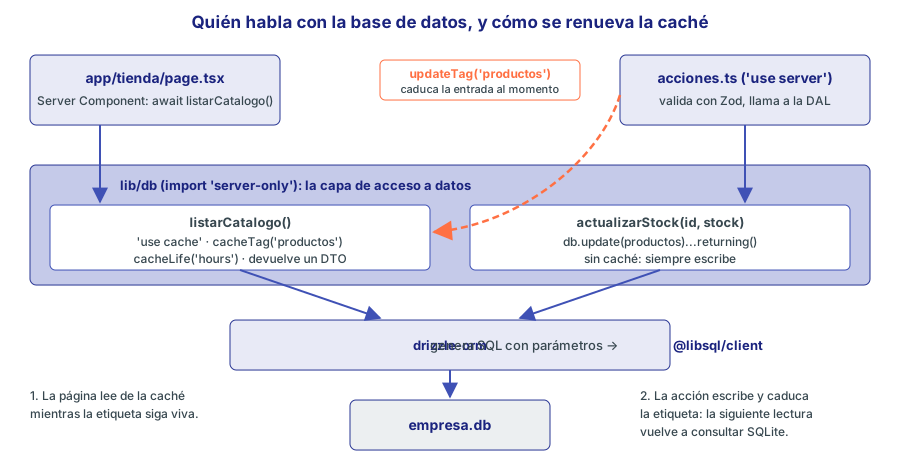
Figura 3. Las páginas leen y las acciones escriben, siempre a través de lib/db. La acción caduca la etiqueta de la caché para que la siguiente lectura vuelva a SQLite.
Las ventajas de concentrarlo todo en lib/db:
- Un solo sitio que revisar. Si mañana hay que comprobar permisos (módulo 17) o registrar cada escritura, se hace en un fichero, no en veinte páginas.
- Decides qué sale. Cada función devuelve un objeto pensado para su pantalla (un DTO, Data Transfer Object), no la fila entera. La tienda pública no necesita el email ni el salario de nadie.
- La caché vive junto a la consulta.
'use cache'y las etiquetas se ponen una vez, en la función, y todas las páginas que la usen se benefician. - Pruebas más fáciles. En el módulo 21 simularás este módulo para probar componentes sin base de datos.
8.1. El cliente: lib/db/index.ts
import 'server-only'
import { createClient, type Client } from '@libsql/client'
import { drizzle } from 'drizzle-orm/libsql'
import * as schema from '@/db/schema'

// En desarrollo, cada cambio de código vuelve a evaluar este módulo.
// Guardamos el cliente en globalThis para no abrir una conexión nueva cada vez.
const globalConDb = globalThis as typeof globalThis & { clienteEmpresa?: Client }

const cliente =
  globalConDb.clienteEmpresa ??
  createClient({ url: process.env.DATABASE_URL ?? 'file:empresa.db' })

if (process.env.NODE_ENV !== 'production') globalConDb.clienteEmpresa = cliente

export const db = drizzle(cliente, { schema })
export type BaseDeDatos = typeof db
import 'server-only'en la primera línea: si algún Client Component importa este módulo, directa o indirectamente, elbuildfalla (apartado 8.3).- Un único cliente para toda la aplicación. El módulo se evalúa una vez por proceso del servidor y todas las consultas comparten la conexión.
- El truco de
globalThis. Ennext dev, cuando guardas un fichero, Next vuelve a evaluar los módulos afectados. Sin este truco, cada guardado crearía un cliente nuevo y dejaría el anterior abierto. Las variables deglobalThissobreviven a esas recargas, así que se reutiliza el cliente. En producción no hay recargas y no hace falta. process.env.DATABASE_URLsolo se lee aquí. Como dice la guía de Next, solo la capa de datos debe tocar las variables con secretos (en una base de datos remota, el token de acceso).
8.2. Funciones de la capa: lectura y escritura
lib/db/catalogo.ts contiene todo lo que la tienda necesita:
import 'server-only'
import { and, asc, eq, sql } from 'drizzle-orm'
import { cacheLife, cacheTag } from 'next/cache'
import { db } from '.'
import { categorias, productos } from '@/db/schema'

// DTO: solo lo que la tienda pública necesita ver
export type ProductoCatalogo = {
  productoId: number
  nombre: string
  precio: number
  stock: number
  categoria: string
}

export async function listarCatalogo(): Promise<ProductoCatalogo[]> {
  'use cache'
  cacheTag('productos')
  cacheLife('hours')

  console.log(`[db] listarCatalogo ${new Date().toISOString()}`)
  return db
    .select({
      productoId: productos.productoId,
      nombre: productos.nombre,
      precio: productos.precio,
      stock: productos.stock,
      categoria: categorias.nombre,
    })
    .from(productos)
    .innerJoin(categorias, eq(productos.categoriaId, categorias.categoriaId))
    .where(eq(productos.descatalogado, false))
    .orderBy(asc(categorias.nombre), asc(productos.nombre))
}

export async function obtenerProducto(productoId: number) {
  'use cache'
  cacheTag('productos', `producto-${productoId}`)
  cacheLife('hours')

  const producto = await db.query.productos.findFirst({
    where: and(eq(productos.productoId, productoId), eq(productos.descatalogado, false)),
    columns: { productoId: true, nombre: true, descripcion: true, precio: true, stock: true },
    with: { categoria: { columns: { nombre: true }, with: { padre: { columns: { nombre: true } } } } },
  })
  return producto ?? null
}

export async function idsDeProductos() {
  return db
    .select({ id: sql<string>`cast(${productos.productoId} as text)` })
    .from(productos)
    .where(eq(productos.descatalogado, false))
}

// Mutación: la llama una Server Action, nunca un componente
export async function actualizarStock(productoId: number, stock: number) {
  const [fila] = await db
    .update(productos)
    .set({ stock })
    .where(eq(productos.productoId, productoId))
    .returning({ productoId: productos.productoId, stock: productos.stock })
  return fila ?? null
}
Las tres funciones de lectura seleccionan columnas concretas: nunca select() a secas. Es más eficiente y, sobre todo, evita filtrar datos por descuido: si mañana se añade a productos una columna precioCoste que la tienda no debe mostrar, estas funciones no la devolverán. La línea console.log('[db] ...') está ahí para que veas en la consola del servidor cuándo se consulta de verdad SQLite y cuándo se sirve de la caché (apartado 10.4); en tu proyecto puedes quitarla.
idsDeProductos sirve a generateStaticParams (apartado 9.3), que espera los parámetros como texto: el cast(... as text) hace la conversión en SQL. Un .map((p) => ({ id: String(p.productoId) })) en JavaScript sería igual de válido.
lib/db/departamentos.ts sigue el mismo patrón, con un leftJoin para contar empleados (incluido el departamento 70, con 0) y las funciones de alta y baja:
import 'server-only'
import { asc, count, eq } from 'drizzle-orm'
import { cacheLife, cacheTag } from 'next/cache'
import { db } from '.'
import { departamentos, empleados, type NuevoDepartamento } from '@/db/schema'

export async function listarDepartamentos() {
  'use cache'
  cacheTag('departamentos')
  cacheLife('days')

  console.log(`[db] listarDepartamentos ${new Date().toISOString()}`)
  return db
    .select({
      deptId: departamentos.deptId,
      nombre: departamentos.nombre,
      localidad: departamentos.localidad,
      presupuesto: departamentos.presupuesto,
      empleados: count(empleados.empId),
    })
    .from(departamentos)
    .leftJoin(empleados, eq(empleados.deptId, departamentos.deptId))
    .groupBy(departamentos.deptId)
    .orderBy(asc(departamentos.deptId))
}

export async function obtenerDepartamento(deptId: number) {
  'use cache'
  cacheTag('departamentos', `departamento-${deptId}`)
  cacheLife('days')

  const dept = await db.query.departamentos.findFirst({
    where: eq(departamentos.deptId, deptId),
    with: {
      empleados: {
        columns: { empId: true, nombre: true, apellidos: true, oficio: true },
        orderBy: [asc(empleados.apellidos)],
      },
    },
  })
  return dept ?? null
}

export async function crearDepartamento(datos: NuevoDepartamento) {
  const [nuevo] = await db.insert(departamentos).values(datos).returning()
  return nuevo
}

export async function eliminarDepartamento(deptId: number) {
  const borrados = await db
    .delete(departamentos)
    .where(eq(departamentos.deptId, deptId))
    .returning({ deptId: departamentos.deptId })
  return borrados.length > 0
}
count(empleados.empId) cuenta solo los valores no nulos de esa columna. En el departamento 70, el leftJoin produce una fila con empId nulo, y el resultado es 0. Con count() sin argumento contarías filas y el 70 saldría con 1.
💡 Consejo: Las funciones de escritura (
crearDepartamento,actualizarStock) no llevan'use cache'ni llaman aupdateTag. Renovar la caché es responsabilidad de la Server Action que las usa, porque solo ella sabe qué pantallas se ven afectadas. Así la capa de datos sirve igual para un script, una prueba o un Route Handler.
8.3. Lo que pasa si un Client Component importa lib/db
Para comprobar la protección, se creó un Client Component que importa listarCatalogo:
'use client'

import { listarCatalogo } from '@/lib/db/catalogo'

export function ListaCliente() {
  return <button onClick={() => listarCatalogo()}>Cargar</button>
}
El build falla con 8 errores. Estos son sus encabezados reales:
Error: Turbopack build failed with 8 errors:
./lib/db/catalogo.ts:17:3
Error: It is not allowed to define inline "use cache" annotated functions in Client Components.
./lib/db/catalogo.ts:37:3
Error: It is not allowed to define inline "use cache" annotated functions in Client Components.
./lib/db/catalogo.ts:3:10
Error: You're importing a module that depends on "cacheLife". This API is only available in Server Components in the App Router, but you are using it in the Pages Router.
./lib/db/catalogo.ts:3:21
Error: You're importing a module that depends on "cacheTag". This API is only available in Server Components in the App Router, but you are using it in the Pages Router.
./lib/db/catalogo.ts:1:1
Error: You're importing a module that depends on "server-only". This API is only available in Server Components in the App Router, but you are using it in the Pages Router.
./lib/db/index.ts:1:1
Error: You're importing a module that depends on "server-only". ...
./lib/db/catalogo.ts:1:1
Error: 'server-only' cannot be imported from a Client Component module
./lib/db/index.ts:1:1
Error: 'server-only' cannot be imported from a Client Component module
Cada error trae además la traza de importación (Import traces), que dice qué Client Component arrastró el módulo. La mención a “Pages Router” es engañosa: no estás usando Pages Router, es el mensaje genérico que Next da cuando una API de servidor acaba en el paquete del navegador. Lo que importa es la última línea: 'server-only' cannot be imported from a Client Component module.
Sin server-only, este error podría no aparecer y el código de la base de datos acabaría intentando empaquetarse para el navegador. Si un Client Component necesita datos, la solución es la de siempre (módulo 05): un Server Component los lee y se los pasa como props, o el cliente llama a una Server Action.
9. Consultas en Server Components y caché
9.1. Leer desde una página
Con la capa de datos hecha, una página solo tiene que llamar a la función:
// app/tienda/page.tsx
import Link from 'next/link'
import { listarCatalogo } from '@/lib/db/catalogo'
import { formatoEuros } from '@/lib/formato'

export const metadata = { title: 'Tienda' }

export default async function Tienda() {
  const productos = await listarCatalogo()

  return (
    <section>
      <h1 className="mb-4 text-2xl font-bold">Tienda ({productos.length} productos)</h1>
      <table className="w-full bg-white text-sm shadow">
        <thead className="bg-indigo-100 text-left">
          <tr><th className="p-2">Producto</th><th className="p-2">Categoría</th><th className="p-2 text-right">Precio</th><th className="p-2 text-right">Stock</th></tr>
        </thead>
        <tbody>
          {productos.map((p) => (
            <tr key={p.productoId} className="border-t">
              <td className="p-2"><Link className="text-indigo-800 underline" href={`/tienda/${p.productoId}`}>{p.nombre}</Link></td>
              <td className="p-2">{p.categoria}</td>
              <td className="p-2 text-right">{formatoEuros(p.precio)}</td>
              <td className="p-2 text-right">{p.stock === 0 ? 'Agotado' : p.stock}</td>
            </tr>
          ))}
        </tbody>
      </table>
    </section>
  )
}
Con un formateador de importes en lib/formato.ts, que también trata el presupuesto nulo:
const euros = new Intl.NumberFormat('es-ES', { style: 'currency', currency: 'EUR' })

export function formatoEuros(valor: number | null) {
  return valor === null ? 'Sin asignar' : euros.format(valor)
}
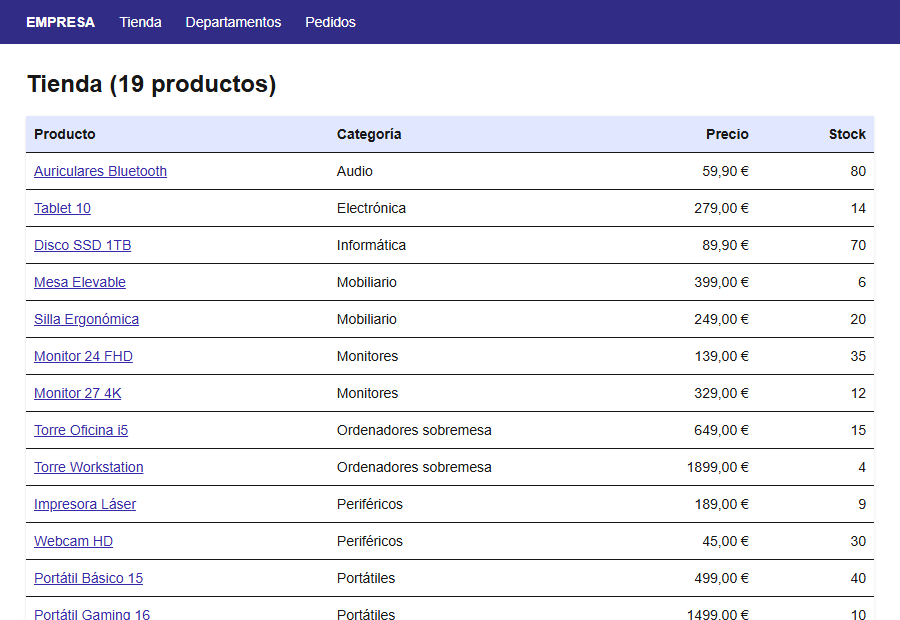
Figura 4. El catálogo leído de SQLite. Salen 19 productos y no 20: el que está descatalogado se filtra en la consulta. Los importes de cuatro cifras salen sin separador de miles (1899,00 €), que es la norma de es-ES.
9.2. Caché de consultas con 'use cache' 🆕 16.0
🆕 Desde Next.js 16.0.
'use cache',cacheTagycacheLifeson estables desde la 16; en Next.js 15 solo existen como experimento (experimental.useCache, conunstable_cacheTagyunstable_cacheLife). Si usas Next.js 15: envuelve la consulta conunstable_cache(consulta, ['catalogo'], { tags: ['productos'], revalidate: 3600 })denext/cache(apartado 9.7); la página compila como○conRevalidate 1h.
Las funciones de lectura de la capa empiezan así:
export async function listarCatalogo(): Promise<ProductoCatalogo[]> {
  'use cache'
  cacheTag('productos')
  cacheLife('hours')
  // ... consulta
}
Ya conoces estas tres piezas del módulo 09. Aplicadas a una base de datos:
'use cache'guarda el resultado de la función. La siguiente llamada con los mismos argumentos devuelve el resultado guardado sin consultar SQLite. Los argumentos forman parte de la clave:obtenerProducto(1)yobtenerProducto(2)son entradas distintas.cacheTag('productos')etiqueta la entrada. Cuando los productos cambien, una Server Action caducará todas las entradas con esa etiqueta de una vez (apartado 10).obtenerProductolleva dos etiquetas: la general y la de su producto, para poder renovar una ficha sin tocar las demás.cacheLife('hours')fija cuánto vive la entrada si nadie la caduca antes. El catálogo cambia poco: horas. Los departamentos casi nunca:'days'.
El resultado de una función con 'use cache' debe poder serializarse (Next lo guarda y lo reconstruye). Las filas de Drizzle son objetos planos con números, cadenas, booleanos y null, así que no hay problema. No devuelvas desde una función en caché el propio objeto db ni una consulta sin ejecutar.
⚠️ Importante: Una función con
'use cache'no puede leercookies()niheaders(), ni directamente ni a través de otra función que llame (la documentación deuse cachelo describe con el errornext-request-in-use-cache). Para datos de un usuario concreto, lee la sesión fuera y pasa su identificador como argumento: así cada usuario tiene su propia entrada de caché. La autenticación del módulo 17 vuelve sobre esto.
9.3. Lo que dice next build
Con la base de datos preparada, el build real del proyecto de este módulo dio esta tabla (con la consola del servidor intercalada):
  Generating static pages using 9 workers (6/27) ...
[db] listarCatalogo 2026-11-02T12:46:14.310Z
[db] listarDepartamentos 2026-11-02T12:46:48.552Z
✓ Generating static pages using 9 workers (27/27)
Route (app)             Revalidate  Expire
┌ ○ /
├ ○ /_not-found
├ ○ /departamentos              1d      1w
├ ◐ /pedidos
├ ○ /tienda                     1h      1d
└   /tienda/[id]
  ├ ◐ /tienda/[id]
  ├ ○ /tienda/1                 1h      1d
  ├ ○ /tienda/2                 1h      1d
  └ ◐ [+17 more paths]
○  (Static)             prerendered as static content
◐  (Partial Prerender)  prerendered as static HTML with dynamic server-streamed content
/tienday/departamentosson estáticas (○): la consulta se hizo durante elbuild(las dos líneas[db]), y el HTML resultante se sirve ya hecho. Sus columnasRevalidateyExpirevienen de los perfileshours(1 h / 1 d) ydays(1 d / 1 semana).- Cada consulta se hizo una sola vez aunque haya varias páginas que la usan: la segunda vez ya estaba en caché.
/pedidoses◐: tiene una parte dinámica que se genera en cada petición. Es lo que quieres para la zona de gestión, y tiene truco (apartado 9.4).
Las fichas de producto usan generateStaticParams, que también puede leer de la base de datos:
// app/tienda/[id]/page.tsx
import { notFound } from 'next/navigation'
import { idsDeProductos, obtenerProducto } from '@/lib/db/catalogo'
import { formatoEuros } from '@/lib/formato'
import { guardarStock } from './acciones'

export async function generateStaticParams() {
  return idsDeProductos()
}

export default async function FichaProducto({ params }: PageProps<'/tienda/[id]'>) {
  const { id } = await params
  const producto = await obtenerProducto(Number(id))
  if (!producto) notFound()

  const { categoria } = producto
  return (
    <article className="space-y-3 rounded bg-white p-6 shadow">
      <p className="text-sm text-slate-500">
        {categoria.padre ? `${categoria.padre.nombre} › ` : ''}{categoria.nombre}
      </p>
      <h1 className="text-2xl font-bold">{producto.nombre}</h1>
      <p>{producto.descripcion}</p>
      <p className="text-xl font-semibold">{formatoEuros(producto.precio)}</p>

      <form action={guardarStock} className="flex items-center gap-2">
        <input type="hidden" name="productoId" value={producto.productoId} />
        <label htmlFor="stock">Stock</label>
        <input id="stock" name="stock" type="number" min={0} defaultValue={producto.stock}
          className="w-24 rounded border px-2 py-1" />
        <button className="rounded bg-indigo-700 px-3 py-1 text-white">Guardar</button>
      </form>
    </article>
  )
}
Las 19 fichas se generan en el build. Fíjate en que TypeScript sabe que categoria.padre puede ser null (las categorías raíz no tienen padre), gracias a la relación one() sobre una columna que admite nulos. El formulario de stock se explica en el apartado 10.1 (en una aplicación real solo lo vería un administrador, cosa que añadirás en el módulo 17).
9.4. La trampa: SQLite es demasiado rápido para el prerender
La página de pedidos quiere datos siempre actuales: si alguien cambia el estado de un pedido, el siguiente que entre debe verlo. Por eso listarPedidos no lleva 'use cache'. Siguiendo la guía de Next (“para datos sin caché, envuelve el componente en <Suspense>”), la página se escribió así:
// app/pedidos/page.tsx (primera versión)
export default function Pedidos() {
  return (
    <section className="space-y-4">
      <h1 className="text-2xl font-bold">Pedidos</h1>
      <Suspense fallback={<p>Cargando pedidos...</p>}>
        <TablaPedidos />
      </Suspense>
    </section>
  )
}
Y el build la marcó como ○ /pedidos: estática. Para confirmar lo que eso significa, con el servidor en marcha se cambió el estado del pedido 5024 directamente en la base de datos (de PENDIENTE a CANCELADO) y se volvió a pedir la página:
$ curl -sI http://127.0.0.1:5516/pedidos
x-nextjs-cache: HIT
x-nextjs-prerender: 1
Cache-Control: s-maxage=31536000

El pedido 5024 sigue saliendo como PENDIENTE.
La página estaba congelada con los datos del momento del build. ¿Por qué? Con Cache Components, Next prerenderiza cada página durante el build y espera un instante a que terminen las operaciones asíncronas. Lo que no termina a tiempo se considera dinámico y se aplaza a la petición. Una petición fetch a otra máquina nunca termina a tiempo. Pero una consulta a un fichero SQLite local tarda microsegundos: termina dentro del prerender, y Next la trata como contenido estático. La documentación de Next lo advierte para las bases de datos con API síncrona (better-sqlite3, node:sqlite); con @libsql/client, que es asíncrono, pasa exactamente lo mismo en la práctica, porque responde igual de rápido.
La solución es decirle a Next explícitamente que esa consulta depende de la petición, con connection() de next/server:
// lib/db/pedidos.ts
import 'server-only'
import { desc, eq, sql } from 'drizzle-orm'
import { connection } from 'next/server'
import { db } from '.'
import { clientes, lineasPedido, pedidos, type EstadoPedido } from '@/db/schema'

// Importe de una línea con su descuento (porcentaje)
const importeLinea = sql<number>`${lineasPedido.cantidad} * ${lineasPedido.precioUnitario} * (1 - ${lineasPedido.descuento} / 100.0)`

// Sin 'use cache': la zona de gestión quiere ver siempre el dato actual
export async function listarPedidos() {
  // Una consulta a SQLite local termina tan rápido que Next la completaría
  // durante el build y congelaría el resultado. connection() la aplaza
  // hasta que llega una petición real.
  await connection()
  return db
    .select({
      pedidoId: pedidos.pedidoId,
      fechaPedido: pedidos.fechaPedido,
      estado: pedidos.estado,
      cliente: clientes.nombre,
      total: sql<number>`round(coalesce(sum(${importeLinea}), 0), 2)`.mapWith(Number),
    })
    .from(pedidos)
    .innerJoin(clientes, eq(pedidos.clienteId, clientes.clienteId))
    .leftJoin(lineasPedido, eq(lineasPedido.pedidoId, pedidos.pedidoId))
    .groupBy(pedidos.pedidoId)
    .orderBy(desc(pedidos.fechaPedido), desc(pedidos.pedidoId))
}

export async function cambiarEstado(pedidoId: number, estado: EstadoPedido) {
  const hoy = new Date().toISOString().slice(0, 10)
  const [fila] = await db
    .update(pedidos)
    .set({
      estado,
      // Al marcarlo como enviado se rellena la fecha de envío si no la tenía
      fechaEnvio: estado === 'ENVIADO' ? sql`coalesce(${pedidos.fechaEnvio}, ${hoy})` : undefined,
    })
    .where(eq(pedidos.pedidoId, pedidoId))
    .returning({ pedidoId: pedidos.pedidoId, estado: pedidos.estado, fechaEnvio: pedidos.fechaEnvio })
  return fila ?? null
}
Con ese cambio, el build da ◐ /pedidos: el título y el texto “Cargando pedidos…” se prerenderizan, y la tabla se genera en cada petición. Se ha puesto connection() dentro de la capa de datos, y no en la página, para que la función sea honesta: quien llame a listarPedidos siempre obtendrá datos actuales, sin tener que acordarse del truco.
En cambiarEstado, poner undefined en un campo de set() hace que Drizzle lo omita del UPDATE: solo se toca fecha_envio al marcar el pedido como enviado, y coalesce respeta la fecha si ya la tenía.
💡 Consejo: Regla práctica para este curso: toda función de
lib/dblleva'use cache'oawait connection(). Si no lleva ninguna de las dos, pregúntate cuál de los dos comportamientos quieres, porque Next elegirá por ti, y elegirá congelar.
9.5. Sin <Suspense>: el error del build
Si una página llama a listarPedidos() (que ahora usa connection()) fuera de un <Suspense>:
export default async function Roto() {
  const pedidos = await listarPedidos()
  return <p>{pedidos.length} pedidos</p>
}
el build se detiene con este error real:
Error: Route "/roto": Next.js encountered uncached or runtime data during prerendering.
`fetch(...)`, `cookies()`, `headers()`, `params`, `searchParams`, or `connection()` accessed outside of `<Suspense>` prevents the route from being prerendered, blocking the page load and leading to a slower user experience.
Ways to fix this:
  - [stream] Provide a placeholder with `<Suspense fallback={...}>` around the data access
  - [cache] For uncached data (`fetch`, database calls): cache the access with `"use cache"` (does not apply to `connection()`)
  - [block] Set `export const instant = false` to allow a blocking route
Learn more: https://nextjs.org/docs/messages/blocking-prerender-dynamic
Es el mismo error que viste en el módulo 08 con fetch, y las soluciones son las mismas: un <Suspense> alrededor del componente que espera los datos (lo que hace la página de pedidos) o 'use cache' si los datos pueden estar en caché.
9.6. El build necesita la base de datos
Como las páginas en caché se prerenderizan en el build, next build consulta la base de datos. Si no has preparado empresa.db, el resultado real es este:
  Collecting page data using 9 workers ...
Error: Failed query: select cast("producto_id" as text) from "productos" where "productos"."descatalogado" = ?
params: 0
  ...
  [cause]: Error [LibsqlError]: SQLITE_ERROR: no such table: productos
    code: 'SQLITE_ERROR',
    ...
> Build error occurred
Error: Failed to collect page data for /tienda/[id]
Primero falla generateStaticParams, que es lo que se ejecuta antes. Y fíjate en un efecto secundario: libSQL crea un fichero empresa.db vacío (0 bytes) cuando no existe. La segunda vez ya no te dirá que falta el fichero, sino que faltan las tablas. La solución es npm run db:preparar antes del build. En un servidor de integración continua o en un Dockerfile, el orden es: instalar, migrar, (cargar datos si procede) y compilar. Lo verás en el módulo 23.
9.7. El equivalente en Next.js 15
Sin 'use cache' estable, Next.js 15 ofrece unstable_cache, que envuelve una función asíncrona y guarda su resultado:
// lib/db/catalogo.ts en Next.js 15
import 'server-only'
import { unstable_cache } from 'next/cache'
import { db } from '.'
// ...

async function consultaCatalogo() {
  return db.select({ /* ... */ }).from(productos) /* ... */
}

export const listarCatalogo = unstable_cache(consultaCatalogo, ['catalogo'], {
  tags: ['productos'],
  revalidate: 3600,
})
- El segundo argumento es una parte fija de la clave de caché; los argumentos de la función se añaden solos.
tagscumple la función decacheTag;revalidate(segundos), la decacheLife.
Compilado en Next.js 15.5.28, la página que usa listarCatalogo sale como estática con revalidación:
Route (app)                         Size  First Load JS  Revalidate  Expire
┌ ○ /                                0 B         113 kB          1h      1y
connection() existe también en Next.js 15 y se usa igual que en el apartado 9.4. Sin ella, Next.js 15 también prerenderiza la consulta en el build y congela los datos. Con ella, la página de pedidos compila como ƒ /pedidos (Dynamic): en la 15 no hay prerenderizado parcial, así que la página entera se genera en cada petición, no solo la tabla.
10. Escribir con Server Actions
Las mutaciones siguen el patrón del módulo 10: la Server Action valida los datos con Zod (módulo 11), llama a la capa de datos y renueva la caché de lo que ha cambiado.
10.1. Cambiar el stock y renovar la caché con updateTag 🆕 16.0
🆕 Desde Next.js 16.0.
updateTagno existe en Next.js 15. Si usas Next.js 15: llama arevalidateTag('productos')(con un solo argumento, que en la 15 caduca la etiqueta al momento) en lugar deupdateTag('productos'); el resto de la acción no cambia.
// app/tienda/[id]/acciones.ts
'use server'

import { updateTag } from 'next/cache'
import { z } from 'zod'
import { actualizarStock } from '@/lib/db/catalogo'

const esquemaStock = z.object({
  productoId: z.coerce.number().int().positive(),
  stock: z.coerce.number().int().min(0),
})

export async function guardarStock(formData: FormData) {
  // (en el módulo 17 aquí se comprobará que el usuario es ADMIN)
  const { productoId, stock } = esquemaStock.parse(Object.fromEntries(formData))

  const fila = await actualizarStock(productoId, stock)
  if (!fila) throw new Error(`El producto ${productoId} no existe`)

  updateTag(`producto-${productoId}`) // la ficha
  updateTag('productos') // el listado de la tienda
}
z.coerce.number(): los campos de un formulario llegan como texto; Zod los convierte y comprueba que son enteros no negativos. Si alguien manipula el formulario para enviarstock=-3,parselanza un error antes de tocar la base de datos. Y si se saltara Zod, la restricciónCHECK (stock >= 0)lo pararía.updateTagcaduca al momento todas las entradas con esa etiqueta. La siguiente vez que alguien pida la tienda,listarCatalogovolverá a consultar SQLite. Se usaupdateTagy norevalidateTag(tag, perfil)porque quien acaba de guardar debe ver su cambio ya, no la versión anterior mientras se regenera en segundo plano (la diferencia la estudiaste en el módulo 09).- Dos etiquetas: la ficha (
producto-1) y el listado (productos). ComoobtenerProductotambién lleva la etiquetaproductos, en este caso bastaría con la segunda; se ponen las dos para que quede claro qué se renueva.
10.2. Alta y baja de departamentos con mensajes de error
Aquí el usuario debe recibir respuesta: si el alta ha ido bien, si un campo está mal o si la base de datos lo ha rechazado. Las acciones devuelven un estado, que el formulario muestra con useActionState:
// app/departamentos/acciones.ts
'use server'

import { updateTag } from 'next/cache'
import { z } from 'zod'
import { crearDepartamento, eliminarDepartamento } from '@/lib/db/departamentos'
import { mensajeDeError } from '@/lib/db/errores'

export type EstadoFormulario = {
  ok: boolean
  mensaje: string
  errores?: Partial<Record<'nombre' | 'localidad' | 'presupuesto', string[]>>
}

const esquemaDepartamento = z.object({
  nombre: z.string().trim().min(2, 'Mínimo 2 caracteres').max(40).toUpperCase(),
  localidad: z.string().trim().min(2, 'Mínimo 2 caracteres'),
  presupuesto: z
    .string()
    .trim()
    .transform((v) => (v === '' ? null : Number(v)))
    .pipe(z.number().nonnegative('No puede ser negativo').nullable()),
})

export async function altaDepartamento(
  _anterior: EstadoFormulario,
  formData: FormData,
): Promise<EstadoFormulario> {
  const resultado = esquemaDepartamento.safeParse(Object.fromEntries(formData))
  if (!resultado.success) {
    return {
      ok: false,
      mensaje: 'Revisa los campos marcados.',
      errores: z.flattenError(resultado.error).fieldErrors,
    }
  }

  try {
    const nuevo = await crearDepartamento(resultado.data)
    updateTag('departamentos')
    return { ok: true, mensaje: `Creado el departamento ${nuevo.deptId} (${nuevo.nombre}).` }
  } catch (error) {
    console.error('[altaDepartamento]', error)
    return { ok: false, mensaje: mensajeDeError(error) }
  }
}

export async function bajaDepartamento(
  _anterior: EstadoFormulario,
  formData: FormData,
): Promise<EstadoFormulario> {
  const deptId = Number(formData.get('deptId'))
  try {
    const borrado = await eliminarDepartamento(deptId)
    if (!borrado) return { ok: false, mensaje: `El departamento ${deptId} ya no existe.` }
    updateTag('departamentos')
    updateTag(`departamento-${deptId}`)
    return { ok: true, mensaje: `Eliminado el departamento ${deptId}.` }
  } catch (error) {
    console.error('[bajaDepartamento]', error)
    return { ok: false, mensaje: mensajeDeError(error) }
  }
}
Puntos clave:
- El presupuesto vacío es
null, no 0, igual que en los datos originales del departamento 70. Eltransformconvierte la cadena vacía ennully elpipevalida el número resultante. toUpperCase()normaliza el nombre como el resto de departamentos. Esto importa para la restricciónUNIQUE: “ventas” se convierte en “VENTAS” y choca con el existente. Sin normalizar, “ventas” y “VENTAS” serían distintos para SQLite.updateTagsolo se llama si la escritura ha ido bien. Si la base de datos rechaza el cambio, no hay nada que renovar.- El
try/catchrodea solo la llamada a la base de datos, y el error completo va al registro del servidor. Recuerda del módulo 10 queredirect()lanza una excepción; si añadieras uno, debería ir fuera deltry.
Los formularios son Client Components, porque usan useActionState:
// app/departamentos/formularios.tsx
'use client'

import { useActionState } from 'react'
import { altaDepartamento, bajaDepartamento, type EstadoFormulario } from './acciones'

const inicial: EstadoFormulario = { ok: true, mensaje: '' }

function Aviso({ estado }: { estado: EstadoFormulario }) {
  if (!estado.mensaje) return null
  return (
    <p role="status" className={estado.ok ? 'text-green-700' : 'text-red-700'}>
      {estado.mensaje}
    </p>
  )
}

export function FormularioAlta() {
  const [estado, accion, pendiente] = useActionState(altaDepartamento, inicial)

  return (
    <form action={accion} className="space-y-2 rounded bg-white p-4 shadow">
      <h2 className="font-semibold">Nuevo departamento</h2>
      <div className="flex flex-wrap gap-2">
        {(['nombre', 'localidad', 'presupuesto'] as const).map((campo) => (
          <label key={campo} className="flex flex-col text-sm capitalize">
            {campo}
            <input name={campo} className="rounded border px-2 py-1"
              inputMode={campo === 'presupuesto' ? 'decimal' : undefined} />
            <span className="text-xs normal-case text-red-700">{estado.errores?.[campo]?.[0]}</span>
          </label>
        ))}
      </div>
      <button disabled={pendiente} className="rounded bg-indigo-700 px-3 py-1 text-white disabled:opacity-50">
        {pendiente ? 'Guardando...' : 'Crear'}
      </button>
      <Aviso estado={estado} />
    </form>
  )
}

export function BotonBaja({ deptId }: { deptId: number }) {
  const [estado, accion, pendiente] = useActionState(bajaDepartamento, inicial)

  return (
    <form action={accion} className="flex items-center gap-2">
      <input type="hidden" name="deptId" value={deptId} />
      <button disabled={pendiente} className="rounded border border-red-700 px-2 text-xs text-red-700">
        Eliminar
      </button>
      {!estado.ok && <span className="text-xs text-red-700">{estado.mensaje}</span>}
    </form>
  )
}
Y la página, un Server Component que lee de la caché y monta los formularios:
// app/departamentos/page.tsx
import { listarDepartamentos } from '@/lib/db/departamentos'
import { formatoEuros } from '@/lib/formato'
import { BotonBaja, FormularioAlta } from './formularios'

export const metadata = { title: 'Departamentos' }

export default async function Departamentos() {
  const departamentos = await listarDepartamentos()

  return (
    <section className="space-y-4">
      <h1 className="text-2xl font-bold">Departamentos</h1>
      <table className="w-full bg-white text-sm shadow">
        <thead className="bg-indigo-100 text-left">
          <tr><th className="p-2">Id</th><th className="p-2">Nombre</th><th className="p-2">Localidad</th><th className="p-2 text-right">Presupuesto</th><th className="p-2 text-right">Empleados</th><th className="p-2"></th></tr>
        </thead>
        <tbody>
          {departamentos.map((d) => (
            <tr key={d.deptId} className="border-t">
              <td className="p-2">{d.deptId}</td>
              <td className="p-2">{d.nombre}</td>
              <td className="p-2">{d.localidad}</td>
              <td className="p-2 text-right">{formatoEuros(d.presupuesto)}</td>
              <td className="p-2 text-right">{d.empleados}</td>
              <td className="p-2"><BotonBaja deptId={d.deptId} /></td>
            </tr>
          ))}
        </tbody>
      </table>
      <FormularioAlta />
    </section>
  )
}
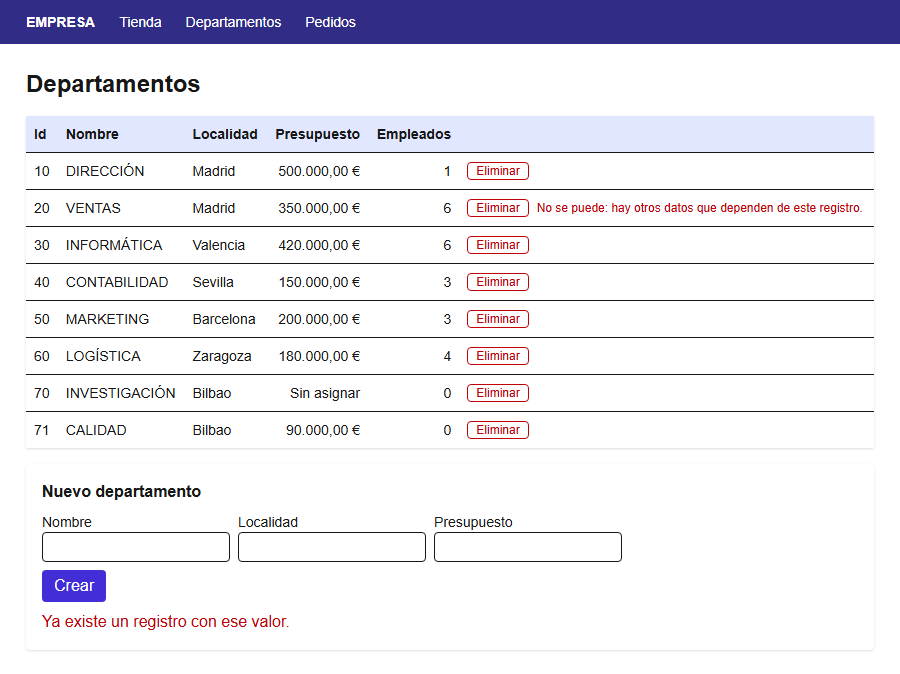
Figura 5. Tras crear CALIDAD (71), intentar crear “ventas” otra vez (UNIQUE) y eliminar VENTAS, que tiene seis empleados (clave ajena). Cada error de la base de datos llega al usuario como una frase comprensible.
10.3. Pedidos: datos sin caché y refresh 🆕 16.0
🆕 Desde Next.js 16.0.
refresh()denext/cacheno existe en Next.js 15. Si usas Next.js 15: llama arevalidatePath('/pedidos')al final de la acción; vuelve a generar la página y el navegador recibe los datos nuevos igual.
La lista de pedidos no está en caché, así que no hay etiqueta que caducar. Pero la página que ve el usuario sí debe volver a pintarse con los datos nuevos:
// app/pedidos/acciones.ts
'use server'

import { refresh } from 'next/cache'
import { z } from 'zod'
import { ESTADOS_PEDIDO } from '@/db/schema'
import { cambiarEstado } from '@/lib/db/pedidos'

const esquema = z.object({
  pedidoId: z.coerce.number().int().positive(),
  estado: z.enum(ESTADOS_PEDIDO),
})

export async function guardarEstado(formData: FormData) {
  const { pedidoId, estado } = esquema.parse(Object.fromEntries(formData))
  await cambiarEstado(pedidoId, estado)
  // La lista de pedidos no está en caché: basta con volver a pintar la página
  refresh()
}
z.enum(ESTADOS_PEDIDO) reutiliza la misma lista de estados que el esquema de la base de datos. Si algún día se añade un estado DEVUELTO, se cambia en un sitio y lo ven a la vez la columna, la restricción CHECK (cuando generes la migración), el tipo EstadoPedido, la validación y el <select> de la página:
// app/pedidos/page.tsx
import { Suspense } from 'react'
import { ESTADOS_PEDIDO } from '@/db/schema'
import { listarPedidos } from '@/lib/db/pedidos'
import { formatoEuros } from '@/lib/formato'
import { guardarEstado } from './acciones'

export const metadata = { title: 'Pedidos' }

async function TablaPedidos() {
  const pedidos = await listarPedidos()
  return (
    <table className="w-full bg-white text-sm shadow">
      <thead className="bg-indigo-100 text-left">
        <tr><th className="p-2">Pedido</th><th className="p-2">Fecha</th><th className="p-2">Cliente</th><th className="p-2 text-right">Total</th><th className="p-2">Estado</th></tr>
      </thead>
      <tbody>
        {pedidos.map((p) => (
          <tr key={p.pedidoId} className="border-t">
            <td className="p-2">{p.pedidoId}</td>
            <td className="p-2">{p.fechaPedido}</td>
            <td className="p-2">{p.cliente}</td>
            <td className="p-2 text-right">{formatoEuros(p.total)}</td>
            <td className="p-2">
              <form action={guardarEstado} className="flex gap-1">
                <input type="hidden" name="pedidoId" value={p.pedidoId} />
                <select name="estado" defaultValue={p.estado} className="rounded border px-1">
                  {ESTADOS_PEDIDO.map((e) => <option key={e}>{e}</option>)}
                </select>
                <button className="rounded bg-indigo-700 px-2 text-xs text-white">Cambiar</button>
              </form>
            </td>
          </tr>
        ))}
      </tbody>
    </table>
  )
}

export default function Pedidos() {
  return (
    <section className="space-y-4">
      <h1 className="text-2xl font-bold">Pedidos</h1>
      <Suspense fallback={<p>Cargando pedidos...</p>}>
        <TablaPedidos />
      </Suspense>
    </section>
  )
}
Figura 6. El pedido 5024 después de cambiarlo a ENVIADO. El total de cada pedido se calcula en SQL con sus descuentos.
10.4. Lo que se comprobó en el navegador
Con el proyecto compilado y en marcha (next start), un script de Playwright recorrió las tres pantallas. Esta es su salida real, junto con las líneas [db] que escribió el servidor:
12:48:07 paso 1 Tienda
tienda filas 19
UltraBook antes: Portátil UltraBook 14 Portátiles 899,00 € 25
12:48:09 paso 2 Ficha: poner stock 0
ficha stock tras guardar: 0
UltraBook después: Portátil UltraBook 14 Portátiles 899,00 € Agotado
12:48:41 paso 3 Departamentos
vacío: Nuevo departamento Nombre Mínimo 2 caracteres Localidad Mínimo 2 caracteres Presupuesto Crear Revisa los campos marcados.
alta: Creado el departamento 71 (CALIDAD).
duplicado: Ya existe un registro con ese valor.
baja VENTAS: 20 VENTAS Madrid 350.000,00 € 6 Eliminar No se puede: hay otros datos que dependen de este registro.
CALIDAD tras baja: 0
12:48:51 paso 4 Pedidos
5024 antes: PENDIENTE
5024 después: ENVIADO

Servidor:
[db] listarCatalogo 12:48:16      ← tras guardar el stock 0
[db] listarCatalogo 12:48:40      ← tras restaurar el stock a 25
[db] listarDepartamentos 12:48:43 ← tras crear CALIDAD
[db] listarDepartamentos 12:48:49 ← tras eliminar CALIDAD
Lee el registro del servidor con atención, porque resume todo el apartado 9:
- La primera visita a la tienda no consultó SQLite. No hay línea
[db]antes de las 12:48:16: la página se sirvió del prerender delbuild. - Cada
updateTagcorrecto provocó exactamente una consulta nueva. Dos cambios de stock, dos líneas de catálogo; un alta y una baja, dos líneas de departamentos. - Los intentos fallidos no tocaron la caché. El nombre duplicado y la baja de VENTAS no aparecen en el registro: la acción devolvió el error antes de llegar a
updateTag. - Los pedidos no aparecen, porque
listarPedidosno escribe en el registro, pero el cambio de estado se ve en cuanto se recarga la página: no hay caché que esperar.
11. Errores frecuentes
| Síntoma | Causa | Solución |
|---|---|---|
SQLITE_ERROR: no such table: productos en next build o en una página | No se han aplicado las migraciones, o el proceso se ha lanzado desde otra carpeta y ha creado otro empresa.db vacío | npm run db:preparar desde la raíz del proyecto; comprueba DATABASE_URL |
La página sale ○ y no refleja los cambios hechos en la base de datos | Consulta sin 'use cache' que SQLite resuelve durante el prerender | await connection() antes de la consulta (apartado 9.4) |
Next.js encountered uncached or runtime data during prerendering | Consulta con connection() fuera de <Suspense> | Envuelve el componente en <Suspense> o usa 'use cache' |
'server-only' cannot be imported from a Client Component module | Un Client Component importa algo de lib/db | Lee los datos en un Server Component y pásalos como props, o usa una Server Action |
Cambias schema.ts y la base de datos no cambia | Solo has ejecutado migrate | Primero drizzle-kit generate, después migrate |
generate no detecta un cambio que hiciste a mano en la base de datos | generate compara con la instantánea de drizzle/meta, no con la base de datos | No modifiques la base de datos a mano: cambia el esquema y genera una migración |
La suma de salarios sale "150002500" | sum y avg devuelven cadenas | .mapWith(Number) |
db.query.pedidos es undefined | drizzle(cliente) sin { schema } | drizzle(cliente, { schema }) con import * as schema |
Un borrado masivo falla con SQLITE_CONSTRAINT_TRIGGER en una tabla autorreferenciada | onDelete: 'restrict' comprueba fila a fila | Usa 'no action' (el valor por defecto) |
| El mensaje de error dice “Error inesperado” ante una clave ajena | El código es SQLITE_CONSTRAINT_TRIGGER (por restrict) y no ..._FOREIGNKEY | Cambia a no action o añade el código al traductor de errores |
Top-level await is currently not supported with the "cjs" output format | await en el nivel superior de un script .ts ejecutado con tsx | Envuelve el código en una función o usa la extensión .mts |
| La migración falla al añadir una columna obligatoria | notNull() sin default() en una tabla con filas | Añade un valor por defecto o hazlo en dos migraciones |
Una búsqueda con eq(columna, null) no devuelve nada | En SQL, = NULL nunca es verdadero | isNull(columna) |
| Una división da 0 | 5 / 100 es división entera en SQLite | Escribe 100.0 |
| Un usuario malintencionado obtiene todos los registros | Datos del usuario dentro de sql.raw o SQL concatenado | Usa sql con interpolación o los operadores de Drizzle, que parametrizan |
12. Ejercicios
Las soluciones de los ejercicios 1 a 6 se han ejecutado con tsx contra la base de datos recién cargada; las salidas son las reales. Escríbelas como funciones de lib/db (y añádeles 'use cache' o connection() según el caso, apartado 9.4) o pruébalas antes en un script como el de carga.
Ejercicio 1: Empleados con el nombre de su jefe
Escribe empleadosConJefe(deptId), que devuelva el nombre completo, el oficio y el nombre del jefe de cada empleado del departamento, ordenados por apellidos. Necesitarás unir la tabla empleados consigo misma.
Ver solución
Para unir una tabla consigo misma hace falta darle otro nombre en la consulta, igual que en SQL (from empleados left join empleados as jefes). En Drizzle eso se hace con alias:
import { asc, eq, sql } from 'drizzle-orm'
import { alias } from 'drizzle-orm/sqlite-core'
import { empleados } from '@/db/schema'

export async function empleadosConJefe(deptId: number) {
  const jefes = alias(empleados, 'jefes')
  return db
    .select({
      empleado: sql<string>`${empleados.nombre} || ' ' || ${empleados.apellidos}`,
      oficio: empleados.oficio,
      jefe: jefes.nombre,
    })
    .from(empleados)
    .leftJoin(jefes, eq(empleados.jefeId, jefes.empId))
    .where(eq(empleados.deptId, deptId))
    .orderBy(asc(empleados.apellidos))
}
Salida para el departamento 20:
[
  { empleado: 'Sergio Jiménez Vidal', oficio: 'VENDEDOR', jefe: 'Luis' },
  { empleado: 'Luis Martínez Ruiz', oficio: 'DIRECTOR', jefe: 'Ana' },
  { empleado: 'Elena Navarro Castro', oficio: 'VENDEDOR', jefe: 'Luis' },
  { empleado: 'Lucía Romero Serrano', oficio: 'ADMINISTRATIVO', jefe: 'Luis' },
  { empleado: 'Carmen Ruiz Ortega', oficio: 'VENDEDOR', jefe: 'Luis' },
  { empleado: 'David Torres Romero', oficio: 'VENDEDOR', jefe: 'Luis' }
]
Se usa leftJoin para no perder a quien no tiene jefe: con el departamento 10, Ana saldría con jefe: null. || es el operador de concatenación de SQL. Para la API relacional, la alternativa sería db.query.empleados.findMany({ with: { jefe: true } }) con la relación jefe del apartado 3.8.
Ejercicio 2: Los mejores clientes
Escribe mejoresClientes(limite), que devuelva los clientes que más han facturado (sin contar pedidos cancelados), con el número de pedidos y el total con descuentos, de mayor a menor. Los dos números deben ser number.
Ver solución
import { desc, eq, sql } from 'drizzle-orm'
import { clientes, lineasPedido, pedidos } from '@/db/schema'

const importe = sql`${lineasPedido.cantidad} * ${lineasPedido.precioUnitario} * (1 - ${lineasPedido.descuento} / 100.0)`

export async function mejoresClientes(limite = 5) {
  return db
    .select({
      clienteId: clientes.clienteId,
      nombre: clientes.nombre,
      pedidos: sql<number>`count(distinct ${pedidos.pedidoId})`.mapWith(Number),
      facturado: sql<number>`round(sum(${importe}), 2)`.mapWith(Number),
    })
    .from(clientes)
    .innerJoin(pedidos, eq(pedidos.clienteId, clientes.clienteId))
    .innerJoin(lineasPedido, eq(lineasPedido.pedidoId, pedidos.pedidoId))
    .where(sql`${pedidos.estado} <> 'CANCELADO'`)
    .groupBy(clientes.clienteId)
    .orderBy(desc(sql`4`))
    .limit(limite)
}
[
  { clienteId: 1010, nombre: 'Instituto Tecnológico Sur', pedidos: 2, facturado: 20602.55 },
  { clienteId: 1002, nombre: 'Construcciones Levante S.A.', pedidos: 3, facturado: 14260.19 },
  { clienteId: 1004, nombre: 'Academia Nova', pedidos: 2, facturado: 7891.3 },
  { clienteId: 1001, nombre: 'Talleres Martín S.L.', pedidos: 3, facturado: 4704.15 },
  { clienteId: 1007, nombre: 'Hotel Mar Azul S.L.', pedidos: 2, facturado: 4202.77 }
]
La clave es count(distinct ...): al unir con las líneas, cada pedido aparece una vez por línea, y un count normal contaría líneas, no pedidos. orderBy(desc(sql\4`)) ordena por la cuarta columna del select; también podrías darle un alias con .as(‘facturado’) y ordenar por él, como en el apartado 6.5. La condición podía escribirse también con ne(pedidos.estado, ‘CANCELADO’)`.
Ejercicio 3: Productos con poco stock
Con la API relacional, escribe stockBajo(umbral), que devuelva los productos no descatalogados con menos unidades que el umbral, de menos a más, con el nombre de su categoría y de la categoría padre.
Ver solución
import { and, asc, eq, lt } from 'drizzle-orm'
import { productos } from '@/db/schema'

export async function stockBajo(umbral = 10) {
  return db.query.productos.findMany({
    where: and(lt(productos.stock, umbral), eq(productos.descatalogado, false)),
    columns: { nombre: true, stock: true },
    orderBy: [asc(productos.stock)],
    with: {
      categoria: { columns: { nombre: true }, with: { padre: { columns: { nombre: true } } } },
    },
  })
}
[{"nombre":"Pack teclado y ratón","stock":0,"categoria":{"nombre":"Ratones y teclados","padre":{"nombre":"Periféricos"}}},
 {"nombre":"Torre Workstation","stock":4,"categoria":{"nombre":"Ordenadores sobremesa","padre":{"nombre":"Informática"}}},
 {"nombre":"Mesa Elevable","stock":6,"categoria":{"nombre":"Mobiliario","padre":{"nombre":"Oficina"}}},
 {"nombre":"Smartphone Gama Alta","stock":8,"categoria":{"nombre":"Telefonía","padre":{"nombre":"Electrónica"}}},
 {"nombre":"Impresora Láser","stock":9,"categoria":{"nombre":"Periféricos","padre":{"nombre":"Informática"}}}]
Fíjate en “Ratones y teclados”: su padre es “Periféricos”, que a su vez es hija de “Informática”. La consulta solo baja un nivel; para la ruta completa habría que anidar otro with: { padre: ... } o usar una consulta recursiva de SQL (with recursive).
Ejercicio 4: Buscador paginado
Escribe buscarProductos(texto, pagina, porPagina), que busque productos cuyo nombre contenga el texto y devuelva el total de coincidencias, el número de páginas y las filas de la página pedida, ordenadas por nombre.
Ver solución
import { asc, count, like } from 'drizzle-orm'
import { productos } from '@/db/schema'

export async function buscarProductos(texto: string, pagina = 1, porPagina = 5) {
  const filtro = like(productos.nombre, `%${texto}%`)
  const [{ total }] = await db.select({ total: count() }).from(productos).where(filtro)
  const filas = await db
    .select({ productoId: productos.productoId, nombre: productos.nombre, precio: productos.precio })
    .from(productos)
    .where(filtro)
    .orderBy(asc(productos.nombre))
    .limit(porPagina)
    .offset((pagina - 1) * porPagina)
  return { total, paginas: Math.ceil(total / porPagina), filas }
}
buscarProductos('o', 2) devuelve:
{"total":17,"paginas":4,"filas":[{"productoId":10,"nombre":"Monitor 27 4K","precio":329},
 {"productoId":8,"nombre":"Pack teclado y ratón","precio":34.5},{"productoId":3,"nombre":"Portátil Básico 15","precio":499},
 {"productoId":2,"nombre":"Portátil Gaming 16","precio":1499},{"productoId":1,"nombre":"Portátil UltraBook 14","precio":899}]}
El mismo filtro se usa en las dos consultas, así que el total y las filas siempre coinciden. Los % se añaden en JavaScript, pero el texto completo viaja como parámetro: aunque el usuario escriba comillas, no hay inyección posible. En SQLite, like no distingue mayúsculas de minúsculas en las letras ASCII, pero sí en las letras con tilde ('á' no encuentra 'Á'). En la página, el texto y la página llegarían por searchParams (módulo 18).
Ejercicio 5: Crear un pedido en una transacción
Escribe crearPedido(clienteId, lineas), que cree el pedido, inserte sus líneas con el precio actual de cada producto y descuente el stock. Si algún producto no tiene stock suficiente, no debe quedar nada: ni el pedido, ni las líneas, ni el stock descontado de los otros productos.
Ver solución
import { eq, sql } from 'drizzle-orm'
import { lineasPedido, pedidos, productos } from '@/db/schema'

type LineaNueva = { productoId: number; cantidad: number }

export async function crearPedido(clienteId: number, lineas: LineaNueva[]) {
  return db.transaction(async (tx) => {
    const [pedido] = await tx
      .insert(pedidos)
      .values({ clienteId, fechaPedido: new Date().toISOString().slice(0, 10) })
      .returning({ pedidoId: pedidos.pedidoId })

    for (const [i, linea] of lineas.entries()) {
      const [producto] = await tx
        .update(productos)
        .set({ stock: sql`${productos.stock} - ${linea.cantidad}` })
        .where(eq(productos.productoId, linea.productoId))
        .returning({ precio: productos.precio })
      if (!producto) throw new Error(`No existe el producto ${linea.productoId}`)

      await tx.insert(lineasPedido).values({
        pedidoId: pedido.pedidoId,
        numLinea: i + 1,
        productoId: linea.productoId,
        cantidad: linea.cantidad,
        precioUnitario: producto.precio,
      })
    }
    return pedido.pedidoId
  })
}
Prueba real, con el stock de los productos 3 y 5 antes y después:
stock antes 40 4
crearPedido(1001, [{3, 2}, {5, 1}])   → nuevo pedido 5025, stock 38 3
crearPedido(1001, [{3, 1}, {5, 100000}])
  → fallo: SQLITE_CONSTRAINT: CHECK constraint failed: productos_stock_no_negativo
stock tras el fallo 38 3, pedidos 25
El segundo pedido descontó una unidad del producto 3, pero al intentar dejar el 5 en negativo saltó el CHECK. La excepción salió de la función de la transacción y SQLite deshizo todo: el producto 3 sigue en 38 y no hay pedido 5026. Observa también:
- No hace falta comprobar el stock con un
selectprevio: la restricciónCHECKlo hace por ti, y lo hace sin el riesgo de que otra petición cambie el stock entre tuselecty tuupdate. stock - cantidadse calcula en SQL (sql\${productos.stock} - ${linea.cantidad}``), no leyendo el valor en JavaScript y escribiendo el resultado.- El
pedidoIdsale delreturningdel primerinserty se usa en los siguientes. Por eso aquí sirvetransactiony nobatch(apartado 6.8). - El
estadono se indica: toma el valor por defecto,'PENDIENTE'.
En la aplicación, la Server Action que la llame terminaría con updateTag('productos'), porque el stock del catálogo ha cambiado.
Ejercicio 6: Resumen de proyectos
Escribe resumenProyectos(), con una fila por proyecto: nombre, departamento, número de personas asignadas, horas totales (0 si no hay nadie), presupuesto y si está en curso (sin fechaFin). Los números deben ser number y “en curso”, boolean.
Ver solución
import { asc, count, eq, sql, sum } from 'drizzle-orm'
import { asignaciones, departamentos, proyectos } from '@/db/schema'

export async function resumenProyectos() {
  return db
    .select({
      proyecto: proyectos.nombre,
      departamento: departamentos.nombre,
      personas: count(asignaciones.empId),
      horas: sql<number>`coalesce(${sum(asignaciones.horas)}, 0)`.mapWith(Number),
      presupuesto: proyectos.presupuesto,
      enCurso: sql<boolean>`${proyectos.fechaFin} is null`.mapWith(Boolean),
    })
    .from(proyectos)
    .innerJoin(departamentos, eq(proyectos.deptId, departamentos.deptId))
    .leftJoin(asignaciones, eq(asignaciones.proyectoId, proyectos.proyectoId))
    .groupBy(proyectos.proyectoId)
    .orderBy(asc(proyectos.proyectoId))
}
┌───┬───────────────────────────┬───────────────┬──────────┬───────┬─────────────┬─────────┐
│   │ proyecto                  │ departamento  │ personas │ horas │ presupuesto │ enCurso │
├───┼───────────────────────────┼───────────────┼──────────┼───────┼─────────────┼─────────┤
│ 0 │ 'Migración a la nube'     │ 'INFORMÁTICA' │ 3        │ 1430  │ 120000      │ false   │
│ 1 │ 'Nueva tienda online'     │ 'INFORMÁTICA' │ 4        │ 1350  │ 90000       │ true    │
│ 2 │ 'Campaña Navidad 2025'    │ 'MARKETING'   │ 4        │ 480   │ 40000       │ false   │
│ 3 │ 'Optimización de almacén' │ 'LOGÍSTICA'   │ 3        │ 300   │ 35000       │ true    │
│ 4 │ 'Plan estratégico 2027'   │ 'DIRECCIÓN'   │ 0        │ 0     │ null        │ true    │
└───┴───────────────────────────┴───────────────┴──────────┴───────┴─────────────┴─────────┘
El proyecto 5 es el caso interesante: sin asignaciones (el leftJoin lo conserva, count da 0 y coalesce convierte en 0 la suma nula) y con presupuesto nulo, que se deja como null porque “sin presupuesto cerrado” no es lo mismo que “presupuesto 0”. Funciones como sum(...) se pueden interpolar dentro de una plantilla sql. SQLite devuelve las comparaciones como 0 o 1, y .mapWith(Boolean) las convierte en false y true.
Ejercicio 7: Elegir el comportamiento al borrar
La empresa quiere añadir dos tablas: nominas (cada nómina pertenece a un empleado) y vacaciones (cada periodo de vacaciones pertenece a un empleado y lo aprueba otro empleado). Decide el onDelete de cada una de las tres claves ajenas y justifícalo.
Ver solución
nominas.empId→'no action'. Las nóminas son documentos legales que hay que conservar años. Si se pudiera borrar un empleado con nóminas,cascadelas haría desaparecer yset nulldejaría nóminas sin dueño. Conno action, el borrado falla y obliga a decidir: normalmente, en vez de borrar al empleado, se marca como dado de baja (con una columna comofechaBaja, igual queactivoen los clientes del apartado 4.4).vacaciones.empId→'cascade'. Un periodo de vacaciones no tiene sentido sin su empleado. Si de verdad se borra el empleado (por ejemplo, un alta duplicada por error), sus vacaciones deben irse con él.vacaciones.aprobadaPor→'set null'. Si quien aprobó se va de la empresa, la aprobación sigue siendo válida; solo se pierde quién la dio. La columna debe admitir nulos (sinnotNull()).
La regla de fondo es la del apartado 3.4: pregúntate si la fila hija tiene sentido sin la padre (cascade si no, set null si sí) y si borrar la padre debe estar permitido (no action si no).
Ejercicio 8 (propuesto): Ficha de pedido
Crea /pedidos/[id] con el cliente, el empleado que lo gestionó (o “Sin asignar” si es null, como en el pedido 5014), la fecha de envío (o “Pendiente de envío”) y una tabla de líneas con el importe de cada una y el total. Usa la API relacional para los datos anidados y una función de lib/db con connection(). Si el pedido no existe, notFound().
Ejercicio 9 (propuesto): Dar de baja clientes sin borrarlos
Aplica la migración del apartado 4.4 (columna activo) y escribe una Server Action bajaCliente que ponga activo a false, con su botón en un listado de clientes. El listado, en caché con la etiqueta clientes, debe mostrar solo los activos y renovarse con updateTag. Comprueba que un cliente con pedidos, que no se podría borrar por la clave ajena, sí se puede dar de baja.
Ejercicio 10 (propuesto): Base de datos remota
Crea una base de datos gratuita en Turso, aplica las migraciones con drizzle-kit migrate cambiando en drizzle.config.ts el dialecto a 'turso' y añadiendo authToken, carga los datos y haz que la aplicación la use solo cambiando DATABASE_URL y añadiendo el token a createClient en lib/db/index.ts. ¿Qué cambia en el apartado 9.4 cuando cada consulta viaja por la red?
Resumen
| Concepto | API | Idea clave |
|---|---|---|
| SQLite y libSQL | createClient({ url: 'file:empresa.db' }) | Base de datos en un fichero; el mismo cliente sirve para una remota |
| Esquema | sqliteTable, integer, real, text | Clave TS en camelCase, columna SQL en snake_case |
| Nulos | sin notNull() | Solo donde los datos tienen significado nulo; 0 no es null |
| Claves ajenas | .references(() => t.col, { onDelete }) | cascade, set null o no action; evita restrict en borrados masivos |
| Autorreferencias | (): AnySQLiteColumn => tabla.col | Sin la anotación, la tabla pierde los tipos |
| Restricciones | primaryKey, index, check, unique | TypeScript protege el código; las restricciones, los datos |
| Relaciones | relations, one, many, relationName | No crean SQL; habilitan db.query |
| Tipos | $inferSelect, $inferInsert | Salen del esquema, no se escriben a mano |
| Migraciones | drizzle-kit generate / migrate | generate compara con la instantánea; migrate aplica lo pendiente |
| Carga de datos | db.batch([...]) | Todo o nada; borrar de hijas a padres, insertar al revés |
| Consultas | select, where, leftJoin, groupBy, toSQL() | Se parece al SQL; valores siempre como parámetros |
| Agregados | count, sum(...).mapWith(Number) | sum y avg devuelven string |
| Consultas anidadas | db.query.t.findFirst({ with }) | Requiere drizzle(cliente, { schema }) |
| Escrituras | insert/update/delete + returning() | [] si no se afectó ninguna fila; cuidado con olvidar el where |
| Transacciones | db.transaction(async (tx) => ...) | Una excepción deshace todo; usa tx, no db |
| Errores | error.cause.extendedCode | SQLITE_CONSTRAINT_UNIQUE, _FOREIGNKEY, _CHECK, _NOTNULL |
| Capa de datos | lib/db con import 'server-only' | Único sitio que toca la base de datos; devuelve DTO |
| Caché | 'use cache', cacheTag, cacheLife | La consulta se hace en el build y se sirve hecha |
| Datos siempre actuales | await connection() + <Suspense> | Sin connection(), SQLite responde a tiempo y la página se congela |
| Mutaciones | Server Action + Zod + updateTag / refresh | Validar, escribir con la capa de datos y renovar solo lo que cambió |
| Next.js 15 | unstable_cache, revalidateTag(tag), revalidatePath | Mismo patrón con las APIs anteriores |