Módulo 04: La API de Streams
Objetivos del módulo
- Entender qué es un stream, en qué se diferencia de una colección y qué significa la evaluación perezosa
- Crear streams desde colecciones, arrays, rangos, ficheros, generadores e iteradores
- Dominar las operaciones intermedias (
filter,map,flatMap,sorted,distinct,limit,skip,takeWhile,dropWhile,mapMulti,peek) y terminales (collect,reduce,count,min,max,anyMatch,findFirst,toList…) - Trabajar con streams primitivos y estadísticas
- Usar los colectores:
toMap,joining,groupingBycon colectores downstream,partitioningBy,teeing… - Aplicar los stream gatherers de Java 24 y escribir uno propio
- Saber cuándo compensa un stream paralelo y cuándo no
- Evitar los errores más comunes
- Resolver con streams consultas reales sobre la base de datos EMPRESA, comparándolas con su SQL
1. ¿Qué es un stream?
En el módulo anterior viste lambdas, interfaces funcionales y composición. La API de streams (Java 8) es donde todo eso cobra sentido: una forma declarativa de procesar secuencias de datos encadenando operaciones.
📘 Concepto: Un stream (flujo) es una secuencia de elementos sobre la que se aplica una tubería (pipeline) de operaciones: un origen (una colección, un array, un fichero…), cero o más operaciones intermedias que transforman el flujo y devuelven otro stream, y una única operación terminal que produce el resultado y pone en marcha todo el proceso.
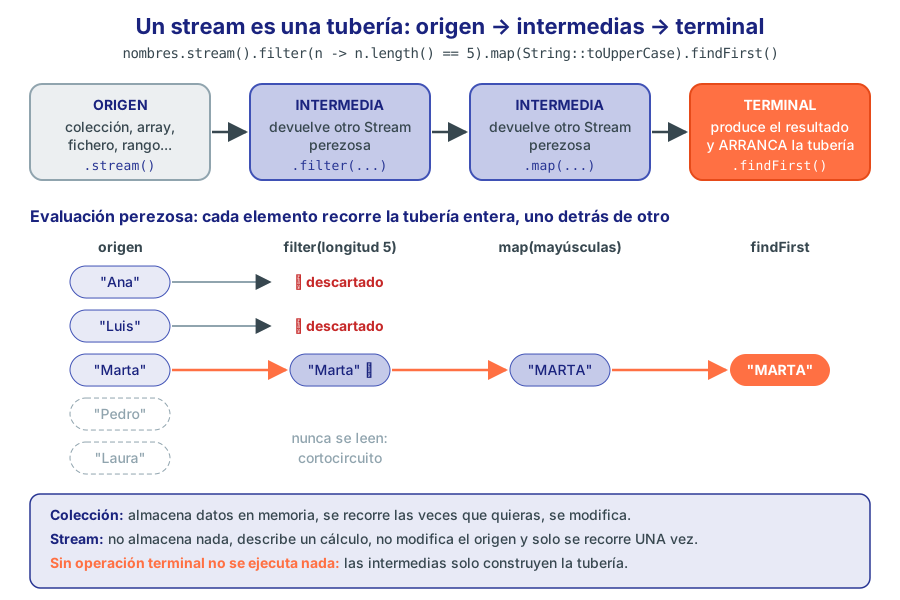
Figura 1. Un *stream es una tubería: cada elemento recorre toda la cadena, y solo cuando hay una operación terminal.*
1.1. Stream frente a colección
| Colección | Stream |
|---|---|
| Almacena elementos en memoria | No almacena nada: describe un cálculo sobre un origen |
| Se puede recorrer muchas veces | Se consume una sola vez |
Se modifica (add, remove) | No modifica su origen; produce resultados nuevos |
| Iteración externa: tú escribes el bucle | Iteración interna: la biblioteca recorre por ti |
| Tamaño finito y conocido | Puede ser infinito (Stream.iterate, generate) |
| Evaluación inmediata | Evaluación perezosa: no se hace nada hasta la operación terminal |
| Paralelizar exige gestionar hilos | .parallel() |
💡 Consejo: Piensa en la analogía de una cadena de montaje: la colección es el almacén de piezas; el stream es la cinta transportadora con sus estaciones de trabajo. La cinta no guarda piezas: las mueve de estación en estación, y no arranca hasta que alguien al final pide el producto.
1.2. Evaluación perezosa y cortocircuito
import java.util.List;
import java.util.stream.Stream;

public class Perezosa {
    public static void main(String[] args) {
        List<String> nombres = List.of("Ana", "Luis", "Marta", "Pedro", "Laura", "Javier");

        // Sin operación terminal no se ejecuta NADA
        Stream<String> sinTerminal = nombres.stream().peek(n -> System.out.println("  nunca se imprime " + n));
        System.out.println("Stream creado (" + sinTerminal.getClass().getName() + "), pero no ha procesado nada");

        // Cada elemento recorre toda la tubería antes de pasar al siguiente (vertical, no por fases)
        System.out.println("Tubería con findFirst:");
        String primero = nombres.stream()
                .peek(n -> System.out.println("  origen:  " + n))
                .filter(n -> n.length() == 5)
                .peek(n -> System.out.println("  filtro:  " + n + " ✔"))
                .map(String::toUpperCase)
                .peek(n -> System.out.println("  map:     " + n))
                .findFirst()                                     // cortocircuito: para en cuanto encuentra
                .orElse("ninguno");
        System.out.println("Resultado: " + primero + " (Pedro, Laura y Javier ni se han leído)");

        // sorted es una operación "con estado": necesita ver TODOS los elementos antes de seguir
        System.out.println("Tubería con sorted:");
        nombres.stream()
                .peek(n -> System.out.println("  antes de sorted: " + n))
                .sorted()
                .limit(2)
                .forEach(n -> System.out.println("  después: " + n));
    }
}
Stream creado (java.util.stream.ReferencePipeline$15), pero no ha procesado nada
Tubería con findFirst:
  origen:  Ana
  origen:  Luis
  origen:  Marta
  filtro:  Marta ✔
  map:     MARTA
Resultado: MARTA (Pedro, Laura y Javier ni se han leído)
Tubería con sorted:
  antes de sorted: Ana
  antes de sorted: Luis
  antes de sorted: Marta
  antes de sorted: Pedro
  antes de sorted: Laura
  antes de sorted: Javier
  después: Ana
  después: Javier
Tres conclusiones fundamentales:
- Sin operación terminal no se ejecuta nada: el primer
peeknunca imprime. El stream creado es solo un objeto que describe la tubería. - El procesamiento es vertical: “Ana” recorre todas las etapas antes de que empiece “Luis”. No se filtra toda la lista y luego se transforma toda, como harías con bucles por fases.
- Las operaciones de cortocircuito (
findFirst,anyMatch,limit…) paran en cuanto tienen la respuesta: Pedro, Laura y Javier ni se leen. Eso permite trabajar incluso con streams infinitos.
La excepción son las operaciones con estado como sorted o distinct: para ordenar hay que ver todos los elementos, así que sorted actúa como una barrera (fíjate en que todos los “antes de sorted” salen primero).
2. El modelo de datos: la base de datos EMPRESA en memoria
Casi todos los ejemplos del módulo trabajan con los datos de la base de datos EMPRESA que ya conoces (departamentos, empleados, clientes, productos, pedidos y sus líneas), cargados en memoria como records. Así podrás comparar cada consulta con su equivalente SQL del Curso de Bases de Datos, y en los módulos de JDBC e Hibernate cargarás estos mismos datos desde MySQL.
public record Departamento(int id, String nombre, String localidad, Double presupuesto) {}
import java.time.LocalDate;

public record Empleado(int id, String nombre, String apellidos, LocalDate fechaAlta, String oficio,
                       double salario, Double comision, Integer jefe, Integer departamento) {

    /** Salario más comisión (la comisión puede ser null). */
    public double salarioTotal() {
        return salario + (comision == null ? 0 : comision);
    }
}
public record Cliente(int id, String nombre, String ciudad, double limiteCredito, Integer comercial) {}
public record Producto(int id, String nombre, int categoria, double precio, int stock, boolean descatalogado) {}
public record LineaPedido(int producto, int cantidad, double precioUnitario, double descuento) {

    /** Importe de la línea aplicando el porcentaje de descuento. */
    public double importe() {
        return cantidad * precioUnitario * (1 - descuento / 100);
    }
}
import java.time.LocalDate;
import java.util.List;

public record Pedido(int id, int cliente, Integer empleado, LocalDate fecha, String estado,
                     List<LineaPedido> lineas) {

    /** Total del pedido: suma de los importes de sus líneas. */
    public double total() {
        return lineas.stream().mapToDouble(LineaPedido::importe).sum();
    }
}
Y la clase Empresa con todos los datos (es larga: despliégala para copiarla):
Ver Empresa.java completo
import java.time.LocalDate;
import java.util.List;
import java.util.Map;
import java.util.stream.Collectors;

/** Datos de la base de datos EMPRESA del curso, cargados en memoria. */
public final class Empresa {
    private Empresa() {}

    private static LocalDate d(String s) { return LocalDate.parse(s); }

    public static final List<Departamento> DEPARTAMENTOS = List.of(
            new Departamento(10, "DIRECCIÓN", "Madrid", 500000.0),
            new Departamento(20, "VENTAS", "Madrid", 350000.0),
            new Departamento(30, "INFORMÁTICA", "Valencia", 420000.0),
            new Departamento(40, "CONTABILIDAD", "Sevilla", 150000.0),
            new Departamento(50, "MARKETING", "Barcelona", 200000.0),
            new Departamento(60, "LOGÍSTICA", "Zaragoza", 180000.0),
            new Departamento(70, "INVESTIGACIÓN", "Bilbao", null));

    public static final List<Empleado> EMPLEADOS = List.of(
            new Empleado(100, "Ana", "García López", d("2010-01-15"), "DIRECTOR GENERAL", 6500, null, null, 10),
            new Empleado(101, "Luis", "Martínez Ruiz", d("2012-03-01"), "DIRECTOR", 4800, null, 100, 20),
            new Empleado(102, "Marta", "Sánchez Gil", d("2011-06-20"), "DIRECTOR", 5000, null, 100, 30),
            new Empleado(103, "Pedro", "Gómez Díaz", d("2013-09-10"), "DIRECTOR", 4200, null, 100, 40),
            new Empleado(104, "Laura", "Fernández Moreno", d("2015-02-02"), "DIRECTOR", 4300, null, 100, 50),
            new Empleado(105, "Javier", "López Navarro", d("2014-11-11"), "DIRECTOR", 4000, null, 100, 60),
            new Empleado(110, "Carmen", "Ruiz Ortega", d("2016-04-12"), "VENDEDOR", 2200, 500.0, 101, 20),
            new Empleado(111, "David", "Torres Romero", d("2017-07-01"), "VENDEDOR", 2100, 800.0, 101, 20),
            new Empleado(112, "Elena", "Navarro Castro", d("2019-01-15"), "VENDEDOR", 2300, 300.0, 101, 20),
            new Empleado(113, "Sergio", "Jiménez Vidal", d("2021-09-01"), "VENDEDOR", 1900, 0.0, 101, 20),
            new Empleado(114, "Lucía", "Romero Serrano", d("2020-02-10"), "ADMINISTRATIVO", 1700, null, 101, 20),
            new Empleado(120, "Pablo", "Moreno Herrera", d("2014-05-05"), "ANALISTA", 3500, null, 102, 30),
            new Empleado(121, "Raquel", "Molina Prieto", d("2018-10-01"), "PROGRAMADOR", 2800, null, 120, 30),
            new Empleado(122, "Iván", "Castro Méndez", d("2020-03-16"), "PROGRAMADOR", 2600, null, 120, 30),
            new Empleado(123, "Sara", "Ortiz Delgado", d("2022-06-01"), "PROGRAMADOR", 2400, null, 120, 30),
            new Empleado(124, "Hugo", "Rubio Marín", d("2019-11-20"), "TÉCNICO SISTEMAS", 2500, null, 102, 30),
            new Empleado(130, "Isabel", "Domínguez Vega", d("2016-08-08"), "CONTABLE", 2600, null, 103, 40),
            new Empleado(131, "Jorge", "Vázquez Ramos", d("2023-01-09"), "ADMINISTRATIVO", 1650, null, 103, 40),
            new Empleado(140, "Nuria", "Gil Soto", d("2018-05-21"), "DISEÑADOR", 2300, null, 104, 50),
            new Empleado(141, "Álvaro", "Peña Cano", d("2021-04-12"), "ANALISTA", 2700, null, 104, 50),
            new Empleado(150, "Rosa", "Iglesias Cruz", d("2017-03-03"), "OPERARIO", 1600, null, 105, 60),
            new Empleado(151, "Manuel", "Herrero Lozano", d("2022-10-17"), "OPERARIO", 1600, null, 105, 60),
            new Empleado(152, "Cristina", "Medina Blanco", d("2019-07-22"), "ADMINISTRATIVO", 1750, null, 105, 60),
            new Empleado(160, "Tomás", "Reyes Fuentes", d("2025-09-01"), "BECARIO", 900, null, 102, null));

    public static final List<Cliente> CLIENTES = List.of(
            new Cliente(1001, "Talleres Martín S.L.", "Valencia", 10000, 110),
            new Cliente(1002, "Construcciones Levante S.A.", "Alicante", 25000, 110),
            new Cliente(1003, "María José Herrera", "Madrid", 2000, 111),
            new Cliente(1004, "Academia Nova", "Madrid", 8000, 111),
            new Cliente(1005, "Clínica Dental Sonrisa", "Sevilla", 6000, 112),
            new Cliente(1006, "Antonio Ruiz Pérez", "Sevilla", 1500, 112),
            new Cliente(1007, "Hotel Mar Azul S.L.", "Palma", 15000, 111),
            new Cliente(1008, "Gestoría Delta", "Zaragoza", 5000, 113),
            new Cliente(1009, "Laura Benítez Sanz", "Bilbao", 1000, null),
            new Cliente(1010, "Instituto Tecnológico Sur", "Granada", 20000, 112),
            new Cliente(1011, "Panadería La Espiga", "Valladolid", 2500, 113),
            new Cliente(1012, "Diseños Creativos S.L.", "Barcelona", 7000, 110),
            new Cliente(1013, "Carlos Ibáñez Rey", "Valencia", 1500, null),
            new Cliente(1014, "Farmacia Central", "Oviedo", 4000, 113));

    public static final List<Producto> PRODUCTOS = List.of(
            new Producto(1, "Portátil UltraBook 14", 2, 899.00, 25, false),
            new Producto(2, "Portátil Gaming 16", 2, 1499.00, 10, false),
            new Producto(3, "Portátil Básico 15", 2, 499.00, 40, false),
            new Producto(4, "Torre Oficina i5", 3, 649.00, 15, false),
            new Producto(5, "Torre Workstation", 3, 1899.00, 4, false),
            new Producto(6, "Ratón inalámbrico", 5, 19.90, 200, false),
            new Producto(7, "Teclado mecánico", 5, 79.90, 60, false),
            new Producto(8, "Pack teclado y ratón", 5, 34.50, 0, false),
            new Producto(9, "Monitor 24 FHD", 6, 139.00, 35, false),
            new Producto(10, "Monitor 27 4K", 6, 329.00, 12, false),
            new Producto(11, "Smartphone Gama Media", 8, 299.00, 50, false),
            new Producto(12, "Smartphone Gama Alta", 8, 999.00, 8, false),
            new Producto(13, "Auriculares Bluetooth", 9, 59.90, 80, false),
            new Producto(14, "Altavoz Inteligente", 9, 49.00, 0, true),
            new Producto(15, "Silla Ergonómica", 11, 249.00, 20, false),
            new Producto(16, "Mesa Elevable", 11, 399.00, 6, false),
            new Producto(17, "Webcam HD", 4, 45.00, 30, false),
            new Producto(18, "Impresora Láser", 4, 189.00, 9, false),
            new Producto(19, "Disco SSD 1TB", 1, 89.90, 70, false),
            new Producto(20, "Tablet 10", 7, 279.00, 14, false));

    public static final List<Pedido> PEDIDOS = List.of(
            new Pedido(5001, 1001, 110, d("2025-01-15"), "ENTREGADO",
                    List.of(new LineaPedido(2, 1, 1499.00, 0),
                    new LineaPedido(6, 2, 19.90, 0),
                    new LineaPedido(9, 2, 139.00, 5))),
            new Pedido(5002, 1002, 110, d("2025-01-28"), "ENTREGADO",
                    List.of(new LineaPedido(4, 10, 649.00, 10),
                    new LineaPedido(9, 10, 139.00, 10),
                    new LineaPedido(8, 10, 34.50, 10))),
            new Pedido(5003, 1003, 111, d("2025-02-03"), "ENTREGADO",
                    List.of(new LineaPedido(3, 1, 499.00, 0),
                    new LineaPedido(13, 1, 59.90, 0))),
            new Pedido(5004, 1004, 111, d("2025-02-20"), "ENTREGADO",
                    List.of(new LineaPedido(1, 5, 899.00, 5),
                    new LineaPedido(10, 5, 329.00, 5),
                    new LineaPedido(7, 5, 79.90, 0))),
            new Pedido(5005, 1005, 112, d("2025-03-05"), "ENTREGADO",
                    List.of(new LineaPedido(15, 3, 249.00, 0),
                    new LineaPedido(18, 1, 189.00, 0))),
            new Pedido(5006, 1001, 110, d("2025-03-22"), "ENTREGADO",
                    List.of(new LineaPedido(19, 4, 89.90, 0),
                    new LineaPedido(6, 4, 19.90, 0))),
            new Pedido(5007, 1007, 111, d("2025-04-10"), "ENTREGADO",
                    List.of(new LineaPedido(11, 6, 299.00, 8),
                    new LineaPedido(13, 6, 59.90, 8),
                    new LineaPedido(20, 2, 279.00, 0))),
            new Pedido(5008, 1008, 113, d("2025-05-06"), "CANCELADO",
                    List.of(new LineaPedido(16, 2, 399.00, 0))),
            new Pedido(5009, 1002, 110, d("2025-05-19"), "ENTREGADO",
                    List.of(new LineaPedido(5, 2, 1899.00, 12),
                    new LineaPedido(10, 4, 329.00, 5),
                    new LineaPedido(17, 4, 45.00, 0))),
            new Pedido(5010, 1010, 112, d("2025-06-02"), "ENTREGADO",
                    List.of(new LineaPedido(3, 20, 499.00, 15),
                    new LineaPedido(9, 20, 139.00, 15),
                    new LineaPedido(8, 20, 34.50, 15),
                    new LineaPedido(17, 5, 45.00, 0))),
            new Pedido(5011, 1006, 112, d("2025-06-25"), "ENTREGADO",
                    List.of(new LineaPedido(12, 1, 999.00, 0))),
            new Pedido(5012, 1004, 111, d("2025-09-08"), "ENTREGADO",
                    List.of(new LineaPedido(2, 1, 1499.00, 0),
                    new LineaPedido(7, 2, 79.90, 0))),
            new Pedido(5013, 1012, 110, d("2025-10-14"), "ENTREGADO",
                    List.of(new LineaPedido(10, 2, 329.00, 0),
                    new LineaPedido(16, 1, 399.00, 0),
                    new LineaPedido(15, 2, 249.00, 0))),
            new Pedido(5014, 1009, null, d("2025-11-03"), "ENTREGADO",
                    List.of(new LineaPedido(13, 1, 59.90, 0),
                    new LineaPedido(6, 1, 19.90, 0))),
            new Pedido(5015, 1003, 111, d("2025-11-27"), "ENTREGADO",
                    List.of(new LineaPedido(20, 1, 279.00, 0))),
            new Pedido(5016, 1010, 112, d("2026-01-12"), "ENTREGADO",
                    List.of(new LineaPedido(1, 10, 899.00, 10),
                    new LineaPedido(19, 10, 89.90, 5))),
            new Pedido(5017, 1011, 113, d("2026-02-09"), "ENTREGADO",
                    List.of(new LineaPedido(4, 1, 649.00, 0),
                    new LineaPedido(18, 1, 189.00, 0))),
            new Pedido(5018, 1002, 110, d("2026-03-03"), "ENTREGADO",
                    List.of(new LineaPedido(11, 4, 299.00, 5),
                    new LineaPedido(12, 1, 999.00, 5))),
            new Pedido(5019, 1005, 112, d("2026-04-21"), "ENTREGADO",
                    List.of(new LineaPedido(15, 2, 249.00, 0),
                    new LineaPedido(16, 2, 399.00, 0))),
            new Pedido(5020, 1007, 111, d("2026-05-30"), "ENVIADO",
                    List.of(new LineaPedido(9, 8, 139.00, 5),
                    new LineaPedido(7, 8, 79.90, 5))),
            new Pedido(5021, 1001, 110, d("2026-06-15"), "ENVIADO",
                    List.of(new LineaPedido(5, 1, 1899.00, 5),
                    new LineaPedido(10, 2, 329.00, 0))),
            new Pedido(5022, 1012, 110, d("2026-07-01"), "PENDIENTE",
                    List.of(new LineaPedido(2, 1, 1499.00, 0))),
            new Pedido(5023, 1009, null, d("2026-07-08"), "PENDIENTE",
                    List.of(new LineaPedido(13, 2, 59.90, 0),
                    new LineaPedido(11, 1, 299.00, 0))),
            new Pedido(5024, 1008, 113, d("2026-07-10"), "PENDIENTE",
                    List.of(new LineaPedido(3, 3, 499.00, 0))));

    /** Nombre del departamento por id (para mostrar resultados). */
    public static final Map<Integer, String> NOMBRE_DEPARTAMENTO = DEPARTAMENTOS.stream()
            .collect(Collectors.toMap(Departamento::id, Departamento::nombre));
}
💡 Consejo: Guarda los siete ficheros (
Departamento.java,Empleado.java,Cliente.java,Producto.java,LineaPedido.java,Pedido.javayEmpresa.java) en la misma carpeta que los ejemplos. Desde Java 22 (JEP 458) el lanzador de código fuente encuentra y compila automáticamente las demás clases de la carpeta, así que puedes ejecutar cada ejemplo conjava Intermedias.javasin compilar nada antes. En un proyecto Maven irían ensrc/main/java.
3. Crear streams
| Origen | Cómo | Notas |
|---|---|---|
| Colección | lista.stream(), conjunto.stream(), mapa.entrySet().stream() | El más habitual |
| Valores sueltos | Stream.of(a, b, c) | |
| Array | Arrays.stream(array), Arrays.stream(array, desde, hasta) | Con int[] da un IntStream |
| Rango de enteros | IntStream.range(0, n) (sin incluir n), rangeClosed(1, n) | Sustituye al for (int i...) |
| Infinito por iteración | Stream.iterate(semilla, f), Stream.iterate(semilla, condición, f) (Java 9) | Siempre con limit o condición |
| Infinito por generación | Stream.generate(supplier) | Siempre con limit |
| Texto | cadena.chars(), cadena.lines(), Pattern.splitAsStream(texto) | |
| Fichero | Files.lines(ruta) | Perezoso: hay que cerrarlo con try-with-resources |
| Directorios | Files.list(dir), Files.walk(dir) | Módulo 08 |
| Aleatorios | random.ints(n, min, max), doubles(...) | |
| Varios | Stream.concat(s1, s2), Stream.empty(), Stream.ofNullable(x) (Java 9) | |
| Opcional | optional.stream() (Java 9) | 0 o 1 elementos |
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.Arrays;
import java.util.List;
import java.util.Random;
import java.util.regex.Pattern;
import java.util.stream.IntStream;
import java.util.stream.Stream;

public class CrearStreams {
    public static void main(String[] args) throws IOException {
        // 1. Desde una colección
        List<String> ciudades = List.of("Madrid", "Valencia", "Sevilla", "Barcelona");
        System.out.println("colección:      " + ciudades.stream().filter(c -> c.length() > 6).toList());

        // 2. Valores sueltos y arrays
        System.out.println("Stream.of:      " + Stream.of("a", "b", "c").toList());
        int[] notas = {7, 4, 9, 6};
        System.out.println("Arrays.stream:  " + Arrays.stream(notas).max().getAsInt());

        // 3. Rangos de enteros
        System.out.println("range(1, 5):    " + IntStream.range(1, 5).boxed().toList());          // 1..4
        System.out.println("rangeClosed:    " + IntStream.rangeClosed(1, 5).sum());               // 1..5

        // 4. Infinitos: iterate y generate (¡siempre con limit o una condición!)
        System.out.println("iterate:        " + Stream.iterate(1, x -> x * 2).limit(10).toList());
        System.out.println("iterate (Java 9): " + Stream.iterate(1, x -> x <= 1000, x -> x * 10).toList());
        Random r = new Random(7);
        System.out.println("generate:       " + Stream.generate(() -> r.nextInt(100)).limit(5).toList());
        System.out.println("Random.ints:    " + new Random(7).ints(5, 0, 100).boxed().toList());

        // 5. Desde texto
        System.out.println("chars:          " + "Java".chars().mapToObj(c -> (char) c).toList());
        System.out.println("splitAsStream:  " + Pattern.compile(",\\s*").splitAsStream("uno, dos,tres").toList());
        System.out.println("lines:          " + "l1\nl2\nl3".lines().count() + " líneas");

        // 6. Desde un fichero: Files.lines es perezoso y hay que cerrarlo (try-with-resources)
        Path csv = Files.createTempFile("departamentos", ".csv");
        Files.writeString(csv, """
                10;DIRECCIÓN;Madrid
                20;VENTAS;Madrid
                30;INFORMÁTICA;Valencia
                40;CONTABILIDAD;Sevilla
                """);
        try (Stream<String> lineas = Files.lines(csv)) {
            List<String> deMadrid = lineas.map(l -> l.split(";"))
                    .filter(campos -> campos[2].equals("Madrid"))
                    .map(campos -> campos[1])
                    .toList();
            System.out.println("Files.lines:    " + deMadrid);
        }

        // 7. Combinar y casos especiales
        System.out.println("concat:         " + Stream.concat(Stream.of(1, 2), Stream.of(3)).toList());
        String nulo = null;
        System.out.println("ofNullable:     " + Stream.ofNullable(nulo).count());
        System.out.println("empty:          " + Stream.empty().findFirst());
    }
}
colección:      [Valencia, Sevilla, Barcelona]
Stream.of:      [a, b, c]
Arrays.stream:  9
range(1, 5):    [1, 2, 3, 4]
rangeClosed:    15
iterate:        [1, 2, 4, 8, 16, 32, 64, 128, 256, 512]
iterate (Java 9): [1, 10, 100, 1000]
generate:       [36, 64, 85, 44, 80]
Random.ints:    [36, 64, 85, 44, 80]
chars:          [J, a, v, a]
splitAsStream:  [uno, dos, tres]
lines:          3 líneas
Files.lines:    [DIRECCIÓN, VENTAS]
concat:         [1, 2, 3]
ofNullable:     0
empty:          Optional.empty
⚠️ Importante:
Files.lines(igual queFiles.listyFiles.walk) mantiene el fichero abierto mientras el stream exista. Si no lo cierras, agotarás los descriptores de fichero del sistema en aplicaciones que procesan muchos ficheros. Usa siempre try-with-resources:StreamimplementaAutoCloseable.
Observa también que Stream.generate con un Random(7) y new Random(7).ints(...) dan los mismos números: con la misma semilla, un Random genera siempre la misma secuencia, algo muy útil para pruebas reproducibles.
4. Operaciones intermedias
Cada operación intermedia devuelve un nuevo stream, por eso se pueden encadenar.
| Operación | Tipo | Qué hace |
|---|---|---|
filter(Predicate) | Sin estado | Deja pasar los elementos que cumplen la condición |
map(Function) | Sin estado | Transforma cada elemento (puede cambiar de tipo) |
mapToInt, mapToLong, mapToDouble, mapToObj, boxed | Sin estado | Cambia entre streams de objetos y primitivos |
flatMap(Function<T, Stream<R>>) | Sin estado | Cada elemento produce un stream; todos se aplanan en uno |
mapMulti(BiConsumer) (Java 16) | Sin estado | Cada elemento emite 0, 1 o varios resultados con un “consumidor” |
peek(Consumer) | Sin estado | Ejecuta una acción con cada elemento sin cambiarlo (para depurar) |
distinct() | Con estado | Elimina duplicados (usa equals/hashCode) |
sorted(), sorted(Comparator) | Con estado | Ordena |
limit(n) | Cortocircuito | Como mucho n elementos |
skip(n) | Con estado | Descarta los n primeros |
takeWhile(Predicate) (Java 9) | Cortocircuito | Toma elementos mientras se cumpla la condición; para en el primero que no |
dropWhile(Predicate) (Java 9) | Con estado | Descarta elementos mientras se cumpla; deja pasar el resto |
gather(Gatherer) (Java 24) | Depende | Operación intermedia personalizada (sección 8) |
import java.util.Comparator;
import java.util.List;
import java.util.stream.Stream;

public class Intermedias {
    public static void main(String[] args) {
        List<Empleado> emp = Empresa.EMPLEADOS;

        // filter + map: nombres de los programadores
        System.out.println("filter/map:  " + emp.stream()
                .filter(e -> e.oficio().equals("PROGRAMADOR"))
                .map(Empleado::nombre)
                .toList());

        // distinct + sorted: oficios distintos ordenados
        System.out.println("distinct:    " + emp.stream().map(Empleado::oficio).distinct().sorted().toList());

        // sorted con Comparator + limit: los 3 salarios más altos
        System.out.println("top 3:       " + emp.stream()
                .sorted(Comparator.comparingDouble(Empleado::salario).reversed())
                .limit(3)
                .map(e -> e.nombre() + " " + e.salario())
                .toList());

        // skip + limit: paginación (página 2 de tamaño 5, por id)
        System.out.println("página 2:    " + emp.stream()
                .sorted(Comparator.comparingInt(Empleado::id))
                .skip(5).limit(5)
                .map(Empleado::id)
                .toList());

        // flatMap: de pedidos a líneas -> ids de producto vendidos (sin repetir)
        System.out.println("flatMap:     " + Empresa.PEDIDOS.stream()
                .flatMap(p -> p.lineas().stream())
                .map(LineaPedido::producto)
                .distinct().sorted()
                .toList());

        // takeWhile / dropWhile (Java 9): sobre datos ORDENADOS
        List<Integer> salariosOrdenados = emp.stream().map(e -> (int) e.salario()).sorted().toList();
        System.out.println("ordenados:   " + salariosOrdenados);
        System.out.println("takeWhile:   " + salariosOrdenados.stream().takeWhile(s -> s < 2000).toList());
        System.out.println("dropWhile:   " + salariosOrdenados.stream().dropWhile(s -> s < 4000).toList());

        // peek: para depurar (no para cambiar datos)
        long n = emp.stream()
                .filter(e -> e.departamento() == null)
                .peek(e -> System.out.println("peek:        sin departamento -> " + e.nombre()))
                .count();
        System.out.println("count:       " + n);

        // mapMulti (Java 16): cada elemento puede producir 0, 1 o varios resultados
        List<String> contactos = Empresa.CLIENTES.stream()
                .<String>mapMulti((c, salida) -> {
                    if (c.comercial() != null && c.limiteCredito() >= 15000) {
                        salida.accept(c.nombre());
                        salida.accept("  comercial " + c.comercial());
                    }
                })
                .toList();
        System.out.println("mapMulti:    " + contactos);

        // mapToInt / mapToDouble / boxed: pasar a streams primitivos y volver
        System.out.println("mapToDouble: " + emp.stream().mapToDouble(Empleado::salario).sum());
        System.out.println("boxed:       " + Stream.of("a", "bb", "ccc").mapToInt(String::length).boxed().toList());
    }
}
filter/map:  [Raquel, Iván, Sara]
distinct:    [ADMINISTRATIVO, ANALISTA, BECARIO, CONTABLE, DIRECTOR, DIRECTOR GENERAL, DISEÑADOR, OPERARIO, PROGRAMADOR, TÉCNICO SISTEMAS, VENDEDOR]
top 3:       [Ana 6500.0, Marta 5000.0, Luis 4800.0]
página 2:    [105, 110, 111, 112, 113]
flatMap:     [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 15, 16, 17, 18, 19, 20]
ordenados:   [900, 1600, 1600, 1650, 1700, 1750, 1900, 2100, 2200, 2300, 2300, 2400, 2500, 2600, 2600, 2700, 2800, 3500, 4000, 4200, 4300, 4800, 5000, 6500]
takeWhile:   [900, 1600, 1600, 1650, 1700, 1750, 1900]
dropWhile:   [4000, 4200, 4300, 4800, 5000, 6500]
peek:        sin departamento -> Tomás
count:       1
mapMulti:    [Construcciones Levante S.A.,   comercial 110, Hotel Mar Azul S.L.,   comercial 111, Instituto Tecnológico Sur,   comercial 112]
mapToDouble: 67900.0
boxed:       [1, 2, 3]
Detalles a observar:
flatMapconvierte unStream<Pedido>en unStream<LineaPedido>: cada pedido aporta todas sus líneas. Es el equivalente a un JOIN entre pedidos y líneas. Ningún pedido vendió el producto 14 (el altavoz descatalogado): no aparece en la lista.skip+limites exactamente la paginación de SQL (OFFSET 5 ROWS FETCH NEXT 5 ROWS ONLY).takeWhileydropWhilesolo tienen sentido sobre datos ordenados respecto a la condición:takeWhile(s -> s < 2000)para en el primer salario que no cumple, aunque más adelante hubiera alguno menor.mapMulties una alternativa aflatMapcuando cada elemento produce pocos resultados: evita crear un stream intermedio por elemento. El testigo de tipo<String>mapMultiayuda al compilador.peekestá pensado para depurar. No lo uses para modificar datos o para efectos importantes: si la operación terminal no necesita recorrer todos los elementos (comocount()sobre un stream cuyo tamaño se conoce sin recorrerlo, desde Java 9), la biblioteca puede omitirlo.
5. Operaciones terminales
| Operación | Devuelve | Qué hace |
|---|---|---|
forEach(Consumer) / forEachOrdered | void | Ejecuta una acción por elemento |
collect(Collector) | Lo que construya el colector | La más versátil (sección 7) |
toList() (Java 16) | List<T> inmutable | Atajo para recoger en una lista |
toArray() / toArray(String[]::new) | Array | |
reduce(identidad, op) | T | Combina todos los elementos en uno |
reduce(op) | Optional<T> | Igual, sin identidad (el stream puede estar vacío) |
reduce(identidad, acumulador, combinador) | U | Cuando el resultado es de otro tipo |
count() | long | Número de elementos |
min(Comparator), max(Comparator) | Optional<T> | Mínimo y máximo |
anyMatch, allMatch, noneMatch | boolean | ¿Alguno/todos/ninguno cumple? (cortocircuito) |
findFirst(), findAny() | Optional<T> | El primero / uno cualquiera (más eficiente en paralelo) |
sum(), average(), summaryStatistics() | Solo en streams primitivos | Sección 6 |
import java.util.Arrays;
import java.util.Comparator;
import java.util.DoubleSummaryStatistics;
import java.util.IntSummaryStatistics;
import java.util.List;
import java.util.Optional;

public class Terminales {
    public static void main(String[] args) {
        List<Empleado> emp = Empresa.EMPLEADOS;
        List<Producto> prod = Empresa.PRODUCTOS;

        // forEach
        System.out.print("forEach:     ");
        emp.stream().filter(e -> e.departamento() != null && e.departamento() == 40)
                .forEach(e -> System.out.print(e.nombre() + " "));
        System.out.println();

        // count, min, max
        System.out.println("count:       " + prod.stream().filter(p -> p.stock() == 0).count() + " productos sin stock");
        Optional<Producto> masCaro = prod.stream().max(Comparator.comparingDouble(Producto::precio));
        Optional<Producto> masBarato = prod.stream().min(Comparator.comparingDouble(Producto::precio));
        System.out.println("max / min:   " + masCaro.map(Producto::nombre).orElse("-") + " / "
                + masBarato.map(Producto::nombre).orElse("-"));

        // anyMatch, allMatch, noneMatch (cortocircuito)
        System.out.println("anyMatch:    ¿algún becario? " + emp.stream().anyMatch(e -> e.oficio().equals("BECARIO")));
        System.out.println("allMatch:    ¿todos > 800 €? " + emp.stream().allMatch(e -> e.salario() > 800));
        System.out.println("noneMatch:   ¿ninguno > 7000 €? " + emp.stream().noneMatch(e -> e.salario() > 7000));

        // findFirst / findAny
        System.out.println("findFirst:   " + emp.stream().filter(e -> e.oficio().equals("ANALISTA")).findFirst()
                .map(Empleado::nombre).orElseThrow());

        // reduce: tres formas
        int sumaStock = prod.stream().map(Producto::stock).reduce(0, Integer::sum);             // identidad + operación
        Optional<String> nombreMasLargo = prod.stream().map(Producto::nombre)
                .reduce((a, b) -> a.length() >= b.length() ? a : b);                            // sin identidad: Optional
        double valorInventario = prod.stream().reduce(0.0,
                (acc, p) -> acc + p.precio() * p.stock(), Double::sum);                         // con combinador
        System.out.println("reduce:      stock total=" + sumaStock + ", nombre más largo=" + nombreMasLargo.orElse("")
                + String.format(", valor del inventario=%.2f €", valorInventario));

        // toList, toArray
        List<String> nombres = emp.stream().map(Empleado::nombre).limit(4).toList();
        String[] array = emp.stream().map(Empleado::nombre).limit(4).toArray(String[]::new);
        System.out.println("toList:      " + nombres + "  toArray: " + Arrays.toString(array));

        // Estadísticas con streams primitivos
        IntSummaryStatistics st = prod.stream().mapToInt(Producto::stock).summaryStatistics();
        System.out.println("stock:       " + st);
        DoubleSummaryStatistics sal = emp.stream().mapToDouble(Empleado::salario).summaryStatistics();
        System.out.printf("salarios:    n=%d min=%.0f max=%.0f media=%.2f suma=%.0f%n",
                sal.getCount(), sal.getMin(), sal.getMax(), sal.getAverage(), sal.getSum());
        System.out.println("average:     " + emp.stream().mapToDouble(Empleado::salario).average().orElse(0));
    }
}
forEach:     Pedro Isabel Jorge
count:       2 productos sin stock
max / min:   Torre Workstation / Ratón inalámbrico
anyMatch:    ¿algún becario? true
allMatch:    ¿todos > 800 €? true
noneMatch:   ¿ninguno > 7000 €? true
findFirst:   Pablo
reduce:      stock total=688, nombre más largo=Portátil UltraBook 14, valor del inventario=140701,00 €
toList:      [Ana, Luis, Marta, Pedro]  toArray: [Ana, Luis, Marta, Pedro]
stock:       IntSummaryStatistics{count=20, sum=688, min=0, average=34,400000, max=200}
salarios:    n=24 min=900 max=6500 media=2829,17 suma=67900
average:     2829.1666666666665
5.1. Las tres formas de reduce
reduce combina todos los elementos en un único valor aplicando repetidamente una operación asociativa:
reduce(0, Integer::sum) sobre [25, 10, 40]: ((0 + 25) + 10) + 40 = 75
- Con identidad (
0para la suma,1para el producto,""para concatenar), devuelve directamente el valor: si el stream está vacío, devuelve la identidad. - Sin identidad, devuelve un
Optional, porque un stream vacío no tiene resultado. - Con tres argumentos, el acumulador puede cambiar de tipo (aquí, de
ProductoaDouble) y el combinador une resultados parciales cuando el stream es paralelo.
💡 Consejo: Para sumar, contar o calcular máximos,
reducefunciona, pero existen operaciones más claras y eficientes:mapToInt(...).sum(),count(),max(...). Reservareducepara combinaciones propias (como “el nombre más largo”).
⚠️ Importante:
allMatchsobre un stream vacío devuelvetrue(no hay ningún elemento que incumpla) yanyMatchdevuelvefalse. Es lógica matemática correcta, pero sorprende: si “todos los pedidos están entregados” debe ser falso cuando no hay pedidos, compruébalo aparte.
6. Streams primitivos y estadísticas
IntStream, LongStream y DoubleStream trabajan con primitivos, sin autoboxing, y añaden operaciones numéricas:
| Operación | Ejemplo |
|---|---|
| Crear | IntStream.range(0, 10), Arrays.stream(int[]), "texto".chars() |
| Desde objetos | empleados.stream().mapToDouble(Empleado::salario) |
| Hacia objetos | intStream.boxed() (a Stream<Integer>), mapToObj(i -> ...) |
| Entre primitivos | asDoubleStream(), asLongStream() |
| Totales | sum(), average() (devuelve OptionalDouble), min(), max() |
| Todo a la vez | summaryStatistics() → IntSummaryStatistics, DoubleSummaryStatistics |
summaryStatistics() calcula en una sola pasada el número de elementos, la suma, el mínimo, el máximo y la media (lo has visto en Terminales):
stock:       IntSummaryStatistics{count=20, sum=688, min=0, average=34,400000, max=200}
salarios:    n=24 min=900 max=6500 media=2829,17 suma=67900
⚠️ Importante: No confundas
Stream<Integer>conIntStream.Stream.of(1, 2, 3)es unStream<Integer>(sinsum()), mientras queIntStream.of(1, 2, 3)es unIntStream. YArrays.asList(new int[]{1, 2})es unaList<int[]>de un solo elemento, no una lista de enteros: usaArrays.stream(int[])oIntStream.of(...).
7. Colectores
📘 Concepto: Un colector (
Collector) es una receta para acumular los elementos de un stream en un resultado: una lista, un mapa, un texto, una estadística… Se pasa acollect(...). La claseCollectorstrae decenas ya hechos que se pueden anidar para construir resultados complejos, igual que en SQL anidas funciones de agregación dentro de unGROUP BY.
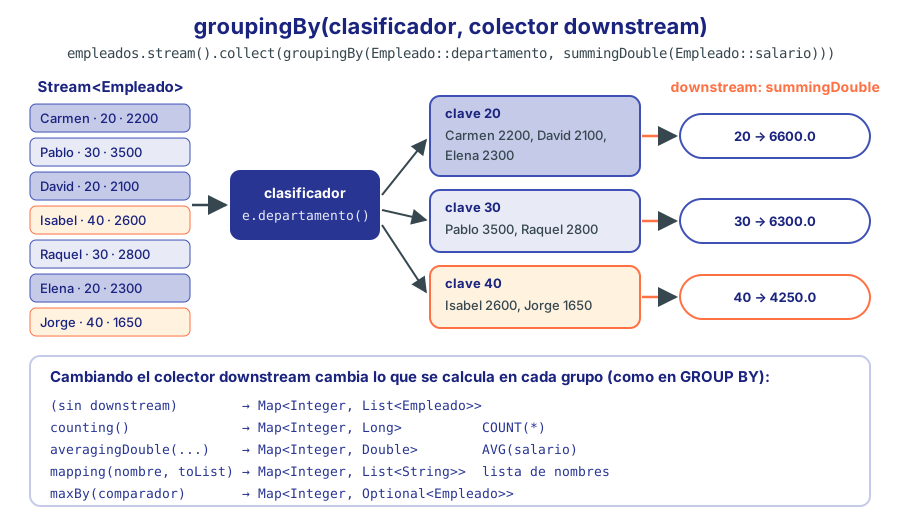
Figura 2. groupingBy reparte los elementos en grupos; el colector *downstream decide qué se calcula en cada grupo (aquí, con algunos empleados de ejemplo).*
| Colector | Resultado | Equivalente SQL / idea |
|---|---|---|
toList(), toSet(), toCollection(TreeSet::new) | Colección | |
toUnmodifiableList(), toUnmodifiableSet() | Colección inmutable | |
toMap(clave, valor) | Map (falla con claves repetidas) | |
toMap(clave, valor, fusión) | Map resolviendo duplicados | |
toMap(clave, valor, fusión, TreeMap::new) | El tipo de mapa que quieras | |
joining(sep, prefijo, sufijo) | String | STRING_AGG / LISTAGG |
groupingBy(clasificador) | Map<K, List<T>> | GROUP BY |
groupingBy(clasificador, downstream) | Map<K, R> | GROUP BY con agregado |
groupingBy(clasificador, TreeMap::new, downstream) | Mapa ordenado por clave | GROUP BY ... ORDER BY |
partitioningBy(predicado[, downstream]) | Map<Boolean, ...> (siempre con true y false) | GROUP BY CASE WHEN ... |
counting() | Long | COUNT(*) |
summingInt/Long/Double(f) | Suma | SUM(...) |
averagingInt/Long/Double(f) | Double | AVG(...) |
minBy(cmp), maxBy(cmp) | Optional<T> | MIN, MAX (del objeto entero) |
summarizingDouble(f) | DoubleSummaryStatistics | Todo a la vez |
mapping(f, downstream) | Transforma antes de acumular | |
filtering(p, downstream) (Java 9) | Filtra dentro de cada grupo | COUNT(CASE WHEN ...) |
flatMapping(f, downstream) (Java 9) | Aplana dentro de cada grupo | |
collectingAndThen(c, f) | Aplica f al resultado final | |
teeing(c1, c2, combinador) (Java 12) | Combina dos colectores en una pasada | |
reducing(...) | Reducción como colector |
import java.util.Comparator;
import java.util.DoubleSummaryStatistics;
import java.util.List;
import java.util.Map;
import java.util.Optional;
import java.util.Set;
import java.util.TreeMap;
import java.util.function.Function;

import static java.util.stream.Collectors.*;

public class Colectores {
    public static void main(String[] args) {
        List<Empleado> emp = Empresa.EMPLEADOS;

        // toList / toSet / toCollection
        Set<String> oficios = emp.stream().map(Empleado::oficio).collect(toSet());
        System.out.println("toSet: " + oficios.size() + " oficios distintos");
        System.out.println("toCollection(TreeSet): " + emp.stream().map(Empleado::oficio)
                .collect(toCollection(java.util.TreeSet::new)));

        // toMap: clave -> valor (¡cuidado con las claves duplicadas!)
        Map<Integer, String> porId = emp.stream().filter(e -> e.id() < 104)
                .collect(toMap(Empleado::id, Empleado::nombre));
        System.out.println("toMap: " + new TreeMap<>(porId));
        Map<String, Double> maxPorOficio = emp.stream()
                .collect(toMap(Empleado::oficio, Empleado::salario, Math::max, TreeMap::new));  // fusión + mapa
        System.out.println("toMap con fusión: " + maxPorOficio);
        Map<Integer, Empleado> indice = emp.stream().collect(toMap(Empleado::id, Function.identity()));
        System.out.println("índice por id, 121 -> " + indice.get(121).nombre());

        // joining
        System.out.println("joining: " + emp.stream().filter(e -> Integer.valueOf(30).equals(e.departamento()))
                .map(Empleado::nombre).collect(joining(", ", "Informática: [", "]")));

        // groupingBy: el "GROUP BY" de los streams
        Map<String, List<Empleado>> porOficio = emp.stream().collect(groupingBy(Empleado::oficio));
        System.out.println("groupingBy -> VENDEDOR: " + porOficio.get("VENDEDOR").stream().map(Empleado::nombre).toList());

        // groupingBy con colector "downstream"
        Map<String, Long> cuantosPorOficio = emp.stream().collect(groupingBy(Empleado::oficio, TreeMap::new, counting()));
        System.out.println("counting: " + cuantosPorOficio);

        Map<String, Double> masaPorDep = emp.stream().filter(e -> e.departamento() != null)
                .collect(groupingBy(e -> Empresa.NOMBRE_DEPARTAMENTO.get(e.departamento()), TreeMap::new,
                        summingDouble(Empleado::salario)));
        System.out.println("summingDouble: " + masaPorDep);

        Map<String, Double> mediaPorDep = emp.stream().filter(e -> e.departamento() != null)
                .collect(groupingBy(e -> Empresa.NOMBRE_DEPARTAMENTO.get(e.departamento()), TreeMap::new,
                        averagingDouble(Empleado::salario)));
        mediaPorDep.forEach((d, m) -> System.out.printf("  averagingDouble %-13s %8.2f%n", d, m));

        Map<Integer, List<String>> nombresPorDep = emp.stream().filter(e -> e.departamento() != null)
                .collect(groupingBy(Empleado::departamento, TreeMap::new, mapping(Empleado::nombre, toList())));
        System.out.println("mapping: " + nombresPorDep);

        Map<Integer, Optional<Empleado>> mejorPagado = emp.stream().filter(e -> e.departamento() != null)
                .collect(groupingBy(Empleado::departamento, TreeMap::new, maxBy(Comparator.comparingDouble(Empleado::salario))));
        System.out.print("maxBy: ");
        mejorPagado.forEach((d, e) -> System.out.print(d + "=" + e.map(Empleado::nombre).orElse("-") + " "));
        System.out.println();

        // Agrupación de dos niveles: departamento -> oficio -> número
        Map<Integer, Map<String, Long>> dosNiveles = emp.stream().filter(e -> e.departamento() != null)
                .collect(groupingBy(Empleado::departamento, TreeMap::new, groupingBy(Empleado::oficio, TreeMap::new, counting())));
        System.out.println("dos niveles: " + dosNiveles);

        // filtering / flatMapping (Java 9) dentro de groupingBy
        Map<Integer, List<String>> conComision = emp.stream().filter(e -> e.departamento() != null)
                .collect(groupingBy(Empleado::departamento, TreeMap::new,
                        filtering(e -> e.comision() != null && e.comision() > 0, mapping(Empleado::nombre, toList()))));
        System.out.println("filtering: " + conComision);

        // partitioningBy: dos grupos, true y false
        Map<Boolean, Long> mileuristas = emp.stream().collect(partitioningBy(e -> e.salario() < 2000, counting()));
        System.out.println("partitioningBy (< 2000 €): " + mileuristas);

        // summarizingDouble: todas las estadísticas a la vez
        DoubleSummaryStatistics st = emp.stream().collect(summarizingDouble(Empleado::salario));
        System.out.printf("summarizing: media %.2f, máx %.0f%n", st.getAverage(), st.getMax());

        // collectingAndThen: transformar el resultado final
        List<String> inmutable = emp.stream().map(Empleado::nombre).limit(3)
                .collect(collectingAndThen(toList(), java.util.Collections::unmodifiableList));
        System.out.println("collectingAndThen: " + inmutable);

        // teeing (Java 12): dos colectores a la vez y se combinan sus resultados
        String rango = emp.stream().collect(teeing(
                minBy(Comparator.comparingDouble(Empleado::salario)),
                maxBy(Comparator.comparingDouble(Empleado::salario)),
                (min, max) -> min.orElseThrow().nombre() + " (" + min.orElseThrow().salario() + ") .. "
                        + max.orElseThrow().nombre() + " (" + max.orElseThrow().salario() + ")"));
        System.out.println("teeing: " + rango);
        double media = emp.stream().map(Empleado::salario).collect(teeing(
                summingDouble(Double::doubleValue), counting(), (suma, n) -> suma / n));
        System.out.printf("teeing media: %.2f%n", media);
    }
}
toSet: 11 oficios distintos
toCollection(TreeSet): [ADMINISTRATIVO, ANALISTA, BECARIO, CONTABLE, DIRECTOR, DIRECTOR GENERAL, DISEÑADOR, OPERARIO, PROGRAMADOR, TÉCNICO SISTEMAS, VENDEDOR]
toMap: {100=Ana, 101=Luis, 102=Marta, 103=Pedro}
toMap con fusión: {ADMINISTRATIVO=1750.0, ANALISTA=3500.0, BECARIO=900.0, CONTABLE=2600.0, DIRECTOR=5000.0, DIRECTOR GENERAL=6500.0, DISEÑADOR=2300.0, OPERARIO=1600.0, PROGRAMADOR=2800.0, TÉCNICO SISTEMAS=2500.0, VENDEDOR=2300.0}
índice por id, 121 -> Raquel
joining: Informática: [Marta, Pablo, Raquel, Iván, Sara, Hugo]
groupingBy -> VENDEDOR: [Carmen, David, Elena, Sergio]
counting: {ADMINISTRATIVO=3, ANALISTA=2, BECARIO=1, CONTABLE=1, DIRECTOR=5, DIRECTOR GENERAL=1, DISEÑADOR=1, OPERARIO=2, PROGRAMADOR=3, TÉCNICO SISTEMAS=1, VENDEDOR=4}
summingDouble: {CONTABILIDAD=8450.0, DIRECCIÓN=6500.0, INFORMÁTICA=18800.0, LOGÍSTICA=8950.0, MARKETING=9300.0, VENTAS=15000.0}
  averagingDouble CONTABILIDAD   2816,67
  averagingDouble DIRECCIÓN      6500,00
  averagingDouble INFORMÁTICA    3133,33
  averagingDouble LOGÍSTICA      2237,50
  averagingDouble MARKETING      3100,00
  averagingDouble VENTAS         2500,00
mapping: {10=[Ana], 20=[Luis, Carmen, David, Elena, Sergio, Lucía], 30=[Marta, Pablo, Raquel, Iván, Sara, Hugo], 40=[Pedro, Isabel, Jorge], 50=[Laura, Nuria, Álvaro], 60=[Javier, Rosa, Manuel, Cristina]}
maxBy: 10=Ana 20=Luis 30=Marta 40=Pedro 50=Laura 60=Javier
dos niveles: {10={DIRECTOR GENERAL=1}, 20={ADMINISTRATIVO=1, DIRECTOR=1, VENDEDOR=4}, 30={ANALISTA=1, DIRECTOR=1, PROGRAMADOR=3, TÉCNICO SISTEMAS=1}, 40={ADMINISTRATIVO=1, CONTABLE=1, DIRECTOR=1}, 50={ANALISTA=1, DIRECTOR=1, DISEÑADOR=1}, 60={ADMINISTRATIVO=1, DIRECTOR=1, OPERARIO=2}}
filtering: {10=[], 20=[Carmen, David, Elena], 30=[], 40=[], 50=[], 60=[]}
partitioningBy (< 2000 €): {false=17, true=7}
summarizing: media 2829,17, máx 6500
collectingAndThen: [Ana, Luis, Marta]
teeing: Tomás (900.0) .. Ana (6500.0)
teeing media: 2829,17
Puntos importantes:
toMapcon claves repetidas lanza excepción (sección 10). Si pueden repetirse, pasa la función de fusión (Math::maxen el ejemplo, para quedarse con el salario más alto de cada oficio).groupingBysin mapa explícito usa unHashMap: el orden de las claves no está garantizado. PasaTreeMap::newsi quieres las claves ordenadas, como en casi todos los ejemplos.filteringfrente afilter: confilterantes de agrupar, los departamentos sin empleados con comisión desaparecerían del resultado; confilteringdentro delgroupingByaparecen con una lista vacía (como unLEFT JOINfrente a unINNER JOIN).partitioningBysiempre devuelve las dos claves,trueyfalse, aunque una tenga cero elementos.teeingrecorre el stream una sola vez y alimenta a dos colectores a la vez, combinando sus resultados al final. Antes había que recorrer dos veces o escribir un colector propio.
💡 Consejo: Con
import static java.util.stream.Collectors.*;las expresiones se leen mucho mejor:groupingBy(Empleado::oficio, counting())en lugar deCollectors.groupingBy(Empleado::oficio, Collectors.counting()).
8. Stream gatherers (Java 24)
📘 Concepto: Un gatherer (JEP 485, definitivo en Java 24) es una operación intermedia personalizable, igual que un colector es una operación terminal personalizable. Se aplica con
stream.gather(gatherer)y puede tener estado, emitir cero, uno o muchos elementos por cada entrada, parar el stream antes de tiempo y emitir elementos al final. Resuelve problemas que antes no tenían solución elegante con streams: agrupar en ventanas, acumulados parciales, deduplicar consecutivos…
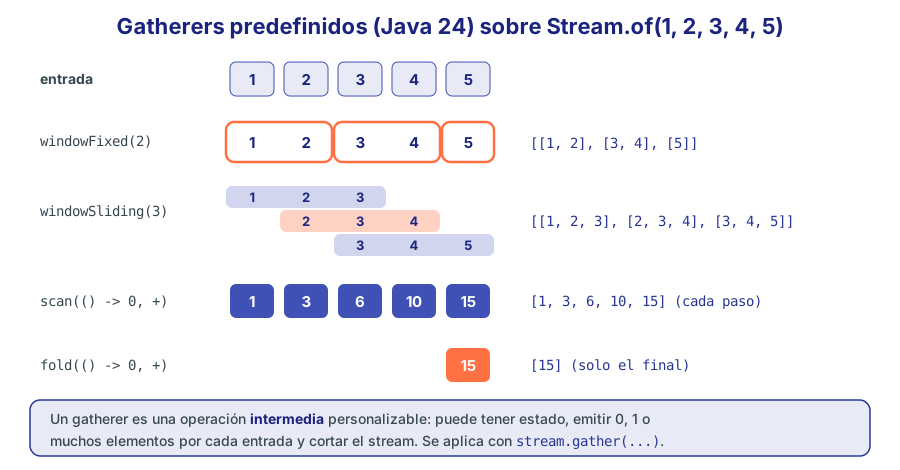
Figura 3. Los *gatherers predefinidos de la clase Gatherers.*
| Gatherer | Qué emite |
|---|---|
Gatherers.windowFixed(n) | Listas de n elementos consecutivos (la última puede ser más corta) |
Gatherers.windowSliding(n) | Ventanas deslizantes de n elementos que se solapan |
Gatherers.scan(inicial, f) | El acumulado tras cada elemento |
Gatherers.fold(inicial, f) | Un único elemento con el resultado final |
Gatherers.mapConcurrent(máx, f) | Aplica f en hilos virtuales, con un máximo de tareas simultáneas, conservando el orden |
8.1. Escribir un gatherer propio
Un Gatherer<T, A, R> (entrada T, estado A, salida R) se compone de hasta cuatro funciones:
| Parte | Tipo | Cuándo se ejecuta |
|---|---|---|
| Inicializador | Supplier<A> | Al empezar: crea el estado |
| Integrador | (estado, elemento, salida) -> boolean | Con cada elemento. Puede emitir con salida.push(r). Devuelve false para parar el stream |
| Combinador | (estado1, estado2) -> estado | Solo en paralelo, para unir estados |
| Finalizador | (estado, salida) -> void | Al acabar: puede emitir lo que quede pendiente |
Se construyen con Gatherer.of(...) (paralelizable) o Gatherer.ofSequential(...) (solo secuencial, más sencillo).
import java.util.ArrayList;
import java.util.List;
import java.util.stream.Gatherer;
import java.util.stream.Gatherers;
import java.util.stream.Stream;

public class Recolectores {

    /**
     * Gatherer propio: agrupa elementos consecutivos en lotes cuya suma no supere un máximo
     * (por ejemplo, repartir pedidos en camiones con una capacidad).
     */
    static Gatherer<Double, ?, List<Double>> lotesHasta(double maximo) {
        class Estado {                                        // estado privado del gatherer
            List<Double> actual = new ArrayList<>();
            double suma = 0;
        }
        return Gatherer.ofSequential(
                Estado::new,                                  // 1. inicializador
                (estado, elemento, salida) -> {               // 2. integrador: se llama con cada elemento
                    if (estado.suma + elemento > maximo && !estado.actual.isEmpty()) {
                        salida.push(estado.actual);           // emite el lote lleno
                        estado.actual = new ArrayList<>();
                        estado.suma = 0;
                    }
                    estado.actual.add(elemento);
                    estado.suma += elemento;
                    return true;                              // true = seguir recibiendo elementos
                },
                (estado, salida) -> {                         // 3. finalizador: emite el último lote
                    if (!estado.actual.isEmpty()) salida.push(estado.actual);
                });
    }

    /** Gatherer sin estado: como map + filter a la vez (descarta los null). */
    static <T, R> Gatherer<T, ?, R> mapearNoNulos(java.util.function.Function<T, R> f) {
        return Gatherer.of((_, elemento, salida) -> {
            R r = f.apply(elemento);
            return r == null || salida.push(r);               // push devuelve false si ya no se quieren más
        });
    }

    public static void main(String[] args) {
        List<Double> totales = Empresa.PEDIDOS.stream().limit(8)
                .map(p -> Math.round(p.total() * 100) / 100.0).toList();
        System.out.println("Totales:        " + totales);

        // windowFixed: grupos de tamaño fijo
        System.out.println("windowFixed(3): " + totales.stream().gather(Gatherers.windowFixed(3)).toList());

        // windowSliding: ventanas que se solapan -> media móvil de 3 pedidos
        List<String> mediaMovil = totales.stream()
                .gather(Gatherers.windowSliding(3))
                .map(v -> String.format("%.0f", v.stream().mapToDouble(Double::doubleValue).average().orElse(0)))
                .toList();
        System.out.println("media móvil 3:  " + mediaMovil);

        // scan: acumulado tras cada elemento
        System.out.println("scan:           " + Stream.of(1, 2, 3, 4, 5).gather(Gatherers.scan(() -> 0, Integer::sum)).toList());

        // fold: un único resultado final (como reduce, pero el tipo del acumulador puede ser otro)
        String concatenado = Stream.of(5001, 5002, 5003)
                .gather(Gatherers.fold(() -> "Pedidos:", (acc, id) -> acc + " #" + id))
                .findFirst().orElseThrow();
        System.out.println("fold:           " + concatenado);

        // mapConcurrent: aplica la función en hilos virtuales, con un máximo de tareas a la vez
        List<String> resultados = Stream.of(1, 2, 3, 4)
                .gather(Gatherers.mapConcurrent(2, n -> "tarea" + n + "@" + (Thread.currentThread().isVirtual() ? "virtual" : "plataforma")))
                .toList();
        System.out.println("mapConcurrent:  " + resultados);

        // Gatherers propios
        System.out.println("lotes ≤ 8000:   " + totales.stream().gather(lotesHasta(8_000)).toList());
        System.out.println("mapearNoNulos:  " + Empresa.EMPLEADOS.stream()
                .gather(mapearNoNulos(Empleado::comision)).toList());

        // Se pueden encadenar: andThen
        System.out.println("encadenados:    " + Stream.of(1, 2, 3, 4, 5, 6, 7, 8)
                .gather(Gatherers.<Integer>windowFixed(2).andThen(Gatherers.windowFixed(2))).toList());
    }
}
Totales:        [1802.9, 7402.5, 558.9, 6232.5, 936.0, 439.2, 2539.13, 798.0]
windowFixed(3): [[1802.9, 7402.5, 558.9], [6232.5, 936.0, 439.2], [2539.13, 798.0]]
media móvil 3:  [3255, 4731, 2576, 2536, 1305, 1259]
scan:           [1, 3, 6, 10, 15]
fold:           Pedidos: #5001 #5002 #5003
mapConcurrent:  [tarea1@virtual, tarea2@virtual, tarea3@virtual, tarea4@virtual]
lotes ≤ 8000:   [[1802.9], [7402.5, 558.9], [6232.5, 936.0, 439.2], [2539.13, 798.0]]
mapearNoNulos:  [500.0, 800.0, 300.0, 0.0]
encadenados:    [[[1, 2], [3, 4]], [[5, 6], [7, 8]]]
lotesHasta reparte los totales de los pedidos en lotes cuya suma no supere 8000 € (imagina camiones con una capacidad de carga), algo imposible con windowFixed porque el tamaño de cada lote depende de los valores. Su estado es una clase local (Estado) con el lote actual y su suma; el finalizador emite el último lote, que si no se perdería. mapearNoNulos no tiene estado: es map + filter en un solo paso. El parámetro _ (Java 22) indica que el integrador no usa el estado. Por último, andThen encadena gatherers: ventanas de 2 agrupadas a su vez de 2 en 2.
9. Streams paralelos
📘 Concepto: Con
.parallel()(ocoleccion.parallelStream()), la biblioteca divide el origen en trozos, los procesa en varios hilos del ForkJoinPool común y combina los resultados parciales. Es el modelo fork/join: divide y vencerás.
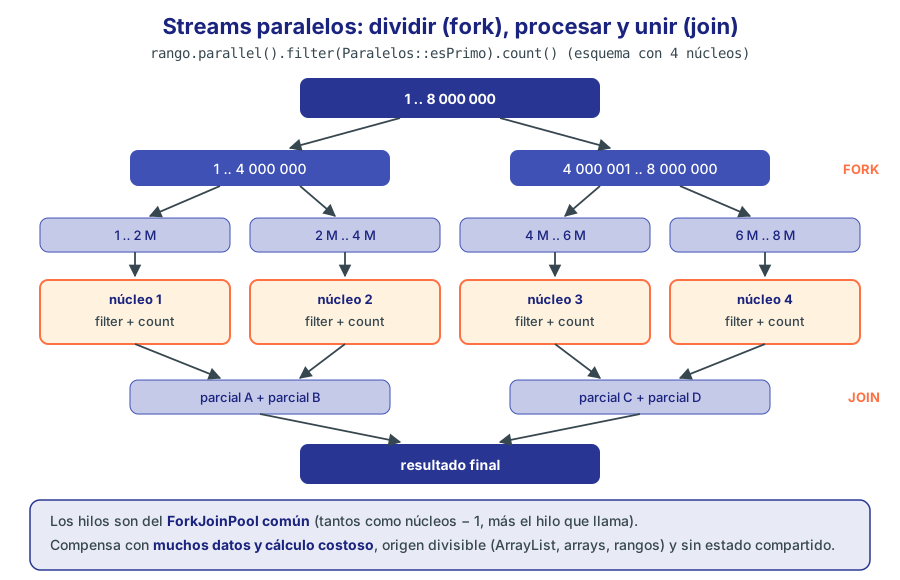
Figura 4. Ejecución de un *stream paralelo con el modelo fork/join.*
import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import java.util.concurrent.ForkJoinPool;
import java.util.stream.IntStream;
import java.util.stream.LongStream;

public class Paralelos {

    static boolean esPrimo(long n) {
        if (n < 2) return false;
        for (long d = 2; d * d <= n; d++) if (n % d == 0) return false;
        return true;
    }

    static long medir(Runnable r) {
        long t = System.nanoTime();
        r.run();
        return (System.nanoTime() - t) / 1_000_000;
    }

    public static void main(String[] args) {
        System.out.println("Núcleos disponibles: " + Runtime.getRuntime().availableProcessors()
                + ", paralelismo del pool común: " + ForkJoinPool.commonPool().getParallelism());

        // Calentamiento para que el JIT compile el código antes de medir
        for (int i = 0; i < 3; i++) LongStream.rangeClosed(1, 200_000).filter(Paralelos::esPrimo).count();

        long[] cuenta = new long[2];
        long secuencial = medir(() -> cuenta[0] = LongStream.rangeClosed(1, 3_000_000).filter(Paralelos::esPrimo).count());
        long paralelo = medir(() -> cuenta[1] = LongStream.rangeClosed(1, 3_000_000).parallel().filter(Paralelos::esPrimo).count());
        System.out.println("Primos hasta 3 millones: " + cuenta[0] + " = " + cuenta[1]);
        System.out.println("¿Paralelo más rápido en tarea de CPU? " + (paralelo < secuencial));

        // Tarea mínima: el paralelismo no compensa (coste de dividir y unir)
        long[] s = new long[2];
        for (int i = 0; i < 2_000; i++) {                       // calentamiento de ambas versiones
            s[0] += IntStream.range(0, 1_000).sum();
            s[1] += IntStream.range(0, 1_000).parallel().sum();
        }
        long secPequena = medir(() -> { for (int i = 0; i < 20_000; i++) s[0] += IntStream.range(0, 1_000).sum(); });
        long parPequena = medir(() -> { for (int i = 0; i < 20_000; i++) s[1] += IntStream.range(0, 1_000).parallel().sum(); });
        System.out.println("20000 sumas de 1000 números: secuencial " + secPequena + " ms, paralelo " + parPequena + " ms");
        System.out.println("¿Paralelo más rápido en tarea mínima? " + (parPequena < secPequena));

        // El orden: forEach no lo respeta en paralelo; forEachOrdered sí
        System.out.print("forEach paralelo:        ");
        IntStream.rangeClosed(1, 10).parallel().forEach(i -> System.out.print(i + " "));
        System.out.print("\nforEachOrdered paralelo: ");
        IntStream.rangeClosed(1, 10).parallel().forEachOrdered(i -> System.out.print(i + " "));
        System.out.println();

        // ERROR: efecto secundario sobre una lista no sincronizada
        List<Integer> mal = new ArrayList<>();
        try {
            IntStream.range(0, 100_000).parallel().forEach(mal::add);
            System.out.println("ArrayList compartida: " + mal.size() + " elementos (deberían ser 100000)");
        } catch (RuntimeException e) {
            System.out.println("ArrayList compartida: " + e.getClass().getSimpleName());
        }
        // BIEN: que el propio stream construya el resultado
        List<Integer> bien = IntStream.range(0, 100_000).parallel().boxed().toList();
        System.out.println("toList() en paralelo:  " + bien.size() + " elementos, en orden: " + bien.subList(0, 5));
        List<Integer> sincronizada = Collections.synchronizedList(new ArrayList<>());
        IntStream.range(0, 100_000).parallel().forEach(sincronizada::add);
        System.out.println("Lista sincronizada:    " + sincronizada.size() + " (correcto, pero con contención)");
    }
}
Núcleos disponibles: 8, paralelismo del pool común: 7
Primos hasta 3 millones: 216816 = 216816
¿Paralelo más rápido en tarea de CPU? true
20000 sumas de 1000 números: secuencial 109 ms, paralelo 6267 ms
¿Paralelo más rápido en tarea mínima? false
forEach paralelo:        7 10 1 3 9 6 8 2 5 4
forEachOrdered paralelo: 1 2 3 4 5 6 7 8 9 10
ArrayList compartida: 88368 elementos (deberían ser 100000)
toList() en paralelo:  100000 elementos, en orden: [0, 1, 2, 3, 4]
Lista sincronizada:    100000 (correcto, pero con contención)
Analiza la salida:
- Tarea de CPU costosa (comprobar primalidad de 3 millones de números): el paralelo es más rápido, y el resultado es idéntico.
- Tarea mínima (sumar mil números): dividir el trabajo, coordinar hilos y combinar cuesta más que el propio cálculo.
forEachen paralelo no respeta el orden;forEachOrderedsí (a costa de rendimiento).- El efecto secundario sobre un
ArrayListcompartido es un error grave: varios hilos añaden a la vez, se pisan y se pierden elementos (o salta una excepción, según la ejecución). La versión correcta deja que el stream construya el resultado (toList()), que además conserva el orden del origen.
| El paralelismo compensa cuando… | No compensa (o es peligroso) cuando… |
|---|---|
| Hay muchos elementos (decenas de miles o más) | Hay pocos elementos |
| Cada elemento exige cálculo intenso (CPU) | El trabajo por elemento es trivial |
El origen se divide bien: ArrayList, arrays, IntStream.range | El origen se divide mal: LinkedList, Stream.iterate, Files.lines |
| Las operaciones son sin estado y sin efectos secundarios | Hay sorted, distinct, limit o findFirst en orden (necesitan coordinación) |
| Las funciones son puras y la reducción es asociativa | Se modifica estado compartido o se hace E/S bloqueante |
| Tienes varios núcleos libres | En un servidor que ya usa todos los núcleos atendiendo peticiones |
⚠️ Importante: Todos los streams paralelos de la aplicación comparten el mismo
ForkJoinPoolcomún. Si una tarea se bloquea (esperando una consulta a la base de datos o una llamada HTTP), bloquea hilos que necesitan los demás. Para tareas de E/S no uses streams paralelos: usa hilos virtuales (Gatherers.mapConcurrento los executors del módulo 07).
💡 Consejo: La regla de oro: escribe primero la versión secuencial; añade
.parallel()solo si has medido que hay un problema de rendimiento y que el paralelo lo mejora. Para mediciones serias usa JMH (Java Microbenchmark Harness), noSystem.nanoTime()como en este ejemplo didáctico.
10. Errores comunes
import java.util.ArrayList;
import java.util.List;
import java.util.Map;
import java.util.stream.Collectors;
import java.util.stream.Stream;

public class Errores {
    public static void main(String[] args) {
        // 1. Reutilizar un stream
        Stream<String> s = Stream.of("a", "b", "c");
        System.out.println("primera vez: " + s.count());
        try {
            s.count();
        } catch (IllegalStateException e) {
            System.out.println("1. " + e.getMessage());
        }

        // 2. Modificar la fuente mientras se recorre
        List<Integer> numeros = new ArrayList<>(List.of(1, 2, 3, 4));
        try {
            numeros.stream().forEach(n -> { if (n == 2) numeros.add(99); });
        } catch (java.util.ConcurrentModificationException e) {
            System.out.println("2. ConcurrentModificationException al modificar la lista origen");
        }

        // 3. toMap con claves repetidas
        try {
            Map<String, Integer> m = Empresa.EMPLEADOS.stream()
                    .collect(Collectors.toMap(Empleado::oficio, e -> e.id()));
            System.out.println(m);
        } catch (IllegalStateException e) {
            System.out.println("3. " + e.getMessage());
        }

        // 4. toMap con valores null
        try {
            Empresa.EMPLEADOS.stream().collect(Collectors.toMap(Empleado::id, Empleado::comision));
        } catch (NullPointerException e) {
            System.out.println("4. toMap no admite valores null: NullPointerException");
        }

        // 5. Efectos secundarios en lugar de colectores
        List<String> resultado = new ArrayList<>();
        Empresa.EMPLEADOS.stream().filter(e -> e.salario() > 4500).forEach(e -> resultado.add(e.nombre())); // evitar
        List<String> mejor = Empresa.EMPLEADOS.stream().filter(e -> e.salario() > 4500).map(Empleado::nombre).toList();
        System.out.println("5. " + resultado + " = " + mejor + " (usa map + toList)");

        // 6. toList() devuelve una lista inmutable
        try {
            Stream.of(1, 2).toList().add(3);
        } catch (UnsupportedOperationException e) {
            System.out.println("6. Stream.toList() es inmutable: UnsupportedOperationException");
        }

        // 7. Olvidar la operación terminal: no pasa nada (y no hay error)
        Stream.of("x").peek(x -> System.out.println("esto no se imprime")).map(String::toUpperCase);
        System.out.println("7. Sin operación terminal no se ejecuta nada");
    }
}
primera vez: 3
1. stream has already been operated upon or closed
2. ConcurrentModificationException al modificar la lista origen
3. Duplicate key DIRECTOR (attempted merging values 101 and 102)
4. toMap no admite valores null: NullPointerException
5. [Ana, Luis, Marta] = [Ana, Luis, Marta] (usa map + toList)
6. Stream.toList() es inmutable: UnsupportedOperationException
7. Sin operación terminal no se ejecuta nada
| Error | Síntoma | Solución |
|---|---|---|
| Reutilizar un stream | IllegalStateException: stream has already been operated upon or closed | Crea un stream nuevo cada vez (guarda un Supplier<Stream<T>> si lo necesitas varias veces) |
| Modificar el origen mientras se recorre | ConcurrentModificationException | No modifiques la fuente; recoge el resultado y modifica después |
toMap con claves repetidas | IllegalStateException: Duplicate key | Función de fusión o groupingBy |
toMap con valores null | NullPointerException | Filtra los null o usa groupingBy/un bucle |
Efectos secundarios (forEach(lista::add)) | Código frágil; resultados erróneos en paralelo | map + toList() / collect |
Modificar el resultado de toList() | UnsupportedOperationException | collect(Collectors.toCollection(ArrayList::new)) si necesitas modificarla |
| Olvidar la operación terminal | No pasa nada, en silencio | Toda tubería termina en una operación terminal |
Stream infinito sin limit | El programa no termina (o OutOfMemoryError con sorted/collect) | limit, takeWhile o iterate con condición |
Files.lines sin cerrar | Fugas de descriptores de fichero | Try-with-resources |
| Excepciones comprobadas en lambdas | No compila | Envolver en UncheckedIOException (módulo 03) |
| Abusar de los streams | Tuberías de 15 pasos ilegibles | Extrae métodos con nombre; un bucle simple a veces es más claro |
11. Consultas sobre la base de datos EMPRESA
Para terminar, un repertorio de consultas reales con streams y su equivalente en SQL. Muchas te sonarán del Curso de Bases de Datos: compara los resultados.
import java.time.Year;
import java.util.Comparator;
import java.util.List;
import java.util.Map;
import java.util.Set;
import java.util.TreeMap;
import java.util.function.Function;
import java.util.stream.Collectors;

import static java.util.stream.Collectors.*;

/** Consultas sobre la base de datos EMPRESA resueltas con streams (y su SQL equivalente). */
public class ConsultasEmpresa {

    static final List<Empleado> EMP = Empresa.EMPLEADOS;
    static final List<Pedido> PED = Empresa.PEDIDOS;
    static final Map<Integer, Cliente> CLI = Empresa.CLIENTES.stream().collect(toMap(Cliente::id, Function.identity()));
    static final Map<Integer, Producto> PROD = Empresa.PRODUCTOS.stream().collect(toMap(Producto::id, Function.identity()));

    static void titulo(int n, String t) { System.out.println("\n" + n + ". " + t); }

    public static void main(String[] args) {
        // SELECT nombre, apellidos, salario FROM empleados WHERE salario > 4000 ORDER BY salario DESC
        titulo(1, "Empleados con salario > 4000, de mayor a menor");
        EMP.stream().filter(e -> e.salario() > 4000)
                .sorted(Comparator.comparingDouble(Empleado::salario).reversed())
                .forEach(e -> System.out.printf("   %-7s %-18s %6.0f%n", e.nombre(), e.apellidos(), e.salario()));

        // SELECT COUNT(*), AVG(salario) FROM empleados WHERE comision > 0
        titulo(2, "Vendedores con comisión: número y salario total medio");
        var conComision = EMP.stream().filter(e -> e.comision() != null && e.comision() > 0)
                .collect(summarizingDouble(Empleado::salarioTotal));
        System.out.printf("   %d empleados, media salario+comisión = %.2f%n", conComision.getCount(), conComision.getAverage());

        // SELECT d.nombre, COUNT(e.emp_id) FROM departamentos d LEFT JOIN empleados e ... GROUP BY d.nombre
        titulo(3, "Empleados por departamento (incluidos los vacíos, como un LEFT JOIN)");
        Map<Integer, Long> cuenta = EMP.stream().filter(e -> e.departamento() != null)
                .collect(groupingBy(Empleado::departamento, counting()));
        Empresa.DEPARTAMENTOS.forEach(d ->
                System.out.printf("   %-14s %d%n", d.nombre(), cuenta.getOrDefault(d.id(), 0L)));

        // SELECT oficio, MIN(salario), MAX(salario) FROM empleados GROUP BY oficio HAVING COUNT(*) > 1
        titulo(4, "Oficios con más de un empleado y su rango salarial (HAVING)");
        EMP.stream().collect(groupingBy(Empleado::oficio, TreeMap::new, summarizingDouble(Empleado::salario)))
                .entrySet().stream()
                .filter(en -> en.getValue().getCount() > 1)
                .forEach(en -> System.out.printf("   %-15s %d empleados, %5.0f - %5.0f%n", en.getKey(),
                        en.getValue().getCount(), en.getValue().getMin(), en.getValue().getMax()));

        // Empleados que ganan más que la media de su departamento (subconsulta correlacionada)
        titulo(5, "Empleados que ganan más que la media de su departamento");
        Map<Integer, Double> mediaDep = EMP.stream().filter(e -> e.departamento() != null)
                .collect(groupingBy(Empleado::departamento, averagingDouble(Empleado::salario)));
        EMP.stream().filter(e -> e.departamento() != null && e.salario() > mediaDep.get(e.departamento()))
                .forEach(e -> System.out.printf("   %-7s %5.0f > media %7.2f (%s)%n", e.nombre(), e.salario(),
                        mediaDep.get(e.departamento()), Empresa.NOMBRE_DEPARTAMENTO.get(e.departamento())));

        // Jefes y número de subordinados directos (autorrelación)
        titulo(6, "Jefes y número de subordinados directos");
        Map<Integer, String> nombrePorId = EMP.stream().collect(toMap(Empleado::id, Empleado::nombre));
        EMP.stream().filter(e -> e.jefe() != null)
                .collect(groupingBy(Empleado::jefe, TreeMap::new, counting()))
                .forEach((jefe, n) -> System.out.println("   " + nombrePorId.get(jefe) + " (" + jefe + "): " + n));

        // Antigüedad: altas por año
        titulo(7, "Altas por año (solo años con altas)");
        System.out.println("   " + EMP.stream().collect(groupingBy(e -> Year.from(e.fechaAlta()), TreeMap::new, counting())));

        // Total de cada pedido y los 5 mayores
        titulo(8, "Los 5 pedidos de mayor importe");
        PED.stream().sorted(Comparator.comparingDouble(Pedido::total).reversed()).limit(5)
                .forEach(p -> System.out.printf("   %d %-28s %10.2f €%n", p.id(), CLI.get(p.cliente()).nombre(), p.total()));

        // Facturación por estado del pedido
        titulo(9, "Facturación por estado");
        PED.stream().collect(groupingBy(Pedido::estado, TreeMap::new, summingDouble(Pedido::total)))
                .forEach((estado, total) -> System.out.printf("   %-10s %10.2f €%n", estado, total));

        // Facturación por cliente (solo pedidos no cancelados), ordenada
        titulo(10, "Top 5 clientes por facturación (sin cancelados)");
        PED.stream().filter(p -> !p.estado().equals("CANCELADO"))
                .collect(groupingBy(Pedido::cliente, summingDouble(Pedido::total)))
                .entrySet().stream()
                .sorted(Map.Entry.<Integer, Double>comparingByValue().reversed())
                .limit(5)
                .forEach(en -> System.out.printf("   %-30s %10.2f €%n", CLI.get(en.getKey()).nombre(), en.getValue()));

        // Unidades vendidas por producto (flatMap sobre las líneas)
        titulo(11, "Los 5 productos más vendidos en unidades");
        PED.stream().flatMap(p -> p.lineas().stream())
                .collect(groupingBy(LineaPedido::producto, summingInt(LineaPedido::cantidad)))
                .entrySet().stream()
                .sorted(Map.Entry.<Integer, Integer>comparingByValue().reversed().thenComparing(Map.Entry.comparingByKey()))
                .limit(5)
                .forEach(en -> System.out.printf("   %-24s %3d uds%n", PROD.get(en.getKey()).nombre(), en.getValue()));

        // Productos que nunca se han vendido (NOT IN)
        titulo(12, "Productos que nunca se han vendido");
        Set<Integer> vendidos = PED.stream().flatMap(p -> p.lineas().stream()).map(LineaPedido::producto).collect(toSet());
        Empresa.PRODUCTOS.stream().filter(p -> !vendidos.contains(p.id()))
                .forEach(p -> System.out.println("   " + p.nombre() + (p.descatalogado() ? " (descatalogado)" : "")));

        // Clientes sin pedidos (NOT EXISTS)
        titulo(13, "Clientes sin pedidos");
        Set<Integer> conPedidos = PED.stream().map(Pedido::cliente).collect(toSet());
        System.out.println("   " + Empresa.CLIENTES.stream().filter(c -> !conPedidos.contains(c.id())).map(Cliente::nombre).toList());

        // Ventas por comercial (empleado) y mes de 2026
        titulo(14, "Pedidos de 2026 por mes");
        System.out.println("   " + PED.stream().filter(p -> p.fecha().getYear() == 2026)
                .collect(groupingBy(p -> p.fecha().getMonth(), TreeMap::new, mapping(Pedido::id, toList()))));

        // Ticket medio por comercial con partitioningBy de pedidos online
        titulo(15, "Pedidos online (sin empleado) frente a pedidos de comercial");
        Map<Boolean, Double> online = PED.stream().collect(partitioningBy(p -> p.empleado() == null, averagingDouble(Pedido::total)));
        System.out.printf("   ticket medio online: %.2f €, con comercial: %.2f €%n", online.get(true), online.get(false));

        // Informe de texto con joining
        titulo(16, "Plantilla de INFORMÁTICA en una línea");
        System.out.println("   " + EMP.stream().filter(e -> Integer.valueOf(30).equals(e.departamento()))
                .sorted(Comparator.comparing(Empleado::apellidos))
                .map(e -> e.nombre() + " " + e.apellidos().split(" ")[0])
                .collect(Collectors.joining(" · ")));
    }
}
1. Empleados con salario > 4000, de mayor a menor
   Ana     García López         6500
   Marta   Sánchez Gil          5000
   Luis    Martínez Ruiz        4800
   Laura   Fernández Moreno     4300
   Pedro   Gómez Díaz           4200

2. Vendedores con comisión: número y salario total medio
   3 empleados, media salario+comisión = 2733,33

3. Empleados por departamento (incluidos los vacíos, como un LEFT JOIN)
   DIRECCIÓN      1
   VENTAS         6
   INFORMÁTICA    6
   CONTABILIDAD   3
   MARKETING      3
   LOGÍSTICA      4
   INVESTIGACIÓN  0

4. Oficios con más de un empleado y su rango salarial (HAVING)
   ADMINISTRATIVO  3 empleados,  1650 -  1750
   ANALISTA        2 empleados,  2700 -  3500
   DIRECTOR        5 empleados,  4000 -  5000
   OPERARIO        2 empleados,  1600 -  1600
   PROGRAMADOR     3 empleados,  2400 -  2800
   VENDEDOR        4 empleados,  1900 -  2300

5. Empleados que ganan más que la media de su departamento
   Luis     4800 > media 2500,00 (VENTAS)
   Marta    5000 > media 3133,33 (INFORMÁTICA)
   Pedro    4200 > media 2816,67 (CONTABILIDAD)
   Laura    4300 > media 3100,00 (MARKETING)
   Javier   4000 > media 2237,50 (LOGÍSTICA)
   Pablo    3500 > media 3133,33 (INFORMÁTICA)

6. Jefes y número de subordinados directos
   Ana (100): 5
   Luis (101): 5
   Marta (102): 3
   Pedro (103): 2
   Laura (104): 2
   Javier (105): 3
   Pablo (120): 3

7. Altas por año (solo años con altas)
   {2010=1, 2011=1, 2012=1, 2013=1, 2014=2, 2015=1, 2016=2, 2017=2, 2018=2, 2019=3, 2020=2, 2021=2, 2022=2, 2023=1, 2025=1}

8. Los 5 pedidos de mayor importe
   5010 Instituto Tecnológico Sur      11657,50 €
   5016 Instituto Tecnológico Sur       8945,05 €
   5002 Construcciones Levante S.A.     7402,50 €
   5004 Academia Nova                   6232,50 €
   5009 Construcciones Levante S.A.     4772,44 €

9. Facturación por estado
   CANCELADO      798,00 €
   ENTREGADO    54076,97 €
   ENVIADO       4125,69 €
   PENDIENTE     3414,80 €

10. Top 5 clientes por facturación (sin cancelados)
   Instituto Tecnológico Sur        20602,55 €
   Construcciones Levante S.A.      14260,19 €
   Academia Nova                     7891,30 €
   Talleres Martín S.L.              4704,15 €
   Hotel Mar Azul S.L.               4202,77 €

11. Los 5 productos más vendidos en unidades
   Monitor 24 FHD            40 uds
   Pack teclado y ratón      30 uds
   Portátil Básico 15        24 uds
   Portátil UltraBook 14     15 uds
   Teclado mecánico          15 uds

12. Productos que nunca se han vendido
   Altavoz Inteligente (descatalogado)

13. Clientes sin pedidos
   [Carlos Ibáñez Rey, Farmacia Central]

14. Pedidos de 2026 por mes
   {JANUARY=[5016], FEBRUARY=[5017], MARCH=[5018], APRIL=[5019], MAY=[5020], JUNE=[5021], JULY=[5022, 5023, 5024]}

15. Pedidos online (sin empleado) frente a pedidos de comercial
   ticket medio online: 249,30 €, con comercial: 2814,40 €

16. Plantilla de INFORMÁTICA en una línea
   Iván Castro · Raquel Molina · Pablo Moreno · Sara Ortiz · Hugo Rubio · Marta Sánchez
| Consulta | SQL | Streams |
|---|---|---|
| 1 | WHERE salario > 4000 ORDER BY salario DESC | filter + sorted(comparing...reversed()) |
| 2 | SELECT COUNT(*), AVG(salario + comision) | summarizingDouble |
| 3 | LEFT JOIN ... GROUP BY con departamentos vacíos | Recorrer DEPARTAMENTOS y getOrDefault(id, 0L) |
| 4 | GROUP BY oficio HAVING COUNT(*) > 1 | groupingBy y después filter sobre las entradas |
| 5 | Subconsulta correlacionada con AVG | Precalcular un mapa de medias y filtrar |
| 6 | Autorrelación empleados e JOIN empleados j | groupingBy(Empleado::jefe) + mapa de nombres |
| 8, 10 | ORDER BY total DESC FETCH FIRST 5 ROWS ONLY | sorted(...).limit(5) |
| 11 | JOIN lineas_pedido ... GROUP BY producto | flatMap + groupingBy + summingInt |
| 12, 13 | NOT IN / NOT EXISTS | Conjunto de ids + filter(!contains) |
| 15 | GROUP BY CASE WHEN empleado IS NULL | partitioningBy |
| 16 | LISTAGG / STRING_AGG | joining(" · ") |
📘 Concepto: Fíjate en la consulta 5: en SQL la subconsulta correlacionada recalcula la media por cada fila (aunque el optimizador lo mejore); con streams calculamos primero un
Mapcon la media de cada departamento y luego lo consultamos en O(1). Pensar en “precalcular un mapa” es una de las técnicas más útiles con streams.
💡 Consejo: ¿Significa esto que hay que cargar las tablas en memoria y consultarlas con streams? No: la base de datos está optimizada para filtrar, agrupar y ordenar millones de filas con índices, y solo debe viajar por la red lo que necesitas. Usa SQL (o JPQL, módulo 16) para consultar la base de datos, y streams para procesar lo que ya tienes en memoria: resultados de una consulta, datos de una API, ficheros…
12. Buenas prácticas
- Una operación por línea, alineadas: la tubería se lee de arriba abajo como una receta.
- Prefiere referencias a métodos y métodos con nombre (
filter(this::esMoroso)) a lambdas largas. - Las funciones que pasas a un stream deben ser puras: sin modificar variables externas.
- Usa
toList()(Java 16) para listas inmutables yCollectors.toCollection(ArrayList::new)si necesitas modificarla después. - Elige la operación más específica:
anyMatchmejor quefilter(...).findFirst().isPresent(),count()mejor quecollect(counting())en el nivel superior,mapToInt(...).sum()mejor quereduce. - Pon los filtros lo antes posible en la tubería: cuantos menos elementos lleguen a
sortedomap, menos trabajo. - No conviertas todos los bucles en streams: si necesitas
breakcomplejos, índices o modificar varias estructuras a la vez, un bucle puede ser más claro. - No uses
parallel()por defecto.
13. Ejercicios
Ejercicio 1: Ventas por categoría
Calcula el importe vendido por categoría de producto (con su nombre, de la tabla categorias) en los pedidos no cancelados, ordenado de mayor a menor, con el porcentaje que representa cada categoría sobre el total. Es el equivalente a un JOIN de cuatro tablas con GROUP BY.
Ver solución
import java.util.Comparator;
import java.util.Map;
import java.util.function.Function;
import java.util.stream.Collectors;

public class Ej1Categorias {

    // Tabla categorias de EMPRESA (id -> nombre)
    static final Map<Integer, String> CATEGORIAS = Map.ofEntries(
            Map.entry(1, "Informática"), Map.entry(2, "Portátiles"), Map.entry(3, "Ordenadores sobremesa"),
            Map.entry(4, "Periféricos"), Map.entry(5, "Ratones y teclados"), Map.entry(6, "Monitores"),
            Map.entry(7, "Electrónica"), Map.entry(8, "Telefonía"), Map.entry(9, "Audio"),
            Map.entry(10, "Oficina"), Map.entry(11, "Mobiliario"));

    public static void main(String[] args) {
        Map<Integer, Producto> productos = Empresa.PRODUCTOS.stream()
                .collect(Collectors.toMap(Producto::id, Function.identity()));

        // SELECT c.nombre, SUM(...) FROM pedidos JOIN lineas JOIN productos JOIN categorias
        //  WHERE estado <> 'CANCELADO' GROUP BY c.nombre ORDER BY 2 DESC
        Map<String, Double> ventasPorCategoria = Empresa.PEDIDOS.stream()
                .filter(p -> !p.estado().equals("CANCELADO"))
                .flatMap(p -> p.lineas().stream())
                .collect(Collectors.groupingBy(
                        l -> CATEGORIAS.get(productos.get(l.producto()).categoria()),
                        Collectors.summingDouble(LineaPedido::importe)));

        double total = ventasPorCategoria.values().stream().mapToDouble(Double::doubleValue).sum();
        ventasPorCategoria.entrySet().stream()
                .sorted(Map.Entry.<String, Double>comparingByValue(Comparator.reverseOrder()))
                .forEach(e -> System.out.printf("%-22s %10.2f €  %5.1f %%%n",
                        e.getKey(), e.getValue(), 100 * e.getValue() / total));
        System.out.printf("%-22s %10.2f €%n", "TOTAL", total);
    }
}
Portátiles               27337,25 €   44,4 %
Ordenadores sobremesa    11636,29 €   18,9 %
Monitores                 9063,45 €   14,7 %
Telefonía                 5033,73 €    8,2 %
Mobiliario                2940,00 €    4,8 %
Ratones y teclados        2202,84 €    3,6 %
Informática               1213,65 €    2,0 %
Electrónica                837,00 €    1,4 %
Periféricos                783,00 €    1,3 %
Audio                      570,25 €    0,9 %
TOTAL                    61617,46 €
Primero se precalcula un mapa id → Producto para que cada “join” sea una consulta O(1). Después, flatMap lleva de pedidos a líneas y groupingBy agrupa por el nombre de la categoría (línea → producto → id de categoría → nombre) sumando los importes. Para ordenar las entradas por valor descendente se usa comparingByValue(Comparator.reverseOrder()). Observa que el porcentaje necesita el total, así que se calcula en un segundo recorrido del mapa (pequeño), no del stream original.
Ejercicio 2: El informe del módulo 01 con streams
Reescribe el método Estadisticas.porDepartamento del proyecto Maven del módulo 01 (que usaba un TreeMap, bucles y acumuladores) con un único stream: agrupa los empleados de EMPRESA por nombre de departamento (ordenado) y construye directamente un record ResumenDepartamento(departamento, empleados, salarioMedio, masaSalarial, plantilla) por grupo con collectingAndThen.
Ver solución
import java.util.List;
import java.util.Map;
import java.util.TreeMap;

import static java.util.stream.Collectors.*;

public class Ej2Resumen {

    record ResumenDepartamento(String departamento, long empleados, double salarioMedio,
                               double masaSalarial, List<String> plantilla) {}

    static List<ResumenDepartamento> porDepartamento(List<Empleado> empleados) {
        Map<String, ResumenDepartamento> mapa = empleados.stream()
                .filter(e -> e.departamento() != null)
                .collect(groupingBy(e -> Empresa.NOMBRE_DEPARTAMENTO.get(e.departamento()), TreeMap::new,
                        collectingAndThen(toList(), lista -> new ResumenDepartamento(
                                Empresa.NOMBRE_DEPARTAMENTO.get(lista.getFirst().departamento()),
                                lista.size(),
                                Math.round(lista.stream().mapToDouble(Empleado::salario).average().orElse(0) * 100) / 100.0,
                                lista.stream().mapToDouble(Empleado::salario).sum(),
                                lista.stream().map(Empleado::nombre).toList()))));
        return List.copyOf(mapa.values());
    }

    public static void main(String[] args) {
        porDepartamento(Empresa.EMPLEADOS).forEach(r ->
                System.out.printf("%-13s %d emp. media %7.2f masa %8.0f %s%n", r.departamento(),
                        r.empleados(), r.salarioMedio(), r.masaSalarial(), r.plantilla()));
    }
}
CONTABILIDAD  3 emp. media 2816,67 masa     8450 [Pedro, Isabel, Jorge]
DIRECCIÓN     1 emp. media 6500,00 masa     6500 [Ana]
INFORMÁTICA   6 emp. media 3133,33 masa    18800 [Marta, Pablo, Raquel, Iván, Sara, Hugo]
LOGÍSTICA     4 emp. media 2237,50 masa     8950 [Javier, Rosa, Manuel, Cristina]
MARKETING     3 emp. media 3100,00 masa     9300 [Laura, Nuria, Álvaro]
VENTAS        6 emp. media 2500,00 masa    15000 [Luis, Carmen, David, Elena, Sergio, Lucía]
collectingAndThen(toList(), lista -> new ResumenDepartamento(...)) recoge cada grupo en una lista y la transforma en el record final. El becario Tomás, sin departamento, se filtra antes de agrupar (groupingBy no admite claves null: lanzaría NullPointerException). Una alternativa sin recorrer cada lista tres veces sería un colector propio o teeing anidados, pero para grupos pequeños prima la legibilidad.
Ejercicio 3: Antigüedad de la plantilla
Con fecha de referencia 4 de octubre de 2026, agrupa a los empleados en tres tramos de antigüedad (menos de 5 años, de 5 a 9, 10 o más) mostrando cuántos hay, su salario medio y sus nombres. Indica además el empleado más antiguo, la antigüedad media y cuántos tienen al menos un trienio (partitioningBy). Usa Period.between para calcular los años.
Ver solución
import java.time.LocalDate;
import java.time.Period;
import java.util.Comparator;
import java.util.List;
import java.util.Map;
import java.util.TreeMap;

import static java.util.stream.Collectors.*;

public class Ej3Antiguedad {

    static final LocalDate HOY = LocalDate.of(2026, 10, 4);

    static int anios(Empleado e) {
        return Period.between(e.fechaAlta(), HOY).getYears();
    }

    static String tramo(int anios) {
        if (anios < 5) return "1) menos de 5 años";
        if (anios < 10) return "2) de 5 a 9 años";
        return "3) 10 años o más";
    }

    public static void main(String[] args) {
        Map<String, List<String>> nombres = Empresa.EMPLEADOS.stream()
                .collect(groupingBy(e -> tramo(anios(e)), TreeMap::new, mapping(Empleado::nombre, toList())));
        Map<String, Double> media = Empresa.EMPLEADOS.stream()
                .collect(groupingBy(e -> tramo(anios(e)), TreeMap::new, averagingDouble(Empleado::salario)));
        nombres.forEach((t, lista) -> System.out.printf("%-20s %2d empleados, salario medio %7.2f: %s%n",
                t, lista.size(), media.get(t), lista));

        Empleado veterano = Empresa.EMPLEADOS.stream().min(Comparator.comparing(Empleado::fechaAlta)).orElseThrow();
        System.out.println("Más antiguo: " + veterano.nombre() + " (" + anios(veterano) + " años)");
        double mediaAnios = Empresa.EMPLEADOS.stream().mapToInt(Ej3Antiguedad::anios).average().orElse(0);
        System.out.printf("Antigüedad media: %.1f años%n", mediaAnios);

        Map<Boolean, Long> trienios = Empresa.EMPLEADOS.stream()
                .collect(partitioningBy(e -> anios(e) >= 3, counting()));
        System.out.println("Con al menos un trienio: " + trienios.get(true) + ", sin él: " + trienios.get(false));
    }
}
1) menos de 5 años    4 empleados, salario medio 1637,50: [Sara, Jorge, Manuel, Tomás]
2) de 5 a 9 años     11 empleados, salario medio 2204,55: [David, Elena, Sergio, Lucía, Raquel, Iván, Hugo, Nuria, Álvaro, Rosa, Cristina]
3) 10 años o más      9 empleados, salario medio 4122,22: [Ana, Luis, Marta, Pedro, Laura, Javier, Carmen, Pablo, Isabel]
Más antiguo: Ana (16 años)
Antigüedad media: 8,3 años
Con al menos un trienio: 23, sin él: 1
El truco de los prefijos "1) ", "2) ", "3) " hace que el TreeMap ordene los tramos de forma lógica y no alfabética. Una solución más robusta sería un enum Tramo con un EnumMap, que se ordena por declaración (ejercicio propuesto 11 del módulo 02). Period.between(...).getYears() cuenta años completos, como la edad: quien entró el 1 de septiembre de 2025 lleva 1 año. En el módulo 05 estudiarás java.time a fondo.
Ejercicio 4: Frecuencia de palabras
Dado un texto, calcula cuántas palabras distintas tiene (ignorando mayúsculas y una lista de palabras vacías como “de”, “la”, “los”…), las 5 más frecuentes (a igual frecuencia, en orden alfabético), la palabra más larga y cuántas palabras distintas empiezan por cada letra.
Ver solución
import java.util.Arrays;
import java.util.Comparator;
import java.util.Map;
import java.util.Set;
import java.util.stream.Collectors;

public class Ej4Palabras {

    static final Set<String> VACIAS = Set.of("de", "la", "el", "en", "y", "a", "los", "las", "un", "una",
            "que", "con", "por", "para", "del", "se", "es", "al", "lo", "su");

    public static void main(String[] args) {
        String texto = """
                Java es un lenguaje de programación orientado a objetos. Con los streams de Java
                el código que procesa colecciones se vuelve declarativo: describes qué quieres y
                no cómo hacerlo. Los streams no almacenan datos; los streams describen un cálculo
                que se ejecuta cuando aparece una operación terminal. Java 24 añadió los gatherers
                para que los streams sean todavía más flexibles.
                """;

        Map<String, Long> frecuencias = texto.lines()
                .flatMap(linea -> Arrays.stream(linea.split("[^\\p{L}\\p{N}]+")))   // trocea por no-letras
                .map(String::toLowerCase)
                .filter(p -> p.length() > 1 && !VACIAS.contains(p))
                .collect(Collectors.groupingBy(p -> p, Collectors.counting()));

        System.out.println("Palabras distintas: " + frecuencias.size());
        frecuencias.entrySet().stream()
                .sorted(Map.Entry.<String, Long>comparingByValue().reversed()
                        .thenComparing(Map.Entry.comparingByKey()))
                .limit(5)
                .forEach(e -> System.out.println("  " + e.getKey() + " = " + e.getValue()));

        String masLarga = frecuencias.keySet().stream().max(Comparator.comparingInt(String::length)
                .thenComparing(Comparator.naturalOrder())).orElse("");
        System.out.println("Palabra más larga: " + masLarga);
        System.out.println("Iniciales: " + frecuencias.keySet().stream()
                .collect(Collectors.groupingBy(p -> p.charAt(0), java.util.TreeMap::new, Collectors.counting())));
    }
}
Palabras distintas: 33
  streams = 4
  java = 3
  no = 2
  24 = 1
  almacenan = 1
Palabra más larga: programación
Iniciales: {2=1, a=3, c=5, d=4, e=1, f=1, g=1, h=1, j=1, l=1, m=1, n=1, o=3, p=2, q=2, s=2, t=2, v=1}
split("[^\\p{L}\\p{N}]+") trocea por cualquier secuencia de caracteres que no sean letras (\p{L}, incluidas las acentuadas) ni números (\p{N}); con \W se romperían las palabras con tilde. groupingBy(p -> p, counting()) es el patrón clásico para contar frecuencias (Function.identity() sería equivalente). El orden “más frecuente primero y, a igualdad, alfabético” se expresa combinando comparingByValue().reversed() con thenComparing(comparingByKey()).
Ejercicio 5: Meses récord con un gatherer propio
Calcula la facturación mensual de 2025 (pedidos no cancelados) y, con un gatherer propio nuevosRecords(), muestra solo los meses que superan el máximo de todos los anteriores. Usa además Gatherers.windowSliding(2) para la variación porcentual respecto al mes anterior y Gatherers.fold para el total del año.
Ver solución
import java.time.YearMonth;
import java.util.List;
import java.util.Map;
import java.util.TreeMap;
import java.util.stream.Collectors;
import java.util.stream.Gatherer;
import java.util.stream.Gatherers;

public class Ej5Records {

    record VentaMes(YearMonth mes, double total) {}

    /** Gatherer propio: deja pasar solo los elementos que superan el máximo anterior ("récords"). */
    static Gatherer<VentaMes, ?, VentaMes> nuevosRecords() {
        class Maximo { double valor = Double.NEGATIVE_INFINITY; }
        return Gatherer.ofSequential(
                Maximo::new,
                Gatherer.Integrator.ofGreedy((max, venta, salida) -> {
                    if (venta.total() > max.valor) {
                        max.valor = venta.total();
                        return salida.push(venta);
                    }
                    return true;
                }));
    }

    public static void main(String[] args) {
        // Facturación mensual de 2025 (sin pedidos cancelados), ordenada por mes
        Map<YearMonth, Double> porMes = Empresa.PEDIDOS.stream()
                .filter(p -> p.fecha().getYear() == 2025 && !p.estado().equals("CANCELADO"))
                .collect(Collectors.groupingBy(p -> YearMonth.from(p.fecha()), TreeMap::new,
                        Collectors.summingDouble(Pedido::total)));
        List<VentaMes> ventas = porMes.entrySet().stream()
                .map(e -> new VentaMes(e.getKey(), Math.round(e.getValue() * 100) / 100.0)).toList();
        ventas.forEach(v -> System.out.printf("%s %10.2f €%n", v.mes(), v.total()));

        System.out.println("Meses récord:");
        ventas.stream().gather(nuevosRecords())
                .forEach(v -> System.out.printf("  %s %10.2f €%n", v.mes(), v.total()));

        System.out.println("Variación respecto al mes anterior:");
        ventas.stream()
                .gather(Gatherers.windowSliding(2))
                .forEach(par -> System.out.printf("  %s -> %s %+7.1f %%%n", par.get(0).mes(), par.get(1).mes(),
                        100 * (par.get(1).total() - par.get(0).total()) / par.get(0).total()));

        double acumulado = ventas.stream().gather(Gatherers.fold(() -> 0.0, (a, v) -> a + v.total()))
                .findFirst().orElse(0.0);
        System.out.printf("Total 2025: %.2f €%n", acumulado);
    }
}
2025-01    9205,40 €
2025-02    6791,40 €
2025-03    1375,20 €
2025-04    2539,13 €
2025-05    4772,44 €
2025-06   12656,50 €
2025-09    1658,80 €
2025-10    1555,00 €
2025-11     358,80 €
Meses récord:
  2025-01    9205,40 €
  2025-06   12656,50 €
Variación respecto al mes anterior:
  2025-01 -> 2025-02   -26,2 %
  2025-02 -> 2025-03   -79,8 %
  2025-03 -> 2025-04   +84,6 %
  2025-04 -> 2025-05   +88,0 %
  2025-05 -> 2025-06  +165,2 %
  2025-06 -> 2025-09   -86,9 %
  2025-09 -> 2025-10    -6,3 %
  2025-10 -> 2025-11   -76,9 %
Total 2025: 40912,67 €
nuevosRecords es un gatherer secuencial con estado (el máximo visto hasta ahora) que solo emite cuando aparece un valor mayor. Se usa Integrator.ofGreedy para indicar que el integrador nunca pide parar antes de tiempo: es una pista de optimización para la biblioteca. Devuelve salida.push(venta) para respetar a un consumidor que ya no quiera más elementos (por ejemplo, si después hubiera un limit). Ningún operador estándar de streams expresa “máximo acumulado con emisión condicional” de forma directa: es el caso de uso típico de los gatherers. Observa también que julio y agosto no aparecen porque no hubo pedidos: windowSliding(2) compara cada mes con datos con el siguiente, así que la variación de junio a septiembre salta dos meses. Si necesitaras todos los meses, tendrías que generarlos antes (por ejemplo, con Stream.iterate sobre YearMonth) y rellenar con ceros.
Ejercicio 6: Informe de clientes
Para cada cliente con pedidos no cancelados, calcula el número de pedidos, el total facturado, el ticket medio y la fecha del último pedido en un record ResumenCliente. Muestra los 6 clientes con más facturación, los que no han hecho pedidos en 2026 y comprueba con teeing que el total global cuadra con la suma por clientes.
Ver solución
import java.time.LocalDate;
import java.util.Comparator;
import java.util.List;
import java.util.Map;
import java.util.function.Function;
import java.util.stream.Collectors;

public class Ej6Clientes {

    record ResumenCliente(String cliente, long pedidos, double total, double ticketMedio, LocalDate ultimo) {}

    public static void main(String[] args) {
        Map<Integer, String> nombres = Empresa.CLIENTES.stream()
                .collect(Collectors.toMap(Cliente::id, Cliente::nombre));

        List<ResumenCliente> resumen = Empresa.PEDIDOS.stream()
                .filter(p -> !p.estado().equals("CANCELADO"))
                .collect(Collectors.groupingBy(Pedido::cliente,
                        Collectors.collectingAndThen(Collectors.toList(), lista -> {
                            double total = lista.stream().mapToDouble(Pedido::total).sum();
                            LocalDate ultimo = lista.stream().map(Pedido::fecha).max(Comparator.naturalOrder()).orElseThrow();
                            return new ResumenCliente(nombres.get(lista.getFirst().cliente()), lista.size(),
                                    total, total / lista.size(), ultimo);
                        })))
                .values().stream()
                .sorted(Comparator.comparingDouble(ResumenCliente::total).reversed())
                .toList();

        System.out.printf("%-28s %3s %10s %10s %s%n", "Cliente", "Ped", "Total", "Ticket", "Último");
        resumen.stream().limit(6).forEach(r -> System.out.printf("%-28s %3d %10.2f %10.2f %s%n",
                r.cliente(), r.pedidos(), r.total(), r.ticketMedio(), r.ultimo()));

        // Clientes cuyo último pedido es anterior a 2026 (posible pérdida de clientes)
        System.out.println("Sin pedidos en 2026: " + resumen.stream()
                .filter(r -> r.ultimo().getYear() < 2026).map(ResumenCliente::cliente).toList());

        // Mismo total por otro camino: teeing de suma y número de pedidos
        String global = Empresa.PEDIDOS.stream().filter(p -> !p.estado().equals("CANCELADO"))
                .collect(Collectors.teeing(Collectors.summingDouble(Pedido::total), Collectors.counting(),
                        (suma, n) -> "%d pedidos, %.2f €, ticket medio %.2f €".formatted(n, suma, suma / n)));
        System.out.println("Global: " + global);
        System.out.println("¿Cuadra con la suma por clientes? "
                + (Math.abs(resumen.stream().mapToDouble(ResumenCliente::total).sum()
                - Empresa.PEDIDOS.stream().filter(p -> !p.estado().equals("CANCELADO")).mapToDouble(Pedido::total).sum()) < 0.001));
    }
}
Cliente                      Ped      Total     Ticket Último
Instituto Tecnológico Sur      2   20602,55   10301,28 2026-01-12
Construcciones Levante S.A.    3   14260,19    4753,40 2026-03-03
Academia Nova                  2    7891,30    3945,65 2025-09-08
Talleres Martín S.L.           3    4704,15    1568,05 2026-06-15
Hotel Mar Azul S.L.            2    4202,77    2101,38 2026-05-30
Diseños Creativos S.L.         2    3054,00    1527,00 2026-07-01
Sin pedidos en 2026: [Academia Nova, Antonio Ruiz Pérez, María José Herrera]
Global: 23 pedidos, 61617,46 €, ticket medio 2679,02 €
¿Cuadra con la suma por clientes? true
groupingBy + collectingAndThen construye un objeto resumen por grupo; .values().stream() permite seguir procesando los resúmenes (ordenarlos, filtrarlos). La comprobación final compara números double con una tolerancia (< 0.001) en lugar de ==, porque sumar en distinto orden puede dar diferencias en los últimos decimales. Es una buena costumbre en cualquier informe: verificar que los totales parciales cuadran con el total.
Ejercicio 7 (propuesto): Comisiones de los comerciales
Para cada empleado con oficio VENDEDOR, calcula el importe total de los pedidos que ha gestionado (columna empleado de pedidos, sin cancelados) y una comisión variable del 2 % de esas ventas. Muestra un ranking con nombre, número de pedidos, ventas, comisión fija (de la tabla), comisión variable y total. ¿Qué vendedor no tiene pedidos? Asegúrate de que aparece con ceros.
Ejercicio 8 (propuesto): Jerarquía de categorías
Las categorías de EMPRESA forman un árbol (categoria_padre). Represéntalas con record Categoria(int id, String nombre, Integer padre) y, con streams y recursión, calcula para cada categoría raíz (Informática, Electrónica, Oficina) el número de productos y el valor del inventario (precio × stock) incluyendo todas sus subcategorías.
Ejercicio 9 (propuesto): Lectura de un CSV con Files.lines
Exporta la tabla empleados a un fichero CSV (puedes escribirlo con Files.write desde Empresa.EMPLEADOS) y después léelo con Files.lines en un try-with-resources, saltando la cabecera, convirtiendo cada línea en un Empleado y descartando (con un aviso) las líneas mal formadas. Calcula la masa salarial por oficio. Añade a mano dos líneas erróneas al fichero para probarlo.
Ejercicio 10 (propuesto): Un colector propio
Implementa con Collector.of(...) un colector aEstadisticasTexto() que, a partir de un Stream<String>, devuelva un record con el número de cadenas, la longitud total, la más corta y la más larga, en una sola pasada. Asegúrate de que tiene combinador para funcionar en paralelo y compruébalo con parallelStream() sobre los nombres de todos los clientes y productos.
Ejercicio 11 (propuesto): Gatherer de deduplicación consecutiva
Escribe un gatherer sinRepetidosConsecutivos() que elimine los elementos iguales al inmediatamente anterior (como el comando uniq de Linux): [1, 1, 2, 2, 2, 3, 1, 1] → [1, 2, 3, 1]. Aplícalo a la secuencia de estados de los pedidos ordenados por fecha para ver los cambios de estado. ¿Por qué no sirve distinct()?
Ejercicio 12 (propuesto): Paralelo, ¿sí o no?
Mide (repitiendo cada medición varias veces y descartando las primeras para que actúe el JIT) el tiempo de: (a) sumar los cuadrados de 1 a 50 millones con LongStream, (b) lo mismo con Stream.iterate(1L, x -> x + 1).limit(50_000_000), (c) ordenar un millón de String aleatorios, cada una en versión secuencial y paralela. Explica los resultados según la tabla de la sección 9, en especial por qué iterate apenas mejora (o empeora) en paralelo.
Resumen
| Concepto | API | Idea clave |
|---|---|---|
| Stream | coleccion.stream() | Tubería origen → intermedias → terminal; no almacena, se usa una vez |
| Perezoso | — | Nada se ejecuta sin operación terminal; procesamiento vertical |
| Crear | Stream.of, Arrays.stream, IntStream.range, iterate, generate, Files.lines | Los infinitos necesitan limit |
| Filtrar y transformar | filter, map, flatMap, mapMulti | flatMap aplana (como un JOIN) |
| Ordenar y recortar | sorted, distinct, limit, skip, takeWhile, dropWhile | skip + limit = paginación |
| Terminales | toList, collect, reduce, count, min, max, anyMatch, findFirst | Muchas devuelven Optional |
| Primitivos | mapToInt, sum, average, summaryStatistics, boxed | Sin autoboxing |
| Agrupar | groupingBy(clave, TreeMap::new, downstream) | GROUP BY con agregados |
| Colectores | toMap, joining, counting, summingDouble, averagingDouble, mapping, filtering, partitioningBy, teeing, collectingAndThen | Se anidan |
| Gatherers (Java 24) | gather(Gatherers.windowFixed(n)), windowSliding, scan, fold, mapConcurrent, Gatherer.ofSequential(...) | Intermedias personalizadas con estado |
| Paralelo | .parallel(), parallelStream() | Solo con muchos datos, CPU intensiva, funciones puras y tras medir |
| Errores | Reutilizar, modificar el origen, toMap duplicado, efectos secundarios | IllegalStateException, ConcurrentModificationException |