Módulo 19: Spring Data JPA
Objetivos del módulo
- Entender qué aporta Spring Data JPA sobre el
EntityManagery el patrón DAO que programaste en los módulos 13 a 16 - Conocer la jerarquía de repositorios (
Repository,CrudRepository,ListCrudRepository,JpaRepository…) y elegir la adecuada - Escribir consultas derivadas del nombre del método y consultas con
@Queryen JPQL y SQL nativo - Hacer modificaciones masivas con
@Modifying - Paginar y ordenar con
Pageable,PageySort - Devolver solo lo necesario con proyecciones (interfaces y records)
- Construir búsquedas dinámicas con Specifications y Query by Example
- Evitar el problema N+1 con
@EntityGraph - Rellenar fechas automáticamente con la auditoría de Spring Data
- Gestionar las transacciones en la capa de servicio (
@Transactional,readOnly, propagación) - Cargar datos iniciales, ver el SQL generado y trabajar con H2 y su consola web
1. Del DAO a mano a Spring Data
En el módulo 13 escribiste un EmpleadoDAO con JDBC, y en el 14-16 lo rehiciste con el EntityManager de JPA. Recuerda cómo era un método típico:
public List<Empleado> buscarPorOficio(String oficio) {
    return em.createQuery("select e from Empleado e where e.oficio = :oficio", Empleado.class)
             .setParameter("oficio", oficio)
             .getResultList();
}
Multiplica eso por cada consulta de cada entidad, añade guardar, borrar, buscarPorId, contar, paginación… y tienes cientos de líneas casi idénticas. Spring Data JPA elimina ese código repetitivo:
public interface EmpleadoRepository extends JpaRepository<Empleado, Integer> {

    List<Empleado> findByOficio(String oficio);       // ¡y ya está!
}
📘 Concepto: Spring Data JPA es un módulo de Spring Data que, a partir de una interfaz que tú declaras, genera al arrancar una implementación (un proxy) con los métodos CRUD, la paginación y las consultas que deduce del nombre de cada método o de una anotación
@Query. Por debajo sigue usando JPA y Hibernate: todo lo que aprendiste (estados de la entidad, carga perezosa, JPQL, N+1) sigue siendo válido.
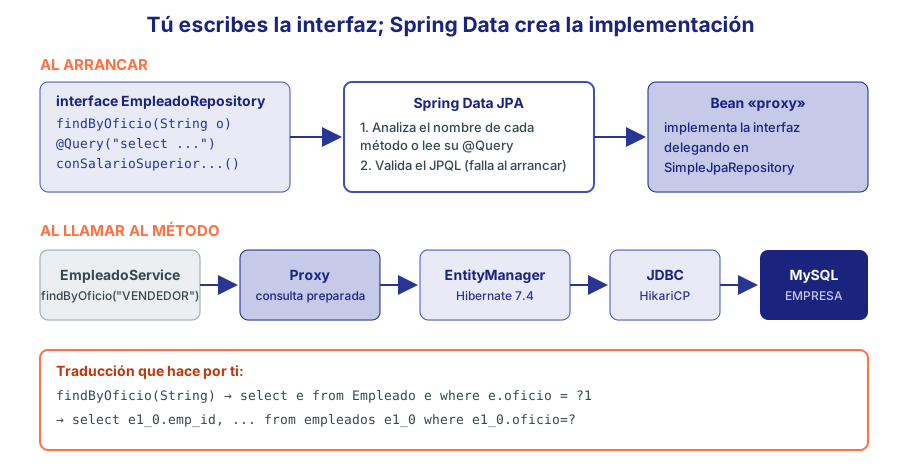 Figura 1. Tú escribes la interfaz; Spring Data crea la implementación.
Qué añade el starter
spring-boot-starter-data-jpa, que ya tienes en empresa-app, trae Spring Data JPA 4.1 (del release train Spring Data 2026.0), Hibernate ORM 7.4 y HikariCP, y la autoconfiguración hace el resto: crea el DataSource con spring.datasource.*, el EntityManagerFactory buscando entidades en el paquete de la clase principal y sus subpaquetes, el JpaTransactionManager y activa los repositorios (lo verás en el log: Found 6 JPA repository interfaces). No hace falta persistence.xml ni @EnableJpaRepositories.
La configuración de JPA que usamos (en application.properties):
spring.jpa.open-in-view=false
spring.jpa.hibernate.ddl-auto=validate
⚠️ Importante: Por defecto Spring Boot activa Open Session in View (
spring.jpa.open-in-view=true) y avisa en el log con unWARN: mantiene la sesión de Hibernate abierta mientras se genera la respuesta para que las relaciones perezosas «funcionen» en la vista. Es cómodo pero esconde problemas N+1 y alarga el uso de conexiones. Lo desactivamos y cargamos explícitamente lo que necesita cada pantalla (sección 10).
2. Las entidades de empresa-app
Las entidades son las del esquema EMPRESA que ya mapeaste en los módulos 14 y 15. Están en el paquete es.curso.empresa.modelo: Departamento, Empleado, Categoria, Producto, Cliente, Pedido, LineaPedido (con su clave LineaPedidoId), el enumerado EstadoPedido y un conversor. Recordamos las dos más representativas:
@Entity
@Table(name = "empleados")
public class Empleado {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    @Column(name = "emp_id")
    private Integer id;

    @Column(nullable = false, length = 30)
    private String nombre;

    @Column(nullable = false, length = 50)
    private String apellidos;

    @Column(nullable = false, length = 60, unique = true)
    private String email;

    @Column(length = 15)
    private String telefono;

    @Column(name = "fecha_alta", nullable = false)
    private LocalDate fechaAlta;

    @Column(nullable = false, length = 30)
    private String oficio;

    @Column(nullable = false, precision = 8, scale = 2)
    private BigDecimal salario;

    @Column(precision = 8, scale = 2)
    private BigDecimal comision;

    @ManyToOne(fetch = FetchType.LAZY)          // autorrelación: el jefe es otro empleado
    @JoinColumn(name = "jefe_id")
    private Empleado jefe;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "dept_id")
    private Departamento departamento;

    protected Empleado() { }                    // obligatorio para JPA

    public Empleado(String nombre, String apellidos, String email, String oficio,
                    BigDecimal salario, LocalDate fechaAlta) { ... }

    public String getNombreCompleto() { return nombre + " " + apellidos; }
    // getters y setters
}
La columna productos.descatalogado es un CHAR(1) con 'S'/'N'. En Java preferimos un boolean, así que usamos un AttributeConverter (módulo 14):
@Converter
public class SiNoConverter implements AttributeConverter<Boolean, String> {

    @Override
    public String convertToDatabaseColumn(Boolean valor) {
        return Boolean.TRUE.equals(valor) ? "S" : "N";
    }

    @Override
    public Boolean convertToEntityAttribute(String columna) {
        return "S".equals(columna);
    }
}
@Convert(converter = SiNoConverter.class)
@Column(nullable = false, length = 1, columnDefinition = "char(1)")
private boolean descatalogado;
Y LineaPedido es una entidad débil con clave compuesta (pedido_id, num_linea): usamos @EmbeddedId y @MapsId para que el pedido_id de la clave se tome del pedido al que pertenece:
@Entity
@Table(name = "lineas_pedido")
public class LineaPedido {

    @EmbeddedId
    private LineaPedidoId id;                 // (pedidoId, numLinea)

    @MapsId("pedidoId")                       // pedido_id forma parte de la clave
    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "pedido_id")
    private Pedido pedido;

    @ManyToOne(fetch = FetchType.LAZY, optional = false)
    @JoinColumn(name = "producto_id", nullable = false)
    private Producto producto;

    private int cantidad;
    private BigDecimal precioUnitario;
    private BigDecimal descuento = BigDecimal.ZERO;
    ...
}
💡 Consejo: Con
ddl-auto=validate, si una entidad no coincide con la tabla, la aplicación no arranca y Hibernate te dice exactamente qué falla (por ejemploSchema-validation: missing column [fecha_baja] in table [empleados]). Es una red de seguridad estupenda cuando el esquema lo mantienes con scripts.
3. Repositorios
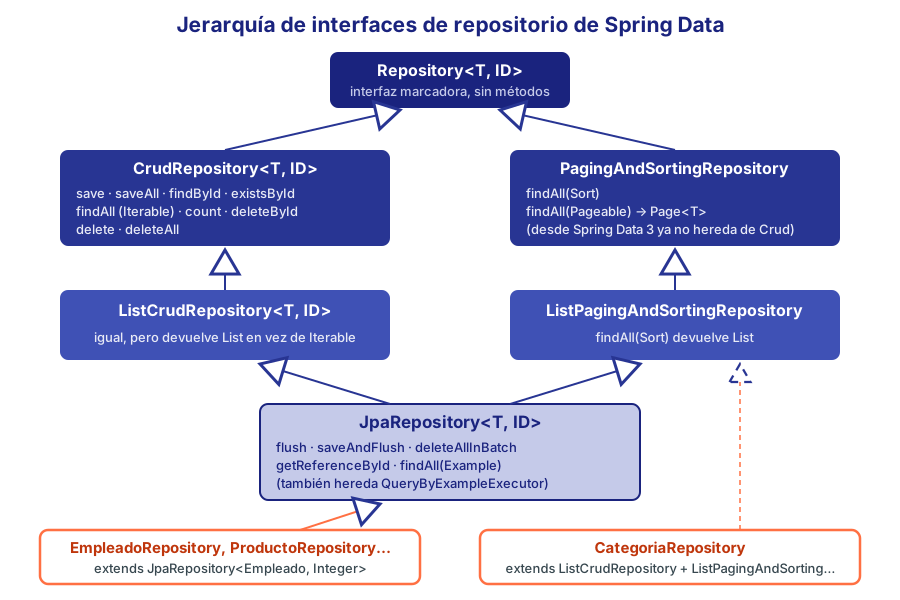 Figura 2. Jerarquía de interfaces de repositorio de Spring Data.
| Interfaz | Aporta | Cuándo usarla |
|---|---|---|
Repository<T, ID> | Nada (marca) | Quieres exponer solo los métodos que declares (p. ej., un repositorio de solo lectura) |
CrudRepository<T, ID> | save, findById, findAll, count, delete… con Iterable | Código genérico de Spring Data |
ListCrudRepository<T, ID> | Lo mismo devolviendo List | Repositorios sencillos |
PagingAndSortingRepository / ListPaging... | findAll(Sort), findAll(Pageable) | Si necesitas paginar sin el resto de JPA |
JpaRepository<T, ID> | Todo lo anterior + flush, saveAndFlush, deleteAllInBatch, getReferenceById, Query by Example | La opción por defecto en proyectos JPA |
Los repositorios de empresa-app están en es.curso.empresa.repositorio. La mayoría heredan de JpaRepository; CategoriaRepository muestra la alternativa «a la carta»:
/** Ejemplo de repositorio "a la carta": solo CRUD y ordenación, sin métodos JPA específicos. */
public interface CategoriaRepository extends ListCrudRepository<Categoria, Integer>,
        ListPagingAndSortingRepository<Categoria, Integer> {

    List<Categoria> findByPadreIsNullOrderByNombre();
    ...
}
No hace falta anotar las interfaces con @Repository: Spring Data las detecta por heredar de Repository. Y se inyectan como cualquier bean:
@Service
public class DepartamentoService {

    private final DepartamentoRepository departamentos;

    public DepartamentoService(DepartamentoRepository departamentos) {
        this.departamentos = departamentos;
    }
}
Los métodos heredados más usados
| Método | Comportamiento |
|---|---|
save(entidad) | Si la entidad es nueva (id null) hace persist; si no, merge. Devuelve la entidad gestionada: usa el valor devuelto |
saveAll(lista) | save de cada una |
findById(id) | Optional<T>: vacío si no existe |
getReferenceById(id) | Un proxy sin consultar la base de datos (útil para asignar una FK); falla al usarlo si el id no existe |
existsById(id), count() | Comprobaciones baratas |
findAll(), findAll(Sort), findAll(Pageable) | Todas, ordenadas o paginadas |
deleteById(id), delete(entidad) | Borrado (carga la entidad primero, para aplicar cascadas) |
deleteAllInBatch() | DELETE masivo sin cargar entidades (sin cascadas JPA) |
flush(), saveAndFlush() | Fuerza el envío de los cambios pendientes a la base de datos |
El servicio de departamentos usa varios de ellos. Fíjate en el patrón «buscar o lanzar excepción», que repetiremos en todos los servicios:
public Departamento buscar(Integer id) {
    return departamentos.findById(id)
            .orElseThrow(() -> new RecursoNoEncontradoException("departamento", id));
}
En EmpleadoService.guardar usamos getReferenceById para asignar el departamento y el jefe sin hacer un SELECT de cada uno: solo necesitamos su clave para la FK.
e.setDepartamento(form.getDepartamentoId() == null ? null
        : departamentos.getReferenceById(form.getDepartamentoId()));
4. Consultas derivadas del nombre del método
Spring Data analiza el nombre de cada método y construye la consulta. La gramática es: un sujeto (find, count, exists, delete…), opcionalmente un límite (First, Top3, Distinct), la palabra By y una serie de criterios sobre las propiedades de la entidad unidos con And/Or, y opcionalmente un OrderBy.
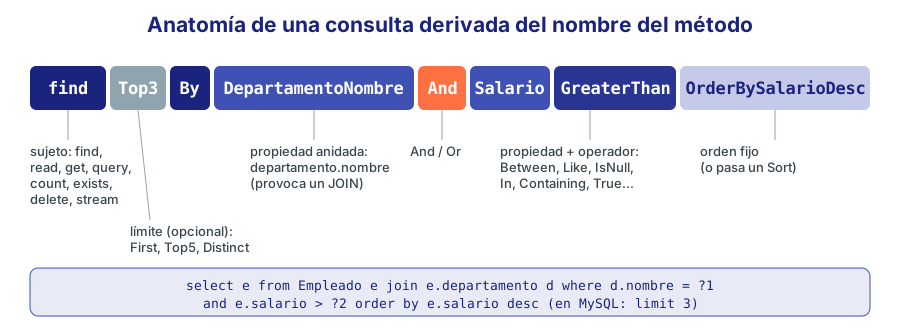 Figura 3. Anatomía de una consulta derivada.
⚠️ Importante: Los nombres de las propiedades son los de la entidad (Java), no los de las columnas:
findByFechaAlta, nofindByFecha_alta. Si te equivocas, la aplicación no arranca y el error lo dice claramente:No property 'fechaAltaa' found for type 'Empleado'. Es una gran ventaja frente al JPQL en cadenas, que solo falla al ejecutarse.
Tabla de palabras clave (con ejemplos de EMPRESA)
| Palabra clave | Ejemplo de método | JPQL equivalente (where ...) |
|---|---|---|
| (igualdad) | findByOficio(String o) | e.oficio = ?1 |
And / Or | findByOficioAndDepartamentoId(o, d) | e.oficio = ?1 and e.departamento.id = ?2 |
Not | findByOficioNot(o) | e.oficio <> ?1 |
Between | findBySalarioBetween(min, max) | e.salario between ?1 and ?2 |
LessThan, LessThanEqual | findByPrecioLessThanEqual(p) | p.precio <= ?1 |
GreaterThan, GreaterThanEqual | findBySalarioGreaterThan(s) | e.salario > ?1 |
After, Before | findByFechaAltaAfter(fecha) | e.fechaAlta > ?1 |
IsNull, IsNotNull | findByComisionIsNotNull() | e.comision is not null |
Like, NotLike | findByNombreLike("A%") | e.nombre like ?1 (tú pones los %) |
StartingWith, EndingWith, Containing | findByApellidosContaining("ez") | like '%ez%' (los % los pone Spring) |
IgnoreCase | findByApellidosContainingIgnoreCase(t) | upper(e.apellidos) like upper(?1) |
In, NotIn | findByOficioIn(List<String> l) | e.oficio in ?1 |
True, False | findByStockLessThanAndDescatalogadoFalse(n) | p.stock < ?1 and p.descatalogado = false |
| Propiedad anidada | findByDepartamentoNombre(n) | e.departamento.nombre = ?1 (con join) |
OrderBy...Asc/Desc | findByOficioOrderBySalarioDesc(o) | ... order by e.salario desc |
First, TopN | findTop3ByOrderBySalarioDesc() | order by e.salario desc + límite 3 |
Distinct | findDistinctOficioBy... | select distinct ... |
countBy, existsBy, deleteBy | countByDepartamentoId(id), existsByEmail(e) | select count(...), existencia |
Los métodos de EmpleadoRepository en empresa-app:
public interface EmpleadoRepository extends JpaRepository<Empleado, Integer>,
        JpaSpecificationExecutor<Empleado> {

    List<Empleado> findByOficio(String oficio);
    List<Empleado> findByOficioOrderBySalarioDesc(String oficio);
    List<Empleado> findBySalarioBetween(BigDecimal minimo, BigDecimal maximo);
    List<Empleado> findByApellidosContainingIgnoreCase(String texto);
    List<Empleado> findByDepartamentoNombre(String nombreDepartamento);
    List<Empleado> findByComisionIsNotNull();
    List<Empleado> findByDepartamentoIsNull();
    List<Empleado> findByFechaAltaAfter(LocalDate fecha);
    List<Empleado> findByOficioIn(List<String> oficios);
    List<Empleado> findTop3ByOrderBySalarioDesc();
    List<Empleado> findByDepartamentoId(Integer deptId, Sort orden);
    Page<Empleado> findByDepartamentoId(Integer deptId, Pageable pageable);
    Optional<Empleado> findByEmail(String email);
    boolean existsByEmail(String email);
    long countByDepartamentoId(Integer deptId);
    long countByJefeId(Integer jefeId);
    ...
}
Probarlo: un CommandLineRunner de demostración
Para ver los resultados sin montar aún la web, usamos un CommandLineRunner que solo existe con el perfil demo (lo ejecutamos con --spring.profiles.active=dev,demo --spring.main.web-application-type=none, para que no arranque Tomcat):
@Component
@Profile("demo")
public class DemoRepositorios implements CommandLineRunner {

    private final EmpleadoRepository empleados;
    private final ProductoRepository productos;
    private final TransactionTemplate tx;

    public DemoRepositorios(EmpleadoRepository empleados, ProductoRepository productos,
                            TransactionTemplate tx) { ... }

    private static void lista(List<Empleado> l) {
        l.forEach(e -> System.out.printf("  %d %-22s %-16s %8s%n",
                e.getId(), e.getNombreCompleto(), e.getOficio(), e.getSalario()));
    }

    @Override
    public void run(String... args) {
        titulo("01 findByOficio(\"VENDEDOR\")");
        lista(empleados.findByOficio("VENDEDOR"));

        titulo("02 findBySalarioBetween(2000, 2500)");
        lista(empleados.findBySalarioBetween(new BigDecimal("2000"), new BigDecimal("2500")));

        titulo("03 findByApellidosContainingIgnoreCase(\"ez\")");
        lista(empleados.findByApellidosContainingIgnoreCase("ez"));

        titulo("04 findByDepartamentoNombre(\"CONTABILIDAD\")");
        lista(empleados.findByDepartamentoNombre("CONTABILIDAD"));

        titulo("05 findTop3ByOrderBySalarioDesc()");
        lista(empleados.findTop3ByOrderBySalarioDesc());

        titulo("06 count / exists / Optional");
        System.out.println("  countByDepartamentoId(20) = " + empleados.countByDepartamentoId(20));
        System.out.println("  existsByEmail(\"ana.garcia@empresa.es\") = " + empleados.existsByEmail("ana.garcia@empresa.es"));
        System.out.println("  findByEmail(\"nadie@empresa.es\") = " + empleados.findByEmail("nadie@empresa.es"));
        System.out.println("  findByDepartamentoIsNull() = " + empleados.findByDepartamentoIsNull());
        ...
    }
}
Salida real (contra MySQL con los datos de EMPRESA):
### 01 findByOficio("VENDEDOR")
  110 Carmen Ruiz Ortega     VENDEDOR          2200.00
  111 David Torres Romero    VENDEDOR          2100.00
  112 Elena Navarro Castro   VENDEDOR          2300.00
  113 Sergio Jiménez Vidal   VENDEDOR          1900.00

### 02 findBySalarioBetween(2000, 2500)
  110 Carmen Ruiz Ortega     VENDEDOR          2200.00
  111 David Torres Romero    VENDEDOR          2100.00
  112 Elena Navarro Castro   VENDEDOR          2300.00
  123 Sara Ortiz Delgado     PROGRAMADOR       2400.00
  124 Hugo Rubio Marín       TÉCNICO SISTEMAS  2500.00
  140 Nuria Gil Soto         DISEÑADOR         2300.00

### 03 findByApellidosContainingIgnoreCase("ez")
  100 Ana García López       DIRECTOR GENERAL  6500.00
  101 Luis Martínez Ruiz     DIRECTOR          4800.00
  102 Marta Sánchez Gil      DIRECTOR          5000.00
  103 Pedro Gómez Díaz       DIRECTOR          4200.00
  104 Laura Fernández Moreno DIRECTOR          4300.00
  105 Javier López Navarro   DIRECTOR          4000.00
  113 Sergio Jiménez Vidal   VENDEDOR          1900.00
  122 Iván Castro Méndez     PROGRAMADOR       2600.00
  130 Isabel Domínguez Vega  CONTABLE          2600.00
  131 Jorge Vázquez Ramos    ADMINISTRATIVO    1650.00

### 04 findByDepartamentoNombre("CONTABILIDAD")
  103 Pedro Gómez Díaz       DIRECTOR          4200.00
  130 Isabel Domínguez Vega  CONTABLE          2600.00
  131 Jorge Vázquez Ramos    ADMINISTRATIVO    1650.00

### 05 findTop3ByOrderBySalarioDesc()
  100 Ana García López       DIRECTOR GENERAL  6500.00
  102 Marta Sánchez Gil      DIRECTOR          5000.00
  101 Luis Martínez Ruiz     DIRECTOR          4800.00

### 06 count / exists / Optional
  countByDepartamentoId(20) = 6
  existsByEmail("ana.garcia@empresa.es") = true
  findByEmail("nadie@empresa.es") = Optional.empty
  findByDepartamentoIsNull() = [Empleado[160, Tomás Reyes Fuentes, BECARIO, 900.00]]
Y el SQL que Hibernate generó para findByDepartamentoNombre y findTop3ByOrderBySalarioDesc (fíjate en el join automático y en el limit):
15:28:28.910 DEBUG org.hibernate.SQL :
    select
        e1_0.emp_id,
        e1_0.apellidos,
        e1_0.comision,
        e1_0.dept_id,
        e1_0.email,
        e1_0.fecha_alta,
        e1_0.jefe_id,
        e1_0.nombre,
        e1_0.oficio,
        e1_0.salario,
        e1_0.telefono
    from
        empleados e1_0
    left join
        departamentos d1_0
            on d1_0.dept_id=e1_0.dept_id
    where
        d1_0.nombre=?
15:28:28.912 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:VARCHAR) <- [CONTABILIDAD]

15:28:29.123 DEBUG org.hibernate.SQL :
    select
        e1_0.emp_id,
        e1_0.apellidos,
        e1_0.comision,
        e1_0.dept_id,
        e1_0.email,
        e1_0.fecha_alta,
        e1_0.jefe_id,
        e1_0.nombre,
        e1_0.oficio,
        e1_0.salario,
        e1_0.telefono
    from
        empleados e1_0
    order by
        e1_0.salario desc
    limit
        ?
15:28:29.126 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [3]
Tipos de retorno
| Retorno | Cuándo |
|---|---|
List<T> | Varios resultados (lista vacía si no hay) |
Optional<T> | Cero o uno; lanza excepción si hay más de uno |
T | Uno; devuelve null si no hay (mejor Optional) |
Page<T> | Una página + el total (hace un count adicional) |
Slice<T> | Una página + si hay siguiente (sin count) |
Stream<T> | Recorrido perezoso de muchos resultados (dentro de una transacción y cerrándolo con try-with-resources) |
long, boolean | Con countBy... y existsBy... |
💡 Consejo: Las consultas derivadas son perfectas para criterios sencillos. Cuando el nombre pasa de tres o cuatro condiciones (
findByOficioAndSalarioGreaterThanAndDepartamentoLocalidadAndFechaAltaAfter...), es ilegible: usa@Queryo Specifications.
5. @Query: JPQL y SQL nativo
Con @Query escribes tú la consulta, en JPQL (sobre entidades, como en el módulo 16) o en SQL nativo. Los text blocks de Java (""") hacen que se lean bien:
// JPQL con subconsulta
@Query("""
       select e from Empleado e
       where e.salario > (select avg(e2.salario) from Empleado e2)
       order by e.salario desc""")
List<Empleado> conSalarioSuperiorALaMedia();

// Parámetros con nombre (:localidad) y @Param
@Query("""
       select e from Empleado e
       where e.departamento.localidad = :localidad and e.salario >= :minimo
       order by e.apellidos""")
List<Empleado> buscarPorLocalidad(@Param("localidad") String localidad,
                                  @Param("minimo") BigDecimal salarioMinimo);

// Proyección a un record con "select new" (sección 8)
@Query("""
       select new es.curso.empresa.dto.SalarioPorDepartamento(d.nombre, count(e), avg(e.salario))
       from Empleado e join e.departamento d
       group by d.nombre
       order by avg(e.salario) desc""")
List<SalarioPorDepartamento> salariosPorDepartamento();

// SQL nativo (funciones propias de MySQL, tablas y columnas reales)
@Query(value = "select * from empleados where year(fecha_alta) = :anio order by fecha_alta",
       nativeQuery = true)
List<Empleado> contratadosEnAnio(@Param("anio") int anio);
💡 Consejo: Como el proyecto se compila con la opción
-parameters(la activaspring-boot-starter-parent),@Parames opcional si el nombre del parámetro Java coincide con el de la consulta. Lo dejamos por claridad. Los parámetros posicionales (?1,?2) también funcionan, pero los nombres son más legibles.
Salida real:
### 07 @Query JPQL: conSalarioSuperiorALaMedia()
  100 Ana García López       DIRECTOR GENERAL  6500.00
  102 Marta Sánchez Gil      DIRECTOR          5000.00
  101 Luis Martínez Ruiz     DIRECTOR          4800.00
  104 Laura Fernández Moreno DIRECTOR          4300.00
  103 Pedro Gómez Díaz       DIRECTOR          4200.00
  105 Javier López Navarro   DIRECTOR          4000.00
  120 Pablo Moreno Herrera   ANALISTA          3500.00

### 08 @Query con parámetros: buscarPorLocalidad("Madrid", 2000)
  100 Ana García López       DIRECTOR GENERAL  6500.00
  101 Luis Martínez Ruiz     DIRECTOR          4800.00
  112 Elena Navarro Castro   VENDEDOR          2300.00
  110 Carmen Ruiz Ortega     VENDEDOR          2200.00
  111 David Torres Romero    VENDEDOR          2100.00

### 09 select new: salariosPorDepartamento()
  SalarioPorDepartamento[departamento=DIRECCIÓN, empleados=1, salarioMedio=6500.0]
  SalarioPorDepartamento[departamento=INFORMÁTICA, empleados=6, salarioMedio=3133.333333]
  SalarioPorDepartamento[departamento=MARKETING, empleados=3, salarioMedio=3100.0]
  SalarioPorDepartamento[departamento=CONTABILIDAD, empleados=3, salarioMedio=2816.666667]
  SalarioPorDepartamento[departamento=VENTAS, empleados=6, salarioMedio=2500.0]
  SalarioPorDepartamento[departamento=LOGÍSTICA, empleados=4, salarioMedio=2237.5]

### 10 nativa: contratadosEnAnio(2019)
  112 Elena Navarro Castro   VENDEDOR          2300.00
  152 Cristina Medina Blanco ADMINISTRATIVO    1750.00
  124 Hugo Rubio Marín       TÉCNICO SISTEMAS  2500.00
| JPQL | SQL nativo | |
|---|---|---|
| Trabaja con | Entidades y propiedades Java | Tablas y columnas |
| Portabilidad | Cualquier base de datos | Atada al dialecto (aquí year() de MySQL) |
| Validación | Al arrancar (Hibernate analiza el JPQL) | Solo al ejecutar |
Paginación con Pageable | Automática | Necesita countQuery |
| Úsalo para | El 95 % de los casos | Funciones específicas, vistas, consultas muy optimizadas |
⚠️ Importante: Nunca construyas una consulta concatenando texto del usuario (
"... where nombre = '" + nombre + "'"): es una inyección SQL de manual. Con@Queryy parámetros:nombre, Spring usa siemprePreparedStatementy el problema desaparece (módulo 12).
6. Modificaciones masivas con @Modifying
Una consulta update o delete en @Query necesita @Modifying y ejecutarse dentro de una transacción:
@Modifying(clearAutomatically = true)
@Query("update Empleado e set e.salario = e.salario * :factor where e.departamento.id = :deptId")
int actualizarSalarios(@Param("deptId") Integer deptId, @Param("factor") BigDecimal factor);
El servicio la usa para subir el sueldo a todo un departamento en una única sentencia SQL (en lugar de cargar cada empleado, modificarlo y guardarlo):
@Transactional
public int subirSalarios(Integer deptId, BigDecimal porcentaje) {
    Departamento d = departamentos.findById(deptId)
            .orElseThrow(() -> new RecursoNoEncontradoException("departamento", deptId));
    BigDecimal factor = BigDecimal.ONE.add(porcentaje.divide(BigDecimal.valueOf(100), 4, RoundingMode.HALF_UP));
    int filas = empleados.actualizarSalarios(deptId, factor);
    log.info("Subida del {} % a {} empleados de {}", porcentaje, filas, d.getNombre());
    return filas;
}
📘 Concepto: Un
updatemasivo va directo a la base de datos y no actualiza las entidades que ya estuvieran cargadas en el contexto de persistencia.clearAutomatically = truevacía ese contexto después de la sentencia, para que las siguientes lecturas vean los valores nuevos. (flushAutomatically = truehace lo contrario: envía antes los cambios pendientes.)
En la demostración lo ejecutamos dentro de un TransactionTemplate y marcamos la transacción para rollback al final, para no alterar los datos de EMPRESA:
### 17 @Modifying: actualizarSalarios(50, 1.10) (con rollback al final)
  filas actualizadas: 3
  104 Laura Fernández Moreno DIRECTOR          4730.00
  140 Nuria Gil Soto         DISEÑADOR         2530.00
  141 Álvaro Peña Cano       ANALISTA          2970.00
Los tres empleados de Marketing (departamento 50) cobran un 10 % más dentro de la transacción; al hacer rollback, la base de datos vuelve a los salarios originales (4300, 2300 y 2700).
7. Paginación y ordenación
Cargar 100.000 pedidos para mostrar 10 no es una opción. Spring Data resuelve la paginación con tres tipos:
| Tipo | Qué es |
|---|---|
Sort | Criterio de orden: Sort.by("apellidos"), Sort.by("salario").descending(), Sort.by(Sort.Order.asc("oficio"), Sort.Order.desc("salario")) |
Pageable | Qué página quieres: número (empieza en 0), tamaño y orden. Se crea con PageRequest.of(1, 5, Sort.by("salario")) |
Page<T> | El resultado: el contenido y los metadatos (total de elementos, total de páginas, número…) |
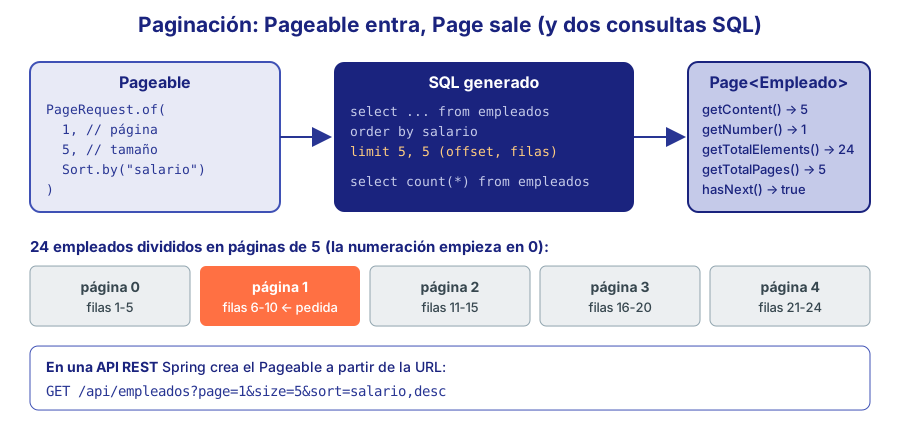 Figura 4. Paginación: Pageable entra, Page sale.
Basta con añadir un parámetro Pageable y devolver Page<T>:
Page<Empleado> findByDepartamentoId(Integer deptId, Pageable pageable);   // derivada
Page<Empleado> findAll(Pageable pageable);                                // heredada
List<Empleado> findByDepartamentoId(Integer deptId, Sort orden);          // solo orden
### 13 paginación: findAll(PageRequest.of(1, 5, salario desc))
  105 Javier López Navarro   DIRECTOR          4000.00
  120 Pablo Moreno Herrera   ANALISTA          3500.00
  121 Raquel Molina Prieto   PROGRAMADOR       2800.00
  141 Álvaro Peña Cano       ANALISTA          2700.00
  130 Isabel Domínguez Vega  CONTABLE          2600.00
  página 1 de 5, 24 elementos en total, ¿hay siguiente? true

### 14 Sort como parámetro: findByDepartamentoId(60, Sort.by("apellidos"))
  151 Manuel Herrero Lozano  OPERARIO          1600.00
  150 Rosa Iglesias Cruz     OPERARIO          1600.00
  105 Javier López Navarro   DIRECTOR          4000.00
  152 Cristina Medina Blanco ADMINISTRATIVO    1750.00
El SQL real de una página (aquí, la página 0 de 3 productos ordenados por precio que pide la API del módulo 20) son dos consultas: la de datos, con limit ?, ? (en MySQL, offset y número de filas), y la del total:
14:14:20.146 DEBUG org.hibernate.SQL :
    select
        p1_0.producto_id,
        p1_0.categoria_id,
        c1_0.categoria_id,
        c1_0.nombre,
        c1_0.categoria_padre_id,
        p1_0.descatalogado,
        p1_0.descripcion,
        p1_0.fecha_alta,
        p1_0.nombre,
        p1_0.precio,
        p1_0.stock
    from
        productos p1_0
    join
        categorias c1_0
            on c1_0.categoria_id=p1_0.categoria_id
    order by
        p1_0.precio desc
    limit
        ?, ?
14:14:20.150 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [0]
14:14:20.151 TRACE org.hibernate.orm.jdbc.bind : binding parameter (2:INTEGER) <- [3]
14:14:20.177 DEBUG org.hibernate.SQL :
    select
        count(p1_0.producto_id)
    from
        productos p1_0
14:14:24.361 DEBUG org.hibernate.SQL :
💡 Consejo: Si no necesitas el total («página 3 de 17»), devuelve
Slice<T>en lugar dePage<T>: te ahorras elcount, que en tablas grandes puede ser lo más caro.Slicesolo sabe si hay página siguiente (ideal para un scroll infinito).
Paginación desde la web
En un controlador, Spring MVC construye el Pageable a partir de los parámetros de la URL page, size y sort, y @PageableDefault fija los valores por defecto:
@GetMapping
public Page<ProductoDto> listar(@PageableDefault(size = 5, sort = "id") Pageable pageable) { ... }
GET /api/productos?page=0&size=3&sort=precio,desc
GET /api/productos?sort=categoria.nombre&sort=precio,desc     (varios criterios)
Al devolver un Page como JSON, Spring Data recomienda no serializar PageImpl directamente (su estructura interna no es un contrato estable). En empresa-app lo indicamos con:
spring.data.web.pageable.serialization-mode=via-dto
y la respuesta tiene esta forma estable, que verás en el módulo 20:
{"content":[ ... ],"page":{"size":3,"number":0,"totalElements":20,"totalPages":7}}
⚠️ Importante: Ordena siempre al paginar. Sin
order by, la base de datos puede devolver las filas en cualquier orden y un mismo registro podría aparecer en dos páginas o en ninguna. Además, comosortviene de la URL, Spring Data solo admite propiedades que existan en la entidad (unsort=passwordinventado provoca un error, no una inyección).
8. Proyecciones
A veces no necesitas la entidad completa, sino unas pocas columnas. Las proyecciones dicen a Spring Data qué forma debe tener el resultado.
Proyecciones con interfaz
/** Proyección con interfaz: Spring Data crea un objeto que implementa estos getters. */
public interface EmpleadoResumen {
    String getNombre();
    String getApellidos();
    String getOficio();
    BigDecimal getSalario();

    // Valor calculado con SpEL (convierte la proyección en "abierta")
    @Value("#{target.nombre + ' ' + target.apellidos}")
    String getNombreCompleto();
}
List<EmpleadoResumen> findByDepartamentoIdOrderBySalarioDesc(Integer deptId);
- Una proyección cerrada (solo getters que coinciden con propiedades) permite a Spring Data seleccionar solo esas columnas.
- Una proyección abierta (con
@Valuey SpEL) necesita la entidad completa para evaluar la expresión, así que no ahorra columnas; es cómoda, pero úsala con moderación.
Las interfaces también sirven con @Query: cada alias de la consulta corresponde a un getter. Así obtenemos el listado de departamentos con su número de empleados en una sola consulta:
public interface DepartamentoResumen {
    Integer getId();
    String getNombre();
    String getLocalidad();
    BigDecimal getPresupuesto();
    Long getNumEmpleados();
}
@Query("""
       select d.id as id, d.nombre as nombre, d.localidad as localidad,
              d.presupuesto as presupuesto, count(e) as numEmpleados
       from Departamento d left join d.empleados e
       group by d.id, d.nombre, d.localidad, d.presupuesto
       order by d.id""")
List<DepartamentoResumen> resumen();
Proyecciones con records (DTO)
Un record cuyo constructor coincide con las propiedades también funciona en consultas derivadas, y con select new en JPQL:
public record ProductoPrecio(String nombre, BigDecimal precio) { }

List<ProductoPrecio> findByCategoriaNombreOrderByPrecioDesc(String categoria);
public record SalarioPorDepartamento(String departamento, Long empleados, Double salarioMedio) { }
Salida real (la clase de la proyección por interfaz es un proxy generado):
### 11 proyección interfaz: findByDepartamentoIdOrderBySalarioDesc(40)
  Pedro Gómez Díaz | DIRECTOR | 4200.00 | clase: $Proxy192
  Isabel Domínguez Vega | CONTABLE | 2600.00 | clase: $Proxy192
  Jorge Vázquez Ramos | ADMINISTRATIVO | 1650.00 | clase: $Proxy192

### 12 proyección record: findByCategoriaNombreOrderByPrecioDesc("Monitores")
  ProductoPrecio[nombre=Monitor 27 4K, precio=329.00]
  ProductoPrecio[nombre=Monitor 24 FHD, precio=139.00]
| Tipo | Ventajas | Inconvenientes |
|---|---|---|
| Interfaz cerrada | Solo las columnas necesarias, sin escribir JPQL | Es un proxy, no un objeto «normal» |
Interfaz abierta (@Value) | Valores calculados | Carga la entidad entera |
| Record / DTO | Objeto inmutable real, ideal para devolver en una API | El constructor debe encajar exactamente |
select new en @Query | Control total (agregados, joins) | Nombre completo de la clase en el JPQL |
💡 Consejo: También existen las proyecciones dinámicas:
<T> List<T> findByOficio(String oficio, Class<T> tipo);y el que llama decide (findByOficio("VENDEDOR", EmpleadoResumen.class)).
9. Búsquedas dinámicas: Specifications y Query by Example
Un formulario de búsqueda con varios filtros opcionales (texto, oficio, departamento, salario mínimo) daría lugar a una explosión de métodos derivados para cada combinación. Hay dos herramientas para construir la consulta en tiempo de ejecución.
Specifications
Una Specification<T> es un criterio reutilizable escrito con la API Criteria de JPA (módulo 16). El repositorio debe heredar de JpaSpecificationExecutor<T>:
public final class EmpleadoSpecs {

    private EmpleadoSpecs() { }

    public static Specification<Empleado> oficio(String oficio) {
        return (raiz, consulta, cb) -> oficio == null || oficio.isBlank()
                ? null                                   // null = sin filtro
                : cb.equal(raiz.get("oficio"), oficio.toUpperCase());
    }

    public static Specification<Empleado> salarioMinimo(BigDecimal minimo) {
        return (raiz, consulta, cb) -> minimo == null
                ? null
                : cb.greaterThanOrEqualTo(raiz.get("salario"), minimo);
    }

    public static Specification<Empleado> departamento(Integer deptId) {
        return (raiz, consulta, cb) -> deptId == null
                ? null
                : cb.equal(raiz.get("departamento").get("id"), deptId);
    }

    public static Specification<Empleado> textoEnNombre(String texto) {
        return (raiz, consulta, cb) -> {
            if (texto == null || texto.isBlank()) return null;
            String patron = "%" + texto.toLowerCase() + "%";
            return cb.or(cb.like(cb.lower(raiz.get("nombre")), patron),
                         cb.like(cb.lower(raiz.get("apellidos")), patron));
        };
    }
}
Se combinan con and, or, not, Specification.allOf(...) o anyOf(...). Un criterio que devuelve null simplemente no filtra, así que el servicio de empleados queda así de limpio (lo usan la API y la web):
public Page<Empleado> buscar(String texto, String oficio, Integer deptId, BigDecimal salarioMin,
                             Pageable pageable) {
    Specification<Empleado> spec = Specification.allOf(
            EmpleadoSpecs.textoEnNombre(texto),
            EmpleadoSpecs.oficio(oficio),
            EmpleadoSpecs.departamento(deptId),
            EmpleadoSpecs.salarioMinimo(salarioMin));
    return empleados.findAll(spec, pageable);
}
Query by Example (QBE)
Con QBE creas una entidad «sonda» con los valores que buscas; los campos null se ignoran. Viene incluido en JpaRepository:
Empleado sonda = new Empleado(null, null, null, "ANALISTA", null, null);
List<Empleado> analistas = empleados.findAll(Example.of(sonda));

// Con un ExampleMatcher puedes pedir "contiene" e ignorar mayúsculas
ExampleMatcher matcher = ExampleMatcher.matching()
        .withMatcher("apellidos", m -> m.contains().ignoreCase());
Salida real de ambas técnicas:
### 15 Specification: oficio PROGRAMADOR y salario >= 2500
  121 Raquel Molina Prieto   PROGRAMADOR       2800.00
  122 Iván Castro Méndez     PROGRAMADOR       2600.00

### 16 Query by Example: oficio = ANALISTA
  120 Pablo Moreno Herrera   ANALISTA          3500.00
  141 Álvaro Peña Cano       ANALISTA          2700.00
| Specifications | Query by Example | |
|---|---|---|
| Expresividad | Total: rangos, or, joins, subconsultas | Solo igualdad y comparaciones de texto |
| Código | Más verboso (Criteria API) | Mínimo |
| Ideal para | Formularios de búsqueda avanzada | Filtros sencillos de «coincide con…» |
10. El problema N+1 y @EntityGraph
Ya conoces el problema del módulo 16: cargas una lista de N empleados con una consulta y, al recorrerla accediendo a e.getDepartamento().getNombre(), Hibernate lanza una consulta más por cada departamento distinto que no esté ya en el contexto. Con Spring Data ocurre exactamente igual. La demostración recorre los 24 empleados obtenidos con findAll():
tx.executeWithoutResult(estado -> {
    List<Empleado> todos = empleados.findAll();
    long conDept = todos.stream().filter(e -> e.getDepartamento() != null)
            .map(e -> e.getDepartamento().getNombre()).distinct().count();
    System.out.println("  empleados: " + todos.size() + ", departamentos distintos: " + conDept);
});
Salida real (se han omitido las columnas de cada select):
15:28:42.653 INFO  DEMO : ---- inicio N+1 ----
15:28:42.946 DEBUG org.hibernate.SQL :
    select ...
    from
        empleados e1_0
15:28:43.407 DEBUG org.hibernate.SQL :
    select ...
    from
        departamentos d1_0
    where
        d1_0.dept_id=?
15:28:43.409 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [10]
15:28:43.426 DEBUG org.hibernate.SQL :
    select ...
    from
        departamentos d1_0
    where
        d1_0.dept_id=?
15:28:43.427 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [20]
15:28:43.434 DEBUG org.hibernate.SQL :
    select ...
    from
        departamentos d1_0
    where
        d1_0.dept_id=?
15:28:43.442 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [30]
15:28:43.450 DEBUG org.hibernate.SQL :
    select ...
    from
        departamentos d1_0
    where
        d1_0.dept_id=?
15:28:43.452 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [40]
15:28:43.458 DEBUG org.hibernate.SQL :
    select ...
    from
        departamentos d1_0
    where
        d1_0.dept_id=?
15:28:43.466 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [50]
15:28:43.491 DEBUG org.hibernate.SQL :
    select ...
    from
        departamentos d1_0
    where
        d1_0.dept_id=?
15:28:43.494 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [60]
  empleados: 24, departamentos distintos: 6
15:28:46.010 INFO  DEMO : ---- fin N+1 ----
Son 7 consultas: una para los empleados y otra por cada uno de los 6 departamentos distintos (10, 20, 30, 40, 50 y 60). Hibernate no repite la consulta de un departamento que ya está en el contexto de persistencia, por eso no son 24; con 1.000 empleados repartidos en 200 departamentos serían 201 consultas.
La solución: @EntityGraph
@EntityGraph indica qué relaciones deben cargarse en la misma consulta (con un join), sin escribir JPQL. Se puede poner en métodos derivados, en @Query o sobrescribiendo un método heredado:
@Override
@EntityGraph(attributePaths = {"departamento", "jefe"})
Page<Empleado> findAll(Pageable pageable);

@Override
@EntityGraph(attributePaths = {"departamento", "jefe"})
Page<Empleado> findAll(Specification<Empleado> spec, Pageable pageable);

@EntityGraph(attributePaths = {"departamento", "jefe"})
Optional<Empleado> findConRelacionesById(Integer id);
15:28:46.011 INFO  DEMO : ---- inicio EntityGraph ----
15:28:46.101 DEBUG org.hibernate.SQL :
    select
        e1_0.emp_id,
        e1_0.apellidos,
        e1_0.comision,
        d1_0.dept_id,
        d1_0.localidad,
        d1_0.nombre,
        d1_0.presupuesto,
        e1_0.email,
        e1_0.fecha_alta,
        j1_0.emp_id,
        j1_0.apellidos,
        j1_0.comision,
        j1_0.dept_id,
        j1_0.email,
        j1_0.fecha_alta,
        j1_0.jefe_id,
        j1_0.nombre,
        j1_0.oficio,
        j1_0.salario,
        j1_0.telefono,
        e1_0.nombre,
        e1_0.oficio,
        e1_0.salario,
        e1_0.telefono
    from
        empleados e1_0
    left join
        departamentos d1_0
            on d1_0.dept_id=e1_0.dept_id
    left join
        empleados j1_0
            on j1_0.emp_id=e1_0.jefe_id
    limit
        ?, ?
15:28:46.103 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [0]
15:28:46.107 TRACE org.hibernate.orm.jdbc.bind : binding parameter (2:INTEGER) <- [30]
  empleados: 24, departamentos distintos: 6
15:28:46.223 INFO  DEMO : ---- fin EntityGraph ----
Ahora es 1 sola consulta con dos left join (departamento y jefe). Ni siquiera hay count: como la primera página (30) no se llena con 24 empleados, Spring Data deduce el total sin preguntarlo.
💡 Consejo:
findConRelacionesByIdes una consulta derivada: lo que hay entrefindyBy(«ConRelaciones») se ignora, así que puedes usarlo para dar nombres descriptivos a variantes del mismo método con distintos entity graphs. EnPedidoRepositorycargamos un pedido completo con caminos anidados:@EntityGraph(attributePaths = {"cliente", "empleado", "lineas", "lineas.producto"}).
La alternativa clásica es join fetch en una @Query:
@Query("select e from Empleado e left join fetch e.departamento where e.oficio = :oficio")
List<Empleado> conDepartamentoPorOficio(@Param("oficio") String oficio);
LazyInitializationException
Con open-in-view=false, si un controlador accede a una relación perezosa que no se cargó, obtienes LazyInitializationException: could not initialize proxy - no Session. No es un fallo de Spring: te está diciendo que esa pantalla necesita datos que no has pedido. La solución correcta es cargarlos en el repositorio (con @EntityGraph o join fetch) o convertir a DTO dentro de la transacción, no volver a activar Open Session in View.
11. Auditoría: fechas automáticas
Muchas tablas tienen columnas como «fecha de alta» o «última modificación» que nadie debería rellenar a mano. Spring Data las rellena con la auditoría:
- Activa la auditoría con
@EnableJpaAuditingen una clase de configuración:
@Configuration
@EnableJpaAuditing
public class JpaConfig {
}
- Registra el listener en la entidad y anota los campos:
@Entity
@Table(name = "productos")
@EntityListeners(AuditingEntityListener.class)
public class Producto {
    ...
    @CreatedDate
    @Column(name = "fecha_alta", updatable = false)
    private LocalDate fechaAlta;
    ...
}
Al crear un producto por la API (módulo 20), el INSERT real lleva la fecha del día sin que el servicio la toque:
14:14:40.584 DEBUG org.hibernate.SQL :
    insert
    into
        productos
        (categoria_id, descatalogado, descripcion, fecha_alta, nombre, precio, stock)
    values
        (?, ?, ?, ?, ?, ?, ?)
14:14:40.591 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [5]
14:14:40.592 TRACE org.hibernate.orm.jdbc.bind : binding parameter (2:VARCHAR) <- [N]
14:14:40.658 TRACE org.hibernate.orm.jdbc.bind : binding parameter (3:VARCHAR) <- [Alfombrilla de 90 x 40 cm con base antideslizante]
14:14:40.659 TRACE org.hibernate.orm.jdbc.bind : binding parameter (4:DATE) <- [2026-10-04]
14:14:40.662 TRACE org.hibernate.orm.jdbc.bind : binding parameter (5:VARCHAR) <- [Alfombrilla gaming XL]
14:14:40.695 TRACE org.hibernate.orm.jdbc.bind : binding parameter (6:NUMERIC) <- [24.90]
14:14:40.698 TRACE org.hibernate.orm.jdbc.bind : binding parameter (7:INTEGER) <- [50]
El parámetro 4 (fecha_alta) vale 2026-10-04, la fecha del día en que se hizo la prueba, sin que ProductoService.crear la asigne: la pone AuditingEntityListener justo antes del INSERT. Fíjate también en el parámetro 2: el boolean descatalogado se guarda como N gracias al SiNoConverter.
| Anotación | Se rellena con | Cuándo |
|---|---|---|
@CreatedDate | Fecha/hora actual | Al insertar |
@LastModifiedDate | Fecha/hora actual | Al insertar y en cada actualización |
@CreatedBy | Usuario actual (de un bean AuditorAware) | Al insertar |
@LastModifiedBy | Usuario actual | Al insertar y actualizar |
Los campos pueden ser LocalDate, LocalDateTime, Instant… Para @CreatedBy y @LastModifiedBy hay que declarar un bean AuditorAware<String> que diga quién es el usuario; lo haremos con Spring Security en el módulo 22.
💡 Consejo: Si muchas entidades comparten las columnas de auditoría, crea una superclase
@MappedSuperclasscon@EntityListeners(AuditingEntityListener.class)y los campos anotados, y haz que las entidades hereden de ella. En EMPRESA solo tenemosfecha_alta, por eso la auditoría está enProductodirectamente.
12. Transacciones en la capa de servicio
Las transacciones ya las conoces (módulos 13 y 17). En una aplicación Spring Boot la regla es sencilla: la transacción la abre el servicio, porque es el que sabe qué operaciones forman una unidad de trabajo.
@Service
@Transactional(readOnly = true)        // por defecto, todos los métodos son de solo lectura
public class PedidoService {

    public Pedido buscar(Integer id) { ... }               // hereda readOnly = true

    @Transactional                                         // escritura: sobrescribe readOnly
    public Pedido crear(NuevoPedidoRequest req) {
        Cliente cliente = clientes.findById(req.clienteId())
                .orElseThrow(() -> new RecursoNoEncontradoException("cliente", req.clienteId()));
        ...
        Pedido pedido = new Pedido(cliente, empleado);
        for (NuevoPedidoRequest.Linea l : req.lineas()) {
            Producto producto = productos.findById(l.productoId())
                    .orElseThrow(() -> new RecursoNoEncontradoException("producto", l.productoId()));
            if (producto.getStock() < l.cantidad()) {
                throw new ReglaNegocioException("Stock insuficiente de " + producto.getNombre()
                        + ": hay " + producto.getStock() + " y se piden " + l.cantidad());
            }
            producto.setStock(producto.getStock() - l.cantidad());   // dirty checking → UPDATE
            pedido.anadirLinea(producto, l.cantidad(), l.descuento());
        }
        return pedidos.save(pedido);          // cascade ALL: inserta también las líneas
    }
}
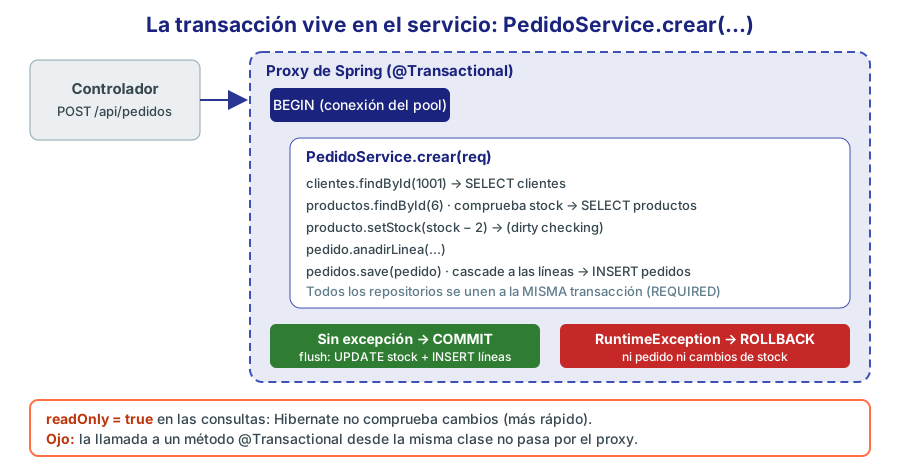 Figura 5. La transacción la gestiona el proxy de Spring alrededor del método del servicio.
Comprobación real del rollback
Primero creamos un pedido válido de 3 monitores y 3 ratones: el stock del ratón (producto 6) baja de 200 a 197. Después intentamos un pedido de 2 ratones y 10 torres Workstation (producto 5, del que solo hay 4). La primera línea llega a descontar el stock del ratón en memoria, pero la segunda lanza ReglaNegocioException (una RuntimeException) y Spring hace rollback de todo. Respuestas reales de la API:
POST /api/pedidos (pedido-nuevo.json)      -> HTTP/1.1 201  pedido 5025, total 455.85
GET  /api/productos/6 y /5                 -> producto 6 (Ratón inalámbrico): stock 197 | producto 5 (Torre Workstation): stock 4
POST /api/pedidos (pedido-sin-stock.json)  -> HTTP/1.1 409
    {
      "detail": "Stock insuficiente de Torre Workstation: hay 4 y se piden 10",
      "instance": "/api/pedidos",
      "status": 409,
      "title": "Operación no permitida",
      "type": "https://empresa.es/errores/regla-negocio"
    }
GET  /api/productos/6 y /5                 -> producto 6 (Ratón inalámbrico): stock 197 | producto 5 (Torre Workstation): stock 4
El stock del ratón sigue en 197: la modificación de la primera línea nunca llegó a la base de datos.
Reglas que debes recordar
| Regla | Detalle |
|---|---|
| ¿Qué provoca rollback? | Las RuntimeException y los Error. Las excepciones comprobadas hacen commit salvo que indiques @Transactional(rollbackFor = Exception.class) |
readOnly = true | Hibernate no comprueba cambios al final (dirty checking) y el driver puede optimizar. Úsalo en todas las consultas |
| Autoinvocación | Si un método de la clase llama a otro método @Transactional de la misma clase, no pasa por el proxy y su anotación se ignora |
Métodos public | La anotación se aplica a métodos públicos llamados desde fuera del bean |
| Repositorios | Los métodos heredados de SimpleJpaRepository ya son transaccionales (lectura por defecto, escritura en save/delete); si no hay transacción, cada llamada abre la suya |
@Modifying | Necesita una transacción de escritura activa |
Propagación
La propagación decide qué pasa cuando un método transaccional llama a otro:
| Propagación | Comportamiento |
|---|---|
REQUIRED (por defecto) | Se une a la transacción existente o crea una nueva |
REQUIRES_NEW | Suspende la actual y abre una nueva independiente (útil para registrar una auditoría que debe guardarse aunque la operación principal falle) |
SUPPORTS | Usa la transacción si existe; si no, se ejecuta sin ella |
MANDATORY | Exige una transacción existente; si no la hay, lanza excepción |
NOT_SUPPORTED | Suspende la transacción actual y se ejecuta sin ella |
NEVER | Lanza excepción si hay una transacción activa |
NESTED | Subtransacción con savepoint (con DataSourceTransactionManager/JDBC) |
@Transactional(propagation = Propagation.REQUIRES_NEW)
public void registrarIntento(String operacion) { ... }   // en OTRO bean, para que pase por el proxy
13. Carga de datos iniciales
Spring Boot puede ejecutar scripts SQL al arrancar (SQL initialization):
| Propiedad | Para qué |
|---|---|
spring.sql.init.mode | embedded (por defecto: solo con H2/HSQL/Derby), always, never |
spring.sql.init.schema-locations | Scripts de esquema (por defecto classpath:schema.sql) |
spring.sql.init.data-locations | Scripts de datos (por defecto classpath:data.sql) |
spring.jpa.defer-datasource-initialization | true si quieres que data.sql se ejecute después de que Hibernate cree las tablas con ddl-auto |
En empresa-app seguimos dos estrategias según el entorno:
- MySQL (
dev,prod): el esquema y los datos se cargan una vez, a mano, con los scripts oficiales de EMPRESA (empresa_mysql_crear.sqlyempresa_mysql_datos.sql). La aplicación no los ejecuta (no queremos que cada arranque borre y recree los datos) y Hibernate solo valida. - H2 (
h2y pruebas): la base de datos está en memoria y nace vacía en cada arranque, así que Boot ejecuta en cada inicio copias de esos mismos scripts guardadas ensrc/main/resources/db/h2/(schema.sqlydata.sql; solo se les ha quitado la líneaSET NAMES utf8mb4, propia de MySQL).
⚠️ Importante: En una aplicación real, el esquema evoluciona (nuevas columnas, índices…). Para gestionar esos cambios de forma versionada se usan herramientas de migraciones como Flyway o Liquibase (
spring-boot-starter-flyway): ejecutanV1__crear.sql,V2__nueva_columna.sql… una sola vez cada uno y llevan el control en una tabla. Es la evolución natural deschema.sql.
14. Ver el SQL generado
Es imprescindible mirar el SQL que genera Hibernate para detectar consultas de más (N+1) o mal planteadas. Hay dos formas:
# Opción rápida: imprime el SQL en la salida estándar, sin formato y sin parámetros
spring.jpa.show-sql=true

# Opción recomendada: por el sistema de logging (con hora, hilo...), formateado y con parámetros
spring.jpa.properties.hibernate.format_sql=true
logging.level.org.hibernate.SQL=debug
logging.level.org.hibernate.orm.jdbc.bind=trace
Con la segunda opción (la del perfil dev), cada sentencia aparece así (salida real al pedir el producto 6; en este y otros extractos del módulo se ha abreviado el prefijo de cada línea del log a la hora, el nivel y el logger):
14:14:26.166 DEBUG org.hibernate.SQL :
    select
        p1_0.producto_id,
        p1_0.categoria_id,
        c1_0.categoria_id,
        c1_0.nombre,
        c1_0.categoria_padre_id,
        p1_0.descatalogado,
        p1_0.descripcion,
        p1_0.fecha_alta,
        p1_0.nombre,
        p1_0.precio,
        p1_0.stock
    from
        productos p1_0
    join
        categorias c1_0
            on c1_0.categoria_id=p1_0.categoria_id
    where
        p1_0.producto_id=?
14:14:26.168 TRACE org.hibernate.orm.jdbc.bind : binding parameter (1:INTEGER) <- [6]
💡 Consejo: Para medir de verdad, activa las estadísticas de Hibernate con
spring.jpa.properties.hibernate.generate_statistics=true: al final de cada sesión escribe cuántas sentencias JDBC se han ejecutado y cuánto han tardado. Y nunca dejes el niveltracede los parámetros en producción: puede escribir datos personales en el log.
15. H2 para desarrollo y la consola H2
H2 es una base de datos escrita en Java que puede funcionar en memoria: arranca en milisegundos, no necesita instalación y desaparece al parar la aplicación. Es ideal para desarrollar sin MySQL o para pruebas automáticas (módulo 23). Con el modo de compatibilidad MySQL acepta casi todo el SQL de nuestros scripts.
El perfil h2 de empresa-app (application-h2.properties):
# ==========================================================
#  Perfil h2: base de datos en memoria con los datos de EMPRESA
#  (para desarrollar sin MySQL). Se ejecuta con --spring.profiles.active=h2
# ==========================================================
spring.datasource.url=jdbc:h2:mem:empresa;MODE=MySQL;DATABASE_TO_LOWER=TRUE;DEFAULT_NULL_ORDERING=HIGH
spring.datasource.username=sa
spring.datasource.password=

# Crear el esquema y cargar los datos con los scripts de EMPRESA adaptados a H2
spring.sql.init.mode=always
spring.sql.init.schema-locations=classpath:db/h2/schema.sql
spring.sql.init.data-locations=classpath:db/h2/data.sql
spring.jpa.hibernate.ddl-auto=validate

# Consola web de H2 en http://localhost:8080/h2-console
spring.h2.console.enabled=true
spring.h2.console.path=/h2-console

spring.jpa.show-sql=true
| Opción de la URL | Para qué |
|---|---|
jdbc:h2:mem:empresa | Base de datos en memoria llamada empresa (vive mientras la aplicación esté arrancada) |
MODE=MySQL | Acepta sintaxis de MySQL (AUTO_INCREMENT, DEFAULT (CURRENT_DATE)…) |
DATABASE_TO_LOWER=TRUE | Nombres de tablas y columnas en minúsculas, como en MySQL |
DEFAULT_NULL_ORDERING=HIGH | Los NULL se ordenan como en MySQL |
Arranca con:
./mvnw spring-boot:run -Dspring-boot.run.profiles=h2
y el log confirma: H2 console available at '/h2-console'. Database available at 'jdbc:h2:mem:empresa'.
💡 Consejo: En Spring Boot 4 la consola de H2 está en un módulo propio,
org.springframework.boot:spring-boot-h2console. Initializr lo añade automáticamente cuando eliges H2 Database junto con Spring Web; si partes de un proyecto antiguo, tendrás que añadirlo a mano.
La consola web
Abre http://localhost:8080/h2-console. En la pantalla de conexión escribe la misma URL JDBC del perfil (jdbc:h2:mem:empresa, sin las opciones), usuario sa y contraseña vacía:
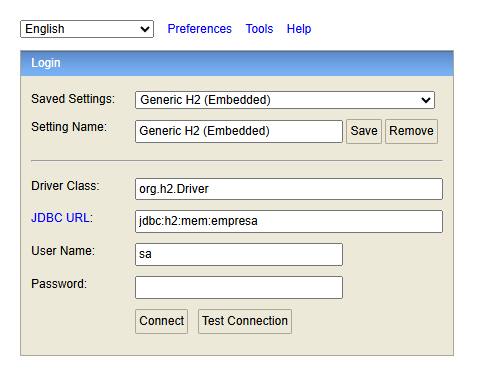 Figura 6. Pantalla de conexión de la consola H2. Captura real.
Ya conectado, a la izquierda verás las tablas de EMPRESA y podrás ejecutar cualquier consulta:
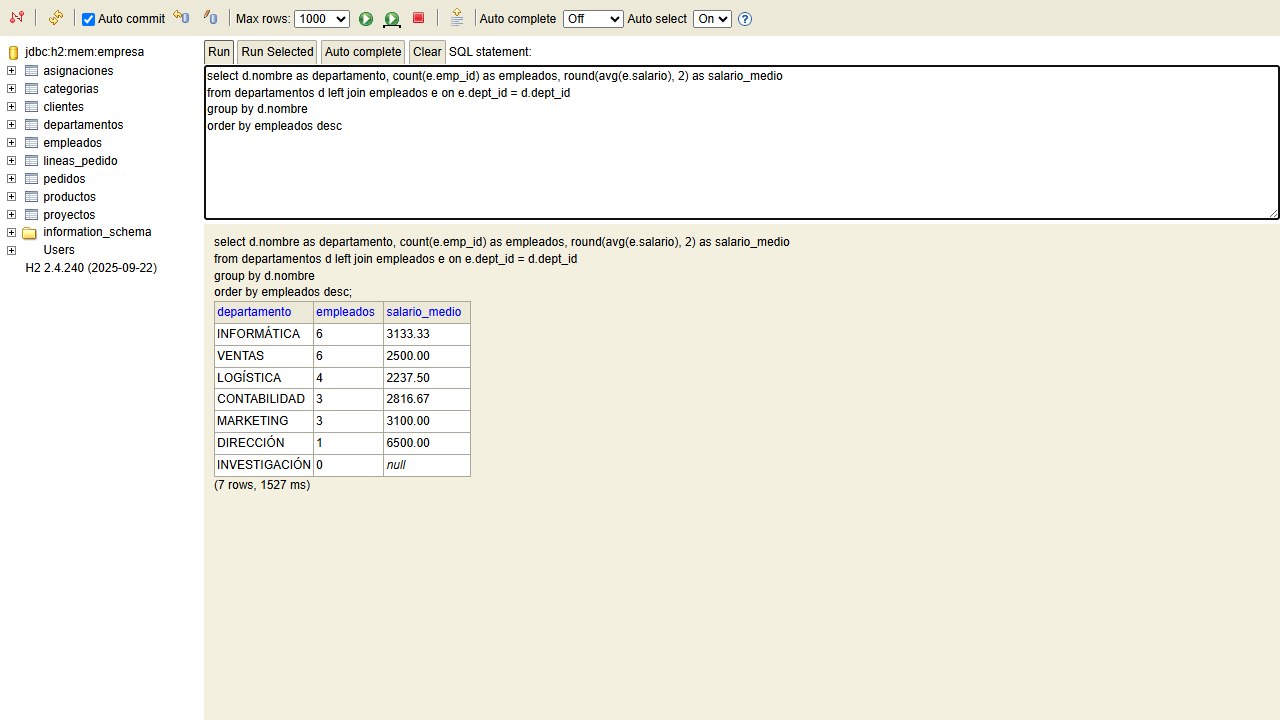 Figura 7. Consulta SQL en la consola H2 sobre los datos de EMPRESA cargados al arrancar. Captura real.
⚠️ Importante: La consola de H2 permite ejecutar cualquier SQL sin autenticación propia de la aplicación. Actívala solo en un perfil de desarrollo y nunca la expongas en un servidor accesible. Recuerda también que lo que hagas en H2 en memoria se pierde al parar la aplicación.
H2 no es idéntico a MySQL: funciones propias, algunos tipos y detalles del SQL nativo pueden diferir. Por eso la consulta nativa contratadosEnAnio usa year(), que existe en ambas. Para pruebas que deban reproducir exactamente MySQL, en el módulo 23 usarás Testcontainers con un MySQL real en Docker.
16. Ejercicios
Ejercicio 1: Consultas derivadas de clientes
Añade a ClienteRepository métodos derivados para obtener: los clientes de una ciudad ordenados por nombre; los clientes con límite de crédito mayor o igual que una cantidad, del mayor al menor; el número de clientes de una provincia; y los clientes sin email. Pruébalos con Madrid, 10000, Valencia y sin parámetros.
Ver solución
public interface ClienteRepository extends JpaRepository<Cliente, Integer> {

    List<Cliente> findByCiudadOrderByNombre(String ciudad);

    List<Cliente> findByLimiteCreditoGreaterThanEqualOrderByLimiteCreditoDesc(BigDecimal minimo);

    long countByProvincia(String provincia);

    List<Cliente> findByEmailIsNull();
}
clientes.findByCiudadOrderByNombre("Madrid").forEach(c -> System.out.println("  " + c));
clientes.findByLimiteCreditoGreaterThanEqualOrderByLimiteCreditoDesc(new BigDecimal("10000"))
        .forEach(c -> System.out.println("  " + c.getNombre() + " " + c.getLimiteCredito()));
System.out.println("  Valencia: " + clientes.countByProvincia("Valencia"));
clientes.findByEmailIsNull().forEach(c -> System.out.println("  " + c));
Salida real:
  Cliente[1004, Academia Nova, Madrid]
  Cliente[1003, María José Herrera, Madrid]
  Construcciones Levante S.A. 25000.00
  Instituto Tecnológico Sur 20000.00
  Hotel Mar Azul S.L. 15000.00
  Talleres Martín S.L. 10000.00
  Valencia: 2
  Cliente[1006, Antonio Ruiz Pérez, Sevilla]
  Cliente[1011, Panadería La Espiga, Valladolid]
Recuerda que las propiedades son las de la entidad Java (limiteCredito), no las columnas (limite_credito).
Ejercicio 2: Productos que nunca se han vendido
Escribe en ProductoRepository una consulta JPQL que devuelva los productos que no aparecen en ninguna línea de pedido.
Ver solución
@Query("""
       select p from Producto p
       where not exists (select l from LineaPedido l where l.producto = p)
       order by p.id""")
List<Producto> nuncaVendidos();
Salida real:
Producto[14, Altavoz Inteligente, 49.00 €]
Con not exists y una subconsulta correlacionada expresamos «no hay ninguna línea de este producto». Coincide con lo que dice el script de datos: el producto 14 está descatalogado y nunca se ha vendido.
Ejercicio 3: Facturación por cliente
Crea un record FacturacionCliente(String cliente, long pedidos, BigDecimal total) y una consulta en PedidoRepository que calcule, para cada cliente, el número de pedidos no cancelados y el total facturado (cantidad × precio × (1 − descuento/100)), ordenado de mayor a menor total. Muestra los tres primeros.
Ver solución
package es.curso.empresa.dto;

import java.math.BigDecimal;

public record FacturacionCliente(String cliente, Long pedidos, BigDecimal total) { }
@Query("""
       select new es.curso.empresa.dto.FacturacionCliente(
              c.nombre, count(distinct p), sum(l.cantidad * l.precioUnitario * (1 - l.descuento / 100)))
       from LineaPedido l join l.pedido p join p.cliente c
       where p.estado <> es.curso.empresa.modelo.EstadoPedido.CANCELADO
       group by c.nombre
       order by sum(l.cantidad * l.precioUnitario * (1 - l.descuento / 100)) desc""")
List<FacturacionCliente> facturacionPorCliente();
pedidos.facturacionPorCliente().stream().limit(3).forEach(f -> System.out.println(" " + f));
Salida real:
  FacturacionCliente[cliente=Instituto Tecnológico Sur, pedidos=2, total=20602.55000000]
  FacturacionCliente[cliente=Construcciones Levante S.A., pedidos=3, total=14260.19000000]
  FacturacionCliente[cliente=Academia Nova, pedidos=2, total=7891.30000000]
En JPQL los valores de un enumerado se escriben con su nombre completo (es.curso.empresa.modelo.EstadoPedido.CANCELADO), y count(distinct p) cuenta pedidos, no líneas. El total sale con muchos decimales porque la base de datos no redondea: lo haríamos al mostrarlo (setScale(2, RoundingMode.HALF_UP)).
Ejercicio 4: Paginar los clientes
Muestra la primera y la segunda página de clientes, de 4 en 4, ordenados por límite de crédito descendente y, a igualdad, por nombre. Indica el total de páginas.
Ver solución
Sort orden = Sort.by(Sort.Order.desc("limiteCredito"), Sort.Order.asc("nombre"));
for (int n = 0; n < 2; n++) {
    Page<Cliente> pagina = clientes.findAll(PageRequest.of(n, 4, orden));
    System.out.printf("  Página %d de %d:%n", pagina.getNumber() + 1, pagina.getTotalPages());
    pagina.forEach(c -> System.out.println("    " + c.getNombre() + " " + c.getLimiteCredito()));
}
Salida real:
  Página 1 de 4:
    Construcciones Levante S.A. 25000.00
    Instituto Tecnológico Sur 20000.00
    Hotel Mar Azul S.L. 15000.00
    Talleres Martín S.L. 10000.00
  Página 2 de 4:
    Academia Nova 8000.00
    Diseños Creativos S.L. 7000.00
    Clínica Dental Sonrisa 6000.00
    Gestoría Delta 5000.00
El segundo criterio de orden (nombre) garantiza un orden estable cuando dos clientes tienen el mismo límite.
Ejercicio 5: Traspaso de empleados entre departamentos
Crea en EmpleadoService un método transaccional traspasar(Integer origenId, Integer destinoId) que mueva todos los empleados de un departamento a otro con una única sentencia update y devuelva cuántos ha movido. Si el departamento de destino no existe, debe lanzar RecursoNoEncontradoException y no cambiar nada. Prueba a traspasar Logística (60) a Investigación (70) y a un departamento 99.
Ver solución
// EmpleadoRepository
@Modifying(clearAutomatically = true)
@Query("update Empleado e set e.departamento = :destino where e.departamento = :origen")
int traspasar(@Param("origen") Departamento origen, @Param("destino") Departamento destino);
// EmpleadoService
@Transactional
public int traspasar(Integer origenId, Integer destinoId) {
    Departamento origen = departamentos.findById(origenId)
            .orElseThrow(() -> new RecursoNoEncontradoException("departamento", origenId));
    Departamento destino = departamentos.findById(destinoId)
            .orElseThrow(() -> new RecursoNoEncontradoException("departamento", destinoId));
    int movidos = empleados.traspasar(origen, destino);
    log.info("Traspasados {} empleados de {} a {}", movidos, origen.getNombre(), destino.getNombre());
    return movidos;
}
Prueba (después se restauran los datos):
System.out.println("  movidos: " + empleadoService.traspasar(60, 70));
System.out.println("  en 70: " + empleados.countByDepartamentoId(70));
try {
    empleadoService.traspasar(50, 99);
} catch (RecursoNoEncontradoException ex) {
    System.out.println("  " + ex.getMessage() + " -> en 50 siguen " + empleados.countByDepartamentoId(50));
}
System.out.println("  restaurar: " + empleadoService.traspasar(70, 60));   // dejamos EMPRESA como estaba
Salida real:
  movidos: 4
  en 70: 4
  No existe departamento con id 99 -> en 50 siguen 3
  restaurar: 4
Y en el log, el mensaje del servicio: Traspasados 4 empleados de LOGÍSTICA a INVESTIGACIÓN.
Las comprobaciones de existencia se hacen antes del update, pero aunque se hicieran después, la excepción provocaría el rollback del update porque todo ocurre dentro de la misma transacción.
Ejercicio 6: Búsqueda avanzada de productos
Haz que ProductoRepository herede también de JpaSpecificationExecutor<Producto> y crea una clase ProductoSpecs con criterios opcionales: precio mínimo, precio máximo, categoría y «solo con stock». Busca los productos de entre 50 y 400 € con stock.
Ver solución
public final class ProductoSpecs {

    private ProductoSpecs() { }

    public static Specification<Producto> precioEntre(BigDecimal min, BigDecimal max) {
        return (r, q, cb) -> {
            if (min == null && max == null) return null;
            if (min == null) return cb.lessThanOrEqualTo(r.get("precio"), max);
            if (max == null) return cb.greaterThanOrEqualTo(r.get("precio"), min);
            return cb.between(r.get("precio"), min, max);
        };
    }

    public static Specification<Producto> categoria(Integer categoriaId) {
        return (r, q, cb) -> categoriaId == null ? null : cb.equal(r.get("categoria").get("id"), categoriaId);
    }

    public static Specification<Producto> conStock(boolean soloConStock) {
        return (r, q, cb) -> soloConStock ? cb.greaterThan(r.get("stock"), 0) : null;
    }
}
var spec = Specification.allOf(
        ProductoSpecs.precioEntre(new BigDecimal("50"), new BigDecimal("400")),
        ProductoSpecs.categoria(null),
        ProductoSpecs.conStock(true));
productos.findAll(spec, Sort.by("precio")).forEach(p ->
        System.out.println("  " + p.getNombre() + " " + p.getPrecio() + " (stock " + p.getStock() + ")"));
Salida real:
  Auriculares Bluetooth 59.90 (stock 80)
  Teclado mecánico 79.90 (stock 60)
  Disco SSD 1TB 89.90 (stock 70)
  Monitor 24 FHD 139.00 (stock 35)
  Impresora Láser 189.00 (stock 9)
  Silla Ergonómica 249.00 (stock 20)
  Tablet 10 279.00 (stock 14)
  Smartphone Gama Media 299.00 (stock 50)
  Monitor 27 4K 329.00 (stock 12)
  Mesa Elevable 399.00 (stock 6)
El criterio de categoría devuelve null y no filtra. El Altavoz Inteligente (49 €) queda fuera por precio y por no tener stock.
Ejercicio 7 (propuesto): Fecha de última modificación
Añade a la tabla productos una columna fecha_modificacion DATETIME (con un ALTER TABLE en tu base de datos local y en db/h2/schema.sql) y mapeala con @LastModifiedDate como LocalDateTime. Comprueba con la API del módulo 20 que cambia al hacer un PATCH.
Ejercicio 8 (propuesto): Slice frente a Page
Crea en PedidoRepository un método Slice<Pedido> findByClienteId(Integer clienteId, Pageable p) y compara en el log el SQL generado con el de un Page. ¿Cuántas consultas hace cada uno?
Ejercicio 9 (propuesto): Query by Example de clientes
Usando un ExampleMatcher, busca los clientes cuyo nombre contenga «s.l.» sin distinguir mayúsculas y que sean de la provincia de Valencia.
Ejercicio 10 (propuesto): Consulta nativa con paginación
Escribe una consulta nativa que devuelva los empleados con su número de proyectos asignados (tabla asignaciones, que no está mapeada) como proyección de interfaz, paginada. Necesitarás el atributo countQuery de @Query.
Ejercicio 11 (propuesto): Descatalogar productos agotados
Implementa con @Modifying un método que marque como descatalogados ('S') todos los productos con stock 0 de una categoría, y un método de servicio transaccional que lo use y devuelva el número de filas afectadas.
Ejercicio 12 (propuesto): Explora EMPRESA en la consola H2
Arranca con el perfil h2, entra en la consola y escribe una consulta que muestre, para cada departamento, el nombre del empleado mejor pagado. Compara el resultado con el de la misma consulta en MySQL.
Resumen
| Concepto | Sintaxis / ejemplo |
|---|---|
| Repositorio | interface EmpleadoRepository extends JpaRepository<Empleado, Integer> |
| CRUD heredado | save, findById (Optional), findAll, count, deleteById, getReferenceById |
| Consulta derivada | findByDepartamentoNombreAndSalarioGreaterThan(...), countBy..., existsBy..., findTop3By... |
| JPQL | @Query("select e from Empleado e where e.salario > :min") + @Param("min") |
| SQL nativo | @Query(value = "select * from empleados ...", nativeQuery = true) |
| Modificación | @Modifying(clearAutomatically = true) @Query("update ...") en una transacción |
| Paginación | Page<T> m(..., Pageable p), PageRequest.of(pág, tamaño, Sort.by("campo")), Slice<T> |
| Ordenación | Sort.by("apellidos"), Sort.by(Order.desc("salario")) |
| Proyección interfaz | interface EmpleadoResumen { String getNombre(); } |
| Proyección record | record ProductoPrecio(String nombre, BigDecimal precio) o select new ... |
| Specifications | JpaSpecificationExecutor<T>, Specification.allOf(...), findAll(spec, pageable) |
| Query by Example | findAll(Example.of(sonda, matcher)) |
| Evitar N+1 | @EntityGraph(attributePaths = {"departamento", "jefe"}) o join fetch |
| Auditoría | @EnableJpaAuditing + @EntityListeners(AuditingEntityListener.class) + @CreatedDate |
| Transacciones | @Transactional(readOnly = true) en la clase de servicio y @Transactional en las escrituras |
| Datos iniciales | spring.sql.init.mode, schema-locations, data-locations |
| Ver SQL | logging.level.org.hibernate.SQL=debug, org.hibernate.orm.jdbc.bind=trace |
| H2 | jdbc:h2:mem:empresa;MODE=MySQL, spring.h2.console.enabled=true, /h2-console |