Módulo 14: JPA e Hibernate
Objetivos del módulo
- Entender el desajuste objeto-relacional y qué problema resuelve un ORM
- Distinguir Jakarta Persistence 3.2 (la especificación) de Hibernate 7.4 (la implementación)
- Crear un proyecto Maven con Hibernate y el driver de MySQL, configurado con
persistence.xmlo por código - Elegir el valor correcto de
hibernate.hbm2ddl.autoy saber por qué con una base de datos existente se usavalidate - Mapear entidades con
@Entity,@Table,@Id,@GeneratedValue,@Column,@Enumerated,@Transient,@Lob, conversores y tipos dejava.time - Trabajar con
EntityManagerFactory,EntityManagery transacciones - Realizar operaciones CRUD con
persist,find,mergeyremove - Conocer el ciclo de vida de una entidad (nuevo, gestionado, desconectado y eliminado)
- Comprender el contexto de persistencia, la caché de primer nivel, el dirty checking y el flush, viendo el SQL real que genera Hibernate
- Mapear claves compuestas (
@EmbeddedIde@IdClass) y objetos embebibles (@Embeddable) - Mapear las tablas de la base de datos EMPRESA que ya conoces de los módulos de JDBC
1. El desajuste objeto-relacional
En los módulos 12 y 13 accediste a la base de datos EMPRESA con JDBC. Recuerda cuánto código hacía falta solo para leer un empleado:
String sql = "SELECT emp_id, nombre, apellidos, email, fecha_alta, salario, dept_id FROM empleados WHERE emp_id = ?";
try (Connection con = dataSource.getConnection();
     PreparedStatement ps = con.prepareStatement(sql)) {
    ps.setInt(1, id);
    try (ResultSet rs = ps.executeQuery()) {
        if (rs.next()) {
            Empleado e = new Empleado();
            e.setId(rs.getInt("emp_id"));
            e.setNombre(rs.getString("nombre"));
            e.setApellidos(rs.getString("apellidos"));
            e.setEmail(rs.getString("email"));
            e.setFechaAlta(rs.getDate("fecha_alta").toLocalDate());
            e.setSalario(rs.getBigDecimal("salario"));
            e.setDeptId(rs.getObject("dept_id", Integer.class));   // ¿y si queremos el Departamento?
            return Optional.of(e);
        }
        return Optional.empty();
    }
}
Y eso es solo un SELECT por clave primaria. Para el INSERT, el UPDATE y el DELETE hay que escribir otro tanto, y repetirlo para cada una de las nueve tablas de EMPRESA. Con JPA, la misma lectura es una línea:
Empleado e = em.find(Empleado.class, id);
¿Por qué hace falta tanto código con JDBC? Porque Java y la base de datos organizan la información de formas muy distintas. A esta diferencia se la llama desajuste objeto-relacional (object-relational impedance mismatch).
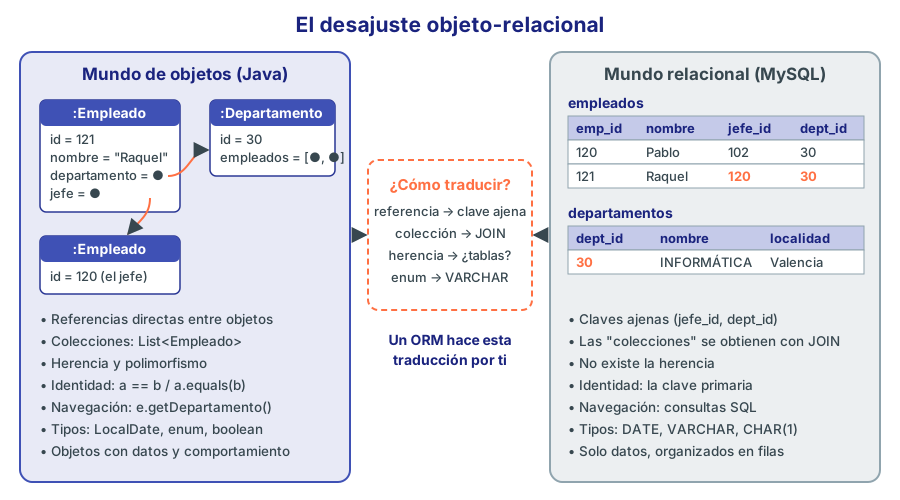
Figura 1. El desajuste objeto-relacional: el mismo dato visto como objetos y como filas.
| Aspecto | En Java (objetos) | En la base de datos (tablas) |
|---|---|---|
| Identidad | Dos referencias son el mismo objeto si a == b; iguales si a.equals(b) | Dos filas son la misma si tienen la misma clave primaria |
| Asociaciones | Referencias directas: empleado.getDepartamento() | Claves ajenas: empleados.dept_id → departamentos.dept_id |
| Colecciones | List<Empleado> dentro de Departamento | No existen: se reconstruyen con un JOIN o un WHERE dept_id = ? |
| Herencia | PagoTarjeta extends Pago | No existe: hay que simularla con una o varias tablas |
| Granularidad | Puedes tener clases pequeñas (Ubicacion, Dinero) dentro de otras | Todo son columnas de una tabla |
| Navegación | Se recorre el grafo de objetos: e.getJefe().getJefe() | Se lanzan consultas, idealmente pocas y con JOIN |
| Tipos | LocalDate, enum, boolean, BigDecimal | DATE, VARCHAR, CHAR(1), DECIMAL(8,2) |
📘 Concepto: El desajuste objeto-relacional es el conjunto de diferencias entre el modelo orientado a objetos (clases, referencias, herencia, colecciones) y el modelo relacional (tablas, filas, claves ajenas). Cada vez que guardas o lees un objeto alguien tiene que traducir de un mundo al otro: con JDBC lo haces tú a mano; con un ORM lo hace la biblioteca.
2. ¿Qué es un ORM?
Un ORM (Object-Relational Mapping, mapeo objeto-relacional) es una biblioteca que traduce automáticamente entre objetos y tablas. Tú describes una vez cómo se corresponde cada clase con su tabla (con anotaciones) y a partir de ahí trabajas con objetos: el ORM genera el SQL, lo ejecuta con JDBC y convierte los resultados en objetos.
💡 Consejo: Una buena analogía es un intérprete simultáneo. Tú hablas en “Java” (objetos, métodos, colecciones) y la base de datos entiende “SQL”. El ORM traduce en ambas direcciones y, como buen intérprete, también recuerda lo que ya se ha dicho (la caché) para no repetir preguntas.
Qué te da un ORM
| Ventaja | Explicación |
|---|---|
| Menos código repetitivo | Desaparece el mapeo manual ResultSet → objeto y los INSERT/UPDATE escritos a mano |
| Trabajar con objetos | Navegas por relaciones (pedido.getCliente().getNombre()) en lugar de escribir JOIN |
| Independencia de la base de datos | El mismo código funciona en MySQL, PostgreSQL, Oracle o H2 (el ORM adapta el dialecto SQL) |
| Detección automática de cambios | Modificas un objeto y el ORM genera el UPDATE necesario (dirty checking) |
| Caché | No repite consultas de objetos que ya tiene en memoria |
| Consultas orientadas a objetos | JPQL consulta entidades y atributos, no tablas y columnas (módulo 16) |
Lo que NO te ahorra
Un ORM no te exime de saber SQL. Hibernate genera SQL, y si no entiendes ese SQL acabarás con aplicaciones lentas (el famoso problema N+1 del módulo 16). Por eso en este módulo verás siempre el SQL real que genera Hibernate.
⚠️ Importante: Un ORM no es la herramienta adecuada para todo. Para informes con consultas muy complejas, cargas masivas de millones de filas o procedimientos almacenados, JDBC (o
JdbcTemplateen Spring, módulo 17) sigue siendo la mejor opción. En una aplicación real es normal combinar ambos.
3. JPA y Hibernate
3.1 Un poco de historia
| Año | Hito |
|---|---|
| 2001 | Gavin King crea Hibernate como alternativa a los complejos entity beans de EJB 2 |
| 2006 | Nace JPA 1.0 (Java Persistence API) dentro de Java EE 5, inspirada en gran parte en Hibernate |
| 2009-2017 | JPA 2.0, 2.1 y 2.2 añaden Criteria API, conversores, entity graphs y soporte de java.time |
| 2019-2020 | Java EE pasa a la Fundación Eclipse como Jakarta EE; JPA se renombra Jakarta Persistence 3.0 y los paquetes cambian de javax.persistence a jakarta.persistence |
| 2022 | Jakarta Persistence 3.1 (UUID como identificador, nuevas funciones JPQL); Hibernate 6 |
| 2024 | Jakarta Persistence 3.2 (Jakarta EE 11): configuración programática, runInTransaction, records como embebibles, mejoras en JPQL |
| 2025-2026 | Hibernate 7 implementa Jakarta Persistence 3.2; la versión estable actual es la 7.4 |
⚠️ Importante: Si encuentras en Internet ejemplos con
import javax.persistence.*, son anteriores a 2020 y no compilan con Hibernate 6 o 7. Cambiajavax.persistenceporjakarta.persistence. Lo mismo ocurre con métodos de Hibernate que ya no existen: en Hibernate 7 se eliminaronSession.save(),update(),saveOrUpdate(),delete()yload(); se usan los métodos estándarpersist(),merge(),remove()ygetReference().
3.2 Especificación frente a implementación
Jakarta Persistence (seguiremos llamándola JPA, como hace todo el mundo) es una especificación: un documento y un conjunto de interfaces y anotaciones (jakarta.persistence-api.jar) que dicen qué debe hacer un ORM en Java. No contiene la lógica: no genera SQL ni habla con la base de datos.
Hibernate ORM es una implementación de esa especificación: el código que de verdad hace el trabajo. Hay otras (EclipseLink, que es la implementación de referencia, u OpenJPA), pero Hibernate es con diferencia la más usada y la que utiliza Spring Boot por defecto.
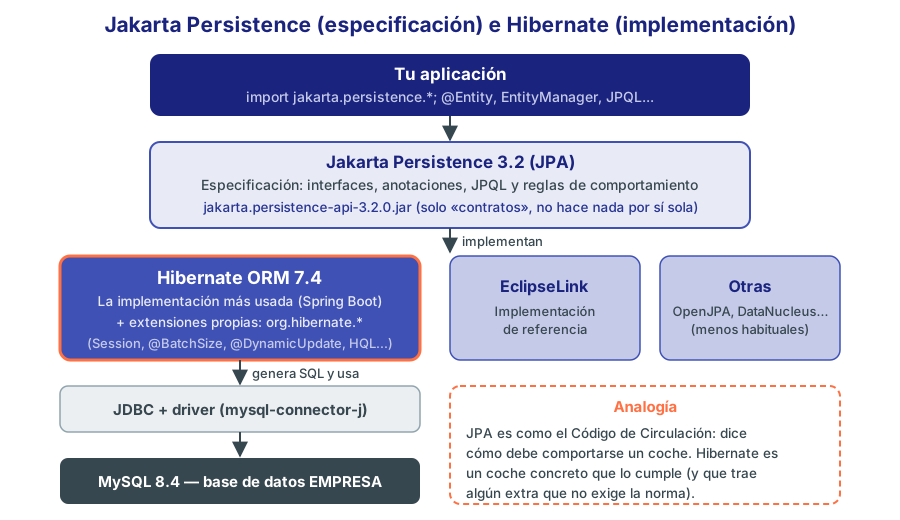
Figura 2. Relación entre Jakarta Persistence (especificación) e Hibernate (implementación).
| Jakarta Persistence (JPA) | Hibernate ORM | |
|---|---|---|
| Qué es | Especificación (estándar) | Implementación (producto) |
| Paquete | jakarta.persistence.* | org.hibernate.* |
| Interfaces principales | EntityManagerFactory, EntityManager, EntityTransaction, TypedQuery | SessionFactory, Session, Transaction (extienden las de JPA) |
| Lenguaje de consultas | JPQL | HQL (un superconjunto de JPQL) |
| Extras | — | @BatchSize, @DynamicUpdate, filtros, estadísticas, caché de segundo nivel, multitenencia… |
💡 Consejo: Programa contra las interfaces de JPA (
jakarta.persistence) siempre que puedas y usa las extensiones de Hibernate solo cuando aporten algo concreto. Así tu código es portable y, además, es lo que vas a ver en Spring Data JPA (módulo 19).
4. Preparar el proyecto
4.1 La base de datos EMPRESA
Usaremos la misma base de datos EMPRESA en MySQL 8.4 de los módulos de JDBC. Si no la tienes ya en marcha, arráncala con Docker y carga los scripts de ../recursos/:
# 1. Arrancar MySQL 8.4 con la base de datos empresa y el usuario curso/curso
docker run -d --name mysql-curso -p 3306:3306 \
  -e MYSQL_ROOT_PASSWORD=root -e MYSQL_DATABASE=empresa \
  -e MYSQL_USER=curso -e MYSQL_PASSWORD=curso \
  mysql:8.4

# 2. Crear las tablas y cargar los datos (desde la carpeta del curso)
docker exec -i mysql-curso mysql -ucurso -pcurso --default-character-set=utf8mb4 empresa < recursos/empresa_mysql_crear.sql
docker exec -i mysql-curso mysql -ucurso -pcurso --default-character-set=utf8mb4 empresa < recursos/empresa_mysql_datos.sql
Los scripts son empresa_mysql_crear.sql, empresa_mysql_datos.sql y, para empezar de cero, empresa_mysql_borrar.sql.
💡 Consejo: Algunos ejemplos de este módulo modifican datos y luego los restauran. Si en algún momento los datos quedan “raros”, ejecuta los tres scripts (borrar, crear y datos) y vuelves al estado inicial.
4.2 El proyecto Maven
Crea un proyecto Maven normal (en IntelliJ: New Project › Java, con Build system: Maven, JDK 25) con este pom.xml:
<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>

    <groupId>es.curso</groupId>
    <artifactId>empresa-jpa</artifactId>
    <version>1.0-SNAPSHOT</version>

    <properties>
        <maven.compiler.release>25</maven.compiler.release>
        <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
        <hibernate.version>7.4.12.Final</hibernate.version>
    </properties>

    <dependencies>
        <!-- Hibernate ORM: implementación de Jakarta Persistence 3.2 -->
        <dependency>
            <groupId>org.hibernate.orm</groupId>
            <artifactId>hibernate-core</artifactId>
            <version>${hibernate.version}</version>
        </dependency>
        <!-- Integración de Hibernate con el pool HikariCP (opcional, recomendado) -->
        <dependency>
            <groupId>org.hibernate.orm</groupId>
            <artifactId>hibernate-hikaricp</artifactId>
            <version>${hibernate.version}</version>
        </dependency>
        <!-- Driver JDBC de MySQL -->
        <dependency>
            <groupId>com.mysql</groupId>
            <artifactId>mysql-connector-j</artifactId>
            <version>9.7.0</version>
            <scope>runtime</scope>
        </dependency>
        <!-- Sistema de log (Hibernate escribe sus mensajes a través de él) -->
        <dependency>
            <groupId>ch.qos.logback</groupId>
            <artifactId>logback-classic</artifactId>
            <version>1.5.38</version>
            <scope>runtime</scope>
        </dependency>
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.apache.maven.plugins</groupId>
                <artifactId>maven-compiler-plugin</artifactId>
                <version>3.16.0</version>
            </plugin>
            <plugin>
                <groupId>org.codehaus.mojo</groupId>
                <artifactId>exec-maven-plugin</artifactId>
                <version>3.6.4</version>
            </plugin>
        </plugins>
    </build>
</project>
| Dependencia | Para qué sirve |
|---|---|
hibernate-core | Hibernate ORM. Trae como dependencia transitiva jakarta.persistence-api 3.2.0, así que no hace falta declararla |
hibernate-hikaricp | Permite que Hibernate use HikariCP (el pool que viste en el módulo 13) en lugar de su pool interno de pruebas |
mysql-connector-j | El driver JDBC: Hibernate genera SQL, pero quien lo envía a MySQL es JDBC. Usamos la 9.7.0, que es la que gestiona Spring Boot 4.1 |
logback-classic | Hibernate escribe sus mensajes con un sistema de log; Logback los muestra y nos deja elegir qué ver |
La estructura del proyecto queda así:
empresa-jpa/
├── pom.xml
└── src/main/
    ├── java/es/curso/empresa/
    │   ├── JpaUtil.java                ← fábrica de EntityManager
    │   ├── Ejemplo01Conexion.java      ← programas de ejemplo
    │   └── modelo/                     ← entidades
    │       ├── Departamento.java
    │       ├── Empleado.java
    │       └── ...
    └── resources/
        ├── META-INF/persistence.xml    ← configuración de JPA
        └── logback.xml                 ← configuración del log
⚠️ Importante: El fichero
persistence.xmltiene que estar exactamente ensrc/main/resources/META-INF/. Si lo pones en otra carpeta, al arrancar obtendrásNo Persistence provider for EntityManager named empresa.
4.3 El fichero persistence.xml
Es el fichero de configuración estándar de JPA. Define una o varias unidades de persistencia (persistence units): cada una agrupa una base de datos, las entidades que se guardan en ella y las opciones del proveedor.
<?xml version="1.0" encoding="UTF-8"?>
<persistence xmlns="https://jakarta.ee/xml/ns/persistence"
             xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
             xsi:schemaLocation="https://jakarta.ee/xml/ns/persistence
                                 https://jakarta.ee/xml/ns/persistence/persistence_3_2.xsd"
             version="3.2">

    <persistence-unit name="empresa" transaction-type="RESOURCE_LOCAL">
        <!-- Proveedor de JPA: Hibernate -->
        <provider>org.hibernate.jpa.HibernatePersistenceProvider</provider>

        <!-- Entidades gestionadas por esta unidad de persistencia -->
        <class>es.curso.empresa.modelo.Departamento</class>
        <class>es.curso.empresa.modelo.Empleado</class>
        <class>es.curso.empresa.modelo.Cliente</class>
        <class>es.curso.empresa.modelo.Producto</class>
        <class>es.curso.empresa.modelo.Pedido</class>
        <class>es.curso.empresa.modelo.LineaPedido</class>
        <class>es.curso.empresa.modelo.Asignacion</class>
        <exclude-unlisted-classes>true</exclude-unlisted-classes>

        <properties>
            <!-- Conexión JDBC (propiedades estándar de Jakarta Persistence) -->
            <property name="jakarta.persistence.jdbc.url"
                      value="jdbc:mysql://localhost:3306/empresa"/>
            <property name="jakarta.persistence.jdbc.user" value="curso"/>
            <property name="jakarta.persistence.jdbc.password" value="curso"/>

            <!-- Comprobar que las entidades encajan con las tablas existentes -->
            <property name="hibernate.hbm2ddl.auto" value="validate"/>

            <!-- Mostrar el SQL que genera Hibernate -->
            <property name="hibernate.show_sql" value="true"/>
            <property name="hibernate.format_sql" value="true"/>
        </properties>
    </persistence-unit>
</persistence>
| Elemento o propiedad | Significado |
|---|---|
name="empresa" | Nombre de la unidad: lo usarás en Persistence.createEntityManagerFactory("empresa") |
transaction-type="RESOURCE_LOCAL" | Las transacciones las controla tu código (begin/commit). La alternativa JTA es para servidores Jakarta EE |
<provider> | Clase del proveedor. Si solo hay una implementación en el classpath se puede omitir |
<class> | Cada entidad gestionada. Con exclude-unlisted-classes a true solo se usan las listadas |
jakarta.persistence.jdbc.url/user/password | Datos de conexión (estándar JPA) |
hibernate.hbm2ddl.auto | Qué hace Hibernate con el esquema al arrancar (sección 5) |
hibernate.show_sql / format_sql | Escribe en la consola, formateado, cada SQL que ejecuta |
💡 Consejo: No hace falta indicar el dialecto (
hibernate.dialect): desde Hibernate 6 se detecta automáticamente a partir de la conexión (en nuestro caso,MySQLDialectpara MySQL 8.4).
4.4 Ver el SQL que genera Hibernate
Con show_sql y format_sql, cada sentencia aparece en la consola precedida de Hibernate:. Es la forma más sencilla y la que usaremos en todo el módulo para ver lo que Hibernate hace por nosotros. El fichero logback.xml deja el resto de mensajes de Hibernate en nivel WARN para que la salida sea legible:
<configuration>
    <appender name="CONSOLA" class="ch.qos.logback.core.ConsoleAppender">
        <encoder>
            <pattern>%-5level %logger{36} - %msg%n</pattern>
        </encoder>
    </appender>

    <!-- Solo avisos y errores de Hibernate; el SQL lo muestra show_sql -->
    <logger name="org.hibernate" level="WARN"/>

    <root level="WARN">
        <appender-ref ref="CONSOLA"/>
    </root>
</configuration>
En proyectos profesionales se prefiere enviar el SQL al sistema de log en lugar de a System.out, porque así se puede activar o desactivar sin tocar el código y redirigir a ficheros. Los dos loggers clave son:
| Logger | Nivel | Qué muestra |
|---|---|---|
org.hibernate.SQL | DEBUG | Cada sentencia SQL (equivale a show_sql) |
org.hibernate.orm.jdbc.bind | TRACE | El valor de cada parámetro ? |
💻 Ejemplo: Este programa usa un
logback-debug.xmlcon esos dos loggers activados y además activa HikariCP. Las propiedades delMapse suman a las depersistence.xml(y tienen prioridad sobre ellas).
public class Ejemplo12LogYPool {

    public static void main(String[] args) {
        // Usamos otra configuración de Logback (debe fijarse antes del primer log)
        System.setProperty("logback.configurationFile", "logback-debug.xml");

        // Propiedades que sustituyen o amplían las de persistence.xml
        Map<String, Object> extra = Map.of(
                "hibernate.show_sql", "false",                 // ahora el SQL lo muestra el logger
                "hibernate.hikari.maximumPoolSize", "5",       // configura el pool HikariCP
                "hibernate.hikari.poolName", "PoolEmpresa");

        try (EntityManagerFactory emf = Persistence.createEntityManagerFactory("empresa", extra)) {
            emf.runInTransaction(em -> {
                Empleado e = em.find(Empleado.class, 121);
                System.out.println(e);
            });
        }
    }
}
Salida real (observa el valor 121 asociado al parámetro):
INFO  com.zaxxer.hikari.HikariDataSource - PoolEmpresa - Starting...
INFO  com.zaxxer.hikari.pool.HikariPool - PoolEmpresa - Added connection com.mysql.cj.jdbc.ConnectionImpl@4afd21c6
INFO  com.zaxxer.hikari.HikariDataSource - PoolEmpresa - Start completed.
DEBUG org.hibernate.SQL -
    select
        e1_0.emp_id,
        e1_0.apellidos,
        e1_0.comision,
        e1_0.dept_id,
        e1_0.email,
        e1_0.fecha_alta,
        e1_0.jefe_id,
        e1_0.nombre,
        e1_0.oficio,
        e1_0.salario,
        e1_0.telefono
    from
        empleados e1_0
    where
        e1_0.emp_id=?
TRACE org.hibernate.orm.jdbc.bind - binding parameter (1:INTEGER) <- [121]
Empleado[id=121, Raquel Molina Prieto, oficio=PROGRAMADOR, salario=2800.00, dept=30]
INFO  com.zaxxer.hikari.HikariDataSource - PoolEmpresa - Shutdown initiated...
INFO  com.zaxxer.hikari.HikariDataSource - PoolEmpresa - Shutdown completed.
4.5 El pool de conexiones
Si no incluyes hibernate-hikaricp, Hibernate usa un pool interno muy básico y te avisa en cuanto arranca:
WARN o.hibernate.orm.connections.pooling - HHH10001002: Using built-in connection pool (not intended for production use)
Con hibernate-hikaricp en el classpath, Hibernate usa HikariCP automáticamente y el aviso desaparece. Las opciones de Hikari se pasan con el prefijo hibernate.hikari. seguido del nombre de la propiedad de HikariCP que ya conoces del módulo 13 (maximumPoolSize, minimumIdle, connectionTimeout…).
📘 Concepto: Hibernate no abre una conexión por consulta: pide conexiones al pool y las devuelve al terminar cada transacción. Es lo mismo que hacías con HikariCP y JDBC, pero ahora lo gestiona Hibernate por ti.
4.6 Configuración programática (sin persistence.xml)
Jakarta Persistence 3.2 añade la clase PersistenceConfiguration, que permite configurar una unidad de persistencia desde código, sin XML. Es útil en pruebas, en herramientas o cuando los datos de conexión vienen de variables de entorno. También añade dos métodos muy cómodos a EntityManagerFactory: runInTransaction y callInTransaction.
package es.curso.empresa;

import es.curso.empresa.modelo.Departamento;
import jakarta.persistence.EntityManagerFactory;
import jakarta.persistence.PersistenceConfiguration;
import org.hibernate.jpa.HibernatePersistenceProvider;
import java.math.BigDecimal;

public class Ejemplo11Programatica {

    public static void main(String[] args) {
        // Configuración sin persistence.xml (Jakarta Persistence 3.2)
        PersistenceConfiguration config = new PersistenceConfiguration("empresa-programatica")
                .provider(HibernatePersistenceProvider.class.getName())
                .managedClass(Departamento.class)
                .property(PersistenceConfiguration.JDBC_URL, "jdbc:mysql://localhost:3306/empresa")
                .property(PersistenceConfiguration.JDBC_USER, "curso")
                .property(PersistenceConfiguration.JDBC_PASSWORD, "curso")
                .property("hibernate.hbm2ddl.auto", "validate")
                .property("hibernate.show_sql", "true");

        try (EntityManagerFactory emf = config.createEntityManagerFactory()) {

            // callInTransaction: abre EM y transacción, ejecuta, hace commit (o rollback) y cierra
            long total = emf.callInTransaction(em ->
                    em.createQuery("select count(d) from Departamento d", Long.class)
                      .getSingleResult());
            System.out.println("Departamentos: " + total);

            // runInTransaction: igual, pero sin devolver nada
            emf.runInTransaction(em -> {
                Departamento d = em.find(Departamento.class, 70);
                d.setPresupuesto(new BigDecimal("75000"));
            });
            emf.runInTransaction(em ->
                    em.find(Departamento.class, 70).setPresupuesto(null));   // lo dejamos como estaba
        }
    }
}
Salida real (sin format_sql, cada sentencia ocupa una línea):
Hibernate: select count(d1_0.dept_id) from departamentos d1_0
Departamentos: 7
Hibernate: select d1_0.dept_id,d1_0.localidad,d1_0.nombre,d1_0.presupuesto from departamentos d1_0 where d1_0.dept_id=?
Hibernate: update departamentos set localidad=?,nombre=?,presupuesto=? where dept_id=?
Hibernate: select d1_0.dept_id,d1_0.localidad,d1_0.nombre,d1_0.presupuesto from departamentos d1_0 where d1_0.dept_id=?
Hibernate: update departamentos set localidad=?,nombre=?,presupuesto=? where dept_id=?
💡 Consejo: Hibernate ofrece además su propia variante,
HibernatePersistenceConfiguration, con métodos con nombre (jdbcUrl(...),showSql(...)…). Y en Spring Boot (módulos 18 y 19) no escribirás nipersistence.xmlni esta clase: la configuración sale deapplication.properties.
5. Generación del esquema: hibernate.hbm2ddl.auto
Hibernate conoce, gracias a las anotaciones, cómo deberían ser las tablas. La propiedad hibernate.hbm2ddl.auto le dice qué hacer con esa información al arrancar:
| Valor | Qué hace al arrancar | Al cerrar | Uso típico |
|---|---|---|---|
none | Nada (valor por defecto) | Nada | Producción, cuando el esquema lo gestiona otra herramienta |
validate | Comprueba que tablas y columnas existen y tienen tipos compatibles; si no, no arranca | Nada | Base de datos existente, como EMPRESA. Recomendado en producción |
update | Crea las tablas y columnas que falten; nunca borra ni modifica las existentes | Nada | Prototipos rápidos. Peligroso en producción |
create | Borra las tablas de las entidades y las vuelve a crear (se pierden los datos) | Nada | Pruebas con datos que se cargan en cada arranque |
create-drop | Como create | Borra las tablas | Pruebas automáticas y ejemplos de laboratorio |
create-only | Crea sin borrar antes | Nada | Generar un esquema nuevo |
drop | Borra las tablas de las entidades | Nada | Limpieza |
truncate | Vacía las tablas (borra los datos, no la estructura) | Nada | Pruebas |
La especificación JPA tiene su propia propiedad estándar, jakarta.persistence.schema-generation.database.action, con los valores none, create, drop-and-create y drop. Hibernate entiende ambas; hbm2ddl.auto es la más usada porque incluye validate y update.
⚠️ Importante: Con una base de datos que ya existe y tiene datos (EMPRESA, o la base de datos de cualquier empresa real), usa
validate. Concreateocreate-dropHibernate borraría las tablas y perderías todos los datos; conupdatepodría crear columnas o tablas con tipos que no son los que quiere tu administrador de bases de datos, y además nunca elimina nada, así que el esquema se va “ensuciando”.validatete avisa al arrancar si tu mapeo no encaja con la realidad, que es justo lo que quieres.
5.1 validate en acción
Para verlo, mapeamos a propósito una columna que no existe (fecha_ingreso en lugar de fecha_alta) en una unidad de persistencia de pruebas llamada validacion:
@Entity
@Table(name = "empleados")
public class EmpleadoMalMapeado {

    @Id
    @Column(name = "emp_id")
    private Integer id;

    @Column(name = "fecha_ingreso")        // ¡en la tabla se llama fecha_alta!
    private LocalDate fechaIngreso;
}
public class Ejemplo09Validate {

    public static void main(String[] args) {
        try (var emf = Persistence.createEntityManagerFactory("validacion")) {
            System.out.println("El esquema es correcto");
        } catch (RuntimeException e) {
            // Buscamos la causa raíz para mostrar el mensaje útil
            Throwable causa = e;
            while (causa.getCause() != null) causa = causa.getCause();
            System.out.println(causa.getClass().getName());
            System.out.println(causa.getMessage());
        }
    }
}
Salida real:
org.hibernate.tool.schema.spi.SchemaManagementException
Schema validation: missing column [fecha_ingreso] in table [empleados]
La aplicación no llega a arrancar: es mucho mejor descubrir el error así que con un SQLSyntaxErrorException en mitad de una operación de un usuario.
💡 Consejo: Jakarta Persistence 3.2 también permite lanzar estas operaciones desde código:
emf.getSchemaManager().validate(),.create(...),.drop(...)o.truncate().
5.2 create-drop en una tabla de laboratorio
Para ver qué tablas generaría Hibernate a partir de una entidad, usamos otra unidad de persistencia, laboratorio, con create-drop y una entidad que no pertenece a EMPRESA (la tabla incidencias se crea y se borra sola):
/** Entidad de laboratorio: su tabla la crea Hibernate (no forma parte de EMPRESA). */
@Entity
@Table(name = "incidencias")
public class Incidencia {

    public enum Prioridad { BAJA, MEDIA, ALTA }

    @Id
    @GeneratedValue(strategy = GenerationType.UUID)   // identificador UUID (JPA 3.1)
    private UUID id;

    @Column(nullable = false, length = 100)
    private String titulo;

    @Lob                                               // texto largo
    private String descripcion;

    @Enumerated(EnumType.STRING)
    @Column(length = 10)
    private Prioridad prioridad;

    @Enumerated                                        // ORDINAL: 0, 1, 2 (desaconsejado)
    private Prioridad prioridadOrdinal;

    private LocalDateTime creada;

    private boolean resuelta;

    @Lob
    private byte[] captura;                            // binario largo

    protected Incidencia() { }

    public Incidencia(String titulo, String descripcion, Prioridad prioridad) {
        this.titulo = titulo;
        this.descripcion = descripcion;
        this.prioridad = prioridad;
        this.prioridadOrdinal = prioridad;
        this.creada = LocalDateTime.of(2026, 10, 4, 9, 30);
    }

    public UUID getId() { return id; }
}
public class Ejemplo10Laboratorio {

    public static void main(String[] args) {
        // Unidad "laboratorio": hbm2ddl.auto = create-drop
        try (var emf = Persistence.createEntityManagerFactory("laboratorio")) {
            emf.runInTransaction(em -> {
                Incidencia i = new Incidencia("Impresora atascada",
                        "La impresora láser de Contabilidad no imprime", Prioridad.ALTA);
                em.persist(i);
                System.out.println("Id generado: " + i.getId());
            });
            System.out.println("--- cerrando la fábrica (create-drop borra la tabla) ---");
        }
    }
}
Salida real: el DDL generado es muy instructivo, porque muestra cómo traduce Hibernate cada tipo Java a MySQL:
Hibernate:
    drop table if exists incidencias
Hibernate:
    create table incidencias (
        prioridadOrdinal tinyint check ((prioridadOrdinal between 0 and 2)),
        resuelta bit not null,
        creada datetime(6),
        id binary(16) not null,
        titulo varchar(100) not null,
        captura longblob,
        descripcion longtext,
        prioridad enum ('ALTA','BAJA','MEDIA'),
        primary key (id)
    ) engine=InnoDB
Id generado: 04c80c34-36df-4aae-a9af-9d39b1735db0
Hibernate:
    insert
    into
        incidencias
        (captura, creada, descripcion, prioridad, prioridadOrdinal, resuelta, titulo, id)
    values
        (?, ?, ?, ?, ?, ?, ?, ?)
--- cerrando la fábrica (create-drop borra la tabla) ---
Hibernate: drop table if exists incidencias
Fíjate en varios detalles:
- El nombre de columna por defecto es el del atributo (
prioridadOrdinal,creada). booleanse convierte enbit,LocalDateTimeendatetime(6)(microsegundos) yUUIDenbinary(16).@LobsobreStringgeneralongtext, y sobrebyte[],longblob.- En MySQL,
@Enumerated(EnumType.STRING)genera una columna de tipoenum(...)nativo; conORDINAL, untinyintcon uncheck. - El
UUIDlo genera Hibernate en Java antes delINSERT(por eso el id aparece antes de la sentencia).
⚠️ Importante: El DDL que genera Hibernate es correcto, pero no siempre es el que escribiría un buen administrador de bases de datos (por ejemplo, los nombres de las restricciones son aleatorios). En proyectos reales el esquema se versiona con scripts SQL o con herramientas de migración como Flyway o Liquibase, y Hibernate se limita a
validate.
6. Entidades
📘 Concepto: Una entidad es una clase Java cuyos objetos se guardan en la base de datos. Cada objeto corresponde a una fila y cada atributo persistente a una columna. Se marca con
@Entityy debe tener un identificador (@Id) que corresponde a la clave primaria.
6.1 Requisitos de una entidad
| Requisito | Motivo |
|---|---|
Anotación @Entity | Para que JPA la reconozca |
Un atributo @Id (o una clave compuesta) | La identidad de la fila |
Constructor sin argumentos public o protected | Hibernate crea los objetos por reflexión al leerlos de la base de datos |
La clase no puede ser final, ni sus métodos persistentes | Hibernate crea subclases (proxies) para la carga perezosa (módulo 15) |
Atributos persistentes no final | Hibernate los rellena después de construir el objeto |
Clase de nivel superior (o anidada static) | No puede ser una clase interna ni un record |
⚠️ Importante: Un record no puede ser una entidad (sus atributos son
finaly no tiene constructor vacío), pero sí puede ser un embebible (@Embeddable, admitido por Jakarta Persistence 3.2), Hibernate lo acepta como clase de clave compuesta (sección 14) y es perfecto para los resultados de consultas (DTO, módulo 16).
6.2 Primera entidad: Departamento
package es.curso.empresa.modelo;

import jakarta.persistence.*;
import java.math.BigDecimal;

@Entity                                   // 1. Esta clase es una entidad
@Table(name = "departamentos")            // 2. Se guarda en la tabla departamentos
public class Departamento {

    @Id                                                    // 3. Clave primaria
    @GeneratedValue(strategy = GenerationType.IDENTITY)    // 4. AUTO_INCREMENT de MySQL
    @Column(name = "dept_id")
    private Integer id;

    @Column(nullable = false, length = 40, unique = true)
    private String nombre;

    @Column(length = 40)
    private String localidad;

    @Column(precision = 12, scale = 2)
    private BigDecimal presupuesto;

    protected Departamento() { }           // 5. Constructor sin argumentos (obligatorio)

    public Departamento(String nombre, String localidad, BigDecimal presupuesto) {
        this.nombre = nombre;
        this.localidad = localidad;
        this.presupuesto = presupuesto;
    }

    public Integer getId() { return id; }
    public String getNombre() { return nombre; }
    public void setNombre(String nombre) { this.nombre = nombre; }
    public String getLocalidad() { return localidad; }
    public void setLocalidad(String localidad) { this.localidad = localidad; }
    public BigDecimal getPresupuesto() { return presupuesto; }
    public void setPresupuesto(BigDecimal presupuesto) { this.presupuesto = presupuesto; }

    @Override
    public String toString() {
        return "Departamento[id=" + id + ", nombre=" + nombre + ", localidad=" + localidad
                + ", presupuesto=" + presupuesto + "]";
    }
}
Compara con la tabla de EMPRESA:
CREATE TABLE departamentos (
    dept_id      INT AUTO_INCREMENT PRIMARY KEY,
    nombre       VARCHAR(40)  NOT NULL,
    localidad    VARCHAR(40),
    presupuesto  DECIMAL(12,2),
    CONSTRAINT uq_dep_nombre      UNIQUE (nombre),
    CONSTRAINT ck_dep_presupuesto CHECK (presupuesto >= 0)
);
💡 Consejo: Usa tipos envoltorio (
Integer,Long) para el identificador, no primitivos. UnInteger idanullsignifica claramente “todavía no se ha guardado”; unint idvaldría0, que podría confundirse con un id real. Para el dinero, usa siempreBigDecimal(nuncadouble).
6.3 @Table y @Column
Sin @Table, la tabla se llamaría como la entidad (Departamento); sin @Column(name=...), la columna se llamaría como el atributo. Como las tablas de EMPRESA ya existen con sus nombres en minúsculas y con guiones bajos (fecha_alta), tenemos que indicarlos.
Atributo de @Column | Significado | Ejemplo |
|---|---|---|
name | Nombre de la columna | @Column(name = "fecha_alta") |
nullable | Si admite NULL (por defecto true) | nullable = false |
length | Longitud de un VARCHAR (por defecto 255) | length = 40 |
precision, scale | Dígitos totales y decimales de un DECIMAL | precision = 8, scale = 2 |
unique | Restricción de unicidad | unique = true |
insertable, updatable | Si la columna aparece en INSERT/UPDATE | updatable = false |
columnDefinition | Fragmento de DDL literal (no portable) | columnDefinition = "char(1)" |
📘 Concepto:
nullable,length,precision,uniqueycolumnDefinitionsolo se usan para generar el esquema (DDL) y, parcialmente, para validarlo. No validan los datos en Java: si quieres comprobar que un nombre no esté vacío antes de guardarlo, eso es Jakarta Validation (@NotBlank,@Size), que verás en el módulo 20. Aun así, conviene escribirlos para que la entidad documente la tabla.
6.4 Identificadores: @Id y @GeneratedValue
| Estrategia | Cómo obtiene el id | Cuándo usarla |
|---|---|---|
IDENTITY | La base de datos lo genera al insertar (AUTO_INCREMENT en MySQL, IDENTITY en SQL Server/PostgreSQL) | MySQL: es la que corresponde a EMPRESA |
SEQUENCE | Pide el siguiente valor a una secuencia (CREATE SEQUENCE) antes de insertar | PostgreSQL, Oracle. Permite agrupar inserciones en lotes |
TABLE | Simula una secuencia con una tabla auxiliar | Casi nunca: es lenta |
AUTO (por defecto) | Hibernate elige; en MySQL usa una tabla que emula una secuencia | Evítala: indica la estrategia explícitamente |
UUID | Hibernate genera un UUID aleatorio en Java | Identificadores globales, sistemas distribuidos |
⚠️ Importante: Con
IDENTITY, Hibernate necesita ejecutar elINSERTen el mismo momento delpersist()para conocer el id (lo verás en la salida del CRUD). Por eso conIDENTITYno es posible agrupar losINSERTen lotes JDBC. En MySQL no hay alternativa nativa mejor, y es perfectamente válida para la inmensa mayoría de aplicaciones.
6.5 Tipos básicos
Hibernate sabe convertir automáticamente los tipos más habituales:
| Tipo Java | Tipo MySQL habitual | Notas |
|---|---|---|
String | VARCHAR(n) | length por defecto 255 |
Integer / int, Long / long | INT, BIGINT | Usa envoltorios si la columna admite NULL |
BigDecimal | DECIMAL(p,s) | Para importes: precisión exacta |
Double / double | DOUBLE | Solo para medidas, nunca para dinero |
Boolean / boolean | BIT | Para CHAR(1) con ‘S’/’N’ hace falta un conversor (6.8) |
LocalDate | DATE | Fechas sin hora |
LocalDateTime | DATETIME(6) | Fecha y hora local |
Instant, OffsetDateTime | DATETIME(6) / TIMESTAMP(6) | Instantes absolutos (UTC) |
LocalTime | TIME | |
UUID | BINARY(16) | También puede mapearse a CHAR(36) |
byte[], String con @Lob | LONGBLOB, LONGTEXT | Contenido grande |
enum | VARCHAR/ENUM o TINYINT | Con @Enumerated (6.6) |
⚠️ Importante: Olvida
java.util.Date,java.sql.Date,Calendary la anotación@Temporal: son la forma antigua de mapear fechas. Desde JPA 2.2 los tipos dejava.time(módulo 05) se mapean directamente y@Temporalestá obsoleta.
6.6 Enumerados: @Enumerated
La tabla pedidos guarda el estado en un VARCHAR(12) restringido a cuatro valores. En Java lo natural es un enum:
public enum EstadoPedido {
    PENDIENTE, ENVIADO, ENTREGADO, CANCELADO
}
@Entity
@Table(name = "pedidos")
public class Pedido {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    @Column(name = "pedido_id")
    private Integer id;

    @Column(name = "cliente_id", nullable = false)
    private Integer clienteId;          // en el módulo 15 será una relación con Cliente

    // ... empleadoId, fechaPedido (LocalDate), fechaEnvio (LocalDate)

    @Enumerated(EnumType.STRING)          // Guarda el NOMBRE de la constante ('ENVIADO')
    @Column(nullable = false, length = 12)
    private EstadoPedido estado;

    // constructores, getters, setters y toString
}
EnumType | Qué guarda | Problema |
|---|---|---|
ORDINAL (por defecto) | La posición: PENDIENTE=0, ENVIADO=1… | Si reordenas o insertas una constante, todos los datos antiguos cambian de significado |
STRING | El nombre: 'PENDIENTE', 'ENVIADO'… | Ocupa algo más, pero es legible y robusto |
⚠️ Importante: Usa siempre
@Enumerated(EnumType.STRING). El valor por defecto (ORDINAL) es una trampa clásica: alguien añadeEN_PREPARACIONentrePENDIENTEyENVIADOy, de repente, todos los pedidos enviados aparecen “en preparación”.
6.7 Atributos no persistentes: @Transient
Todo atributo de una entidad se guarda por defecto. Si quieres un atributo que solo exista en memoria (un indicador para la interfaz, un dato calculado que guardas en caché…), márcalo con @Transient:
@Transient                                   // No se guarda en la base de datos
private boolean seleccionado;

/** Dato calculado: tampoco se guarda (no hay atributo, solo un método). */
public String getNombreCompleto() { return nombre + " " + apellidos; }
⚠️ Importante: No confundas la anotación
@Transientde JPA (jakarta.persistence.Transient) con la palabra reservadatransientde Java, que afecta a la serialización (módulo 08). Hibernate también ignora los atributostransient, pero la forma clara de expresarlo en una entidad es la anotación.
6.8 Conversores: @Convert
La tabla productos tiene una columna descatalogado CHAR(1) con los valores 'S' y 'N'. En Java queremos un boolean. Para cualquier conversión a medida, JPA ofrece los conversores de atributos:
/** Convierte boolean (Java) <-> 'S' / 'N' (columna CHAR(1) de la base de datos). */
@Converter
public class SiNoConverter implements AttributeConverter<Boolean, String> {

    @Override
    public String convertToDatabaseColumn(Boolean valor) {
        return Boolean.TRUE.equals(valor) ? "S" : "N";
    }

    @Override
    public Boolean convertToEntityAttribute(String columna) {
        return "S".equals(columna);
    }
}
@Entity
@Table(name = "productos")
public class Producto {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    @Column(name = "producto_id")
    private Integer id;

    // ... nombre, descripcion, categoriaId, precio (BigDecimal), stock (int), fechaAlta (LocalDate)

    @Convert(converter = SiNoConverter.class)
    @Column(nullable = false, length = 1)
    private boolean descatalogado;

    protected Producto() { }
    // getters, setters y toString
}
💡 Consejo: Si marcas el conversor con
@Converter(autoApply = true), se aplica automáticamente a todos los atributos de ese tipo Java (aquí, a todos losBoolean), sin necesidad de@Convert. Úsalo solo si de verdad todas las columnas siguen el mismo convenio.
6.9 Contenido grande: @Lob
@Lob indica que el atributo es un objeto grande: String o char[] se mapean a un CLOB (LONGTEXT en MySQL) y byte[] a un BLOB (LONGBLOB). EMPRESA no tiene columnas de este tipo, por eso lo viste en la entidad de laboratorio Incidencia de la sección 5.2.
💡 Consejo: Guardar ficheros grandes (fotos, PDF) en la base de datos es posible, pero suele ser mejor guardarlos en disco o en un almacenamiento de objetos y guardar en la tabla solo la ruta. Si los guardas en la base de datos, ponlos en una entidad aparte con carga perezosa para no leerlos cada vez que consultas la entidad principal.
6.10 La entidad Empleado completa
La tabla empleados tiene dos claves ajenas: jefe_id (autorrelación) y dept_id. En este módulo las mapeamos como simples números; en el módulo 15 las convertiremos en relaciones entre objetos (Empleado jefe, Departamento departamento).
package es.curso.empresa.modelo;

import jakarta.persistence.*;
import java.math.BigDecimal;
import java.time.LocalDate;

@Entity
@Table(name = "empleados")
public class Empleado {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    @Column(name = "emp_id")
    private Integer id;

    @Column(nullable = false, length = 30)
    private String nombre;

    @Column(nullable = false, length = 50)
    private String apellidos;

    @Column(nullable = false, length = 60, unique = true)
    private String email;

    @Column(length = 15)
    private String telefono;

    @Column(name = "fecha_alta", nullable = false)
    private LocalDate fechaAlta;                 // DATE  <->  LocalDate

    @Column(nullable = false, length = 30)
    private String oficio;

    @Column(nullable = false, precision = 8, scale = 2)
    private BigDecimal salario;                  // DECIMAL(8,2)  <->  BigDecimal

    @Column(precision = 8, scale = 2)
    private BigDecimal comision;

    // De momento guardamos las claves ajenas como números.
    // En el módulo 15 se convertirán en relaciones @ManyToOne.
    @Column(name = "jefe_id")
    private Integer jefeId;

    @Column(name = "dept_id")
    private Integer deptId;

    @Transient                                   // No se guarda en la base de datos
    private boolean seleccionado;

    protected Empleado() { }

    public Empleado(String nombre, String apellidos, String email, String oficio,
                    BigDecimal salario, Integer deptId) {
        this.nombre = nombre;
        this.apellidos = apellidos;
        this.email = email;
        this.oficio = oficio;
        this.salario = salario;
        this.deptId = deptId;
        this.fechaAlta = LocalDate.now();
    }

    /** Dato calculado: tampoco se guarda (no hay atributo, solo un método). */
    public String getNombreCompleto() { return nombre + " " + apellidos; }

    // getters y setters de todos los atributos...

    @Override
    public String toString() {
        return "Empleado[id=" + id + ", " + getNombreCompleto() + ", oficio=" + oficio
                + ", salario=" + salario + ", dept=" + deptId + "]";
    }
}
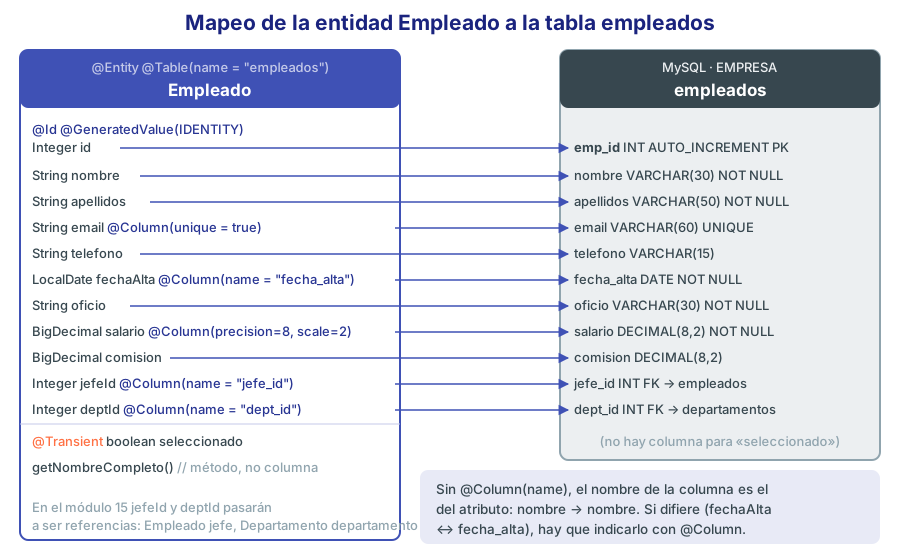
Figura 3. Mapeo de la entidad Empleado a la tabla empleados.
📘 Concepto: JPA lee las anotaciones de los atributos (acceso por campo) porque hemos puesto
@Idsobre un atributo. Si pusieras@Idsobre el getter, usaría acceso por propiedad (llamaría a los getters y setters). El acceso por campo es el más habitual: te deja libertad para escribir getters con lógica o no escribir setters de los datos que no deban cambiar.
6.11 Las entidades en IntelliJ IDEA
IntelliJ IDEA Ultimate (y la edición Community con el plugin JPA Buddy) reconoce las entidades y las muestra en la ventana Persistence. Desde ahí puedes generar el diagrama entidad-relación, abrir una consola para probar consultas JPQL contra la base de datos y comprobar en el editor si los nombres de tablas y columnas existen.
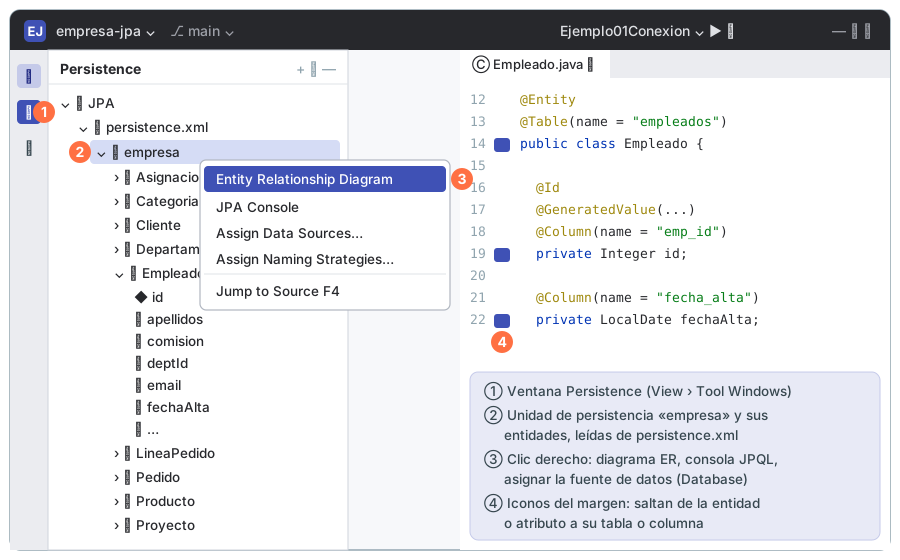
Figura 4. Esquema de la ventana Persistence de IntelliJ IDEA (interfaz nueva).
| Marca | Qué es |
|---|---|
| ① | La ventana Persistence (View › Tool Windows › Persistence) |
| ② | La unidad de persistencia empresa leída de persistence.xml, con todas sus entidades y atributos |
| ③ | Menú contextual: Entity Relationship Diagram, JPA Console y Assign Data Sources… (asocia la unidad con la conexión de la ventana Database para que el IDE valide nombres de columnas) |
| ④ | Iconos del margen del editor: navegan entre la entidad, sus atributos y la tabla |
💡 Consejo: Asigna la fuente de datos (③): a partir de ese momento IntelliJ subraya en rojo una
@Column(name = "fecha_ingreso")que no exista en la tabla, sin necesidad de ejecutar nada. Es como tenervalidatemientras escribes.
7. EntityManagerFactory y EntityManager
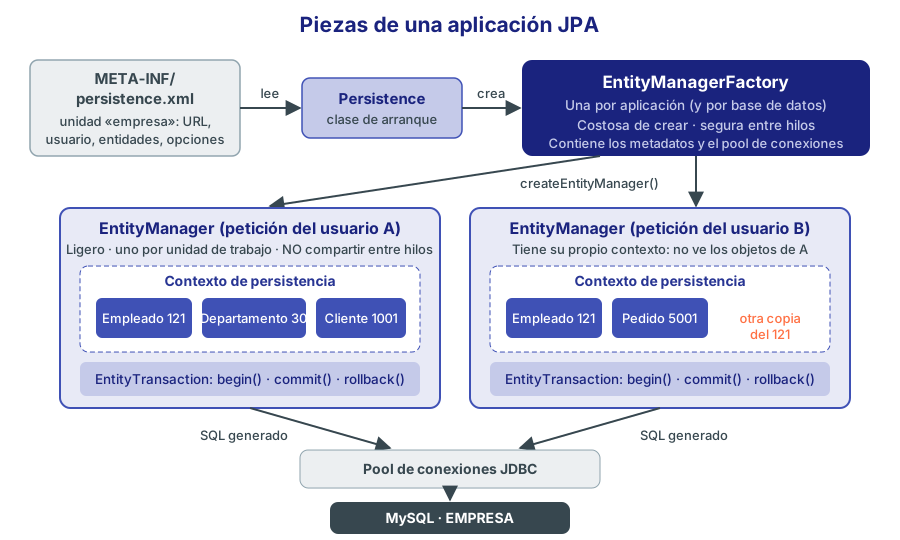
Figura 5. Piezas de una aplicación JPA.
| Objeto | Cuántos | Coste | ¿Compartible entre hilos? | Analogía |
|---|---|---|---|---|
EntityManagerFactory | Uno por aplicación y base de datos | Alto: lee la configuración, analiza las entidades, valida el esquema y crea el pool | Sí | La fábrica de coches |
EntityManager | Uno por unidad de trabajo (una petición, una operación de negocio) | Bajo | No | Un coche: lo usa un conductor cada vez |
EntityTransaction | Una activa por EntityManager | Bajo | No | Un trayecto |
Como la fábrica es cara, la creamos una sola vez en una clase de utilidad:
package es.curso.empresa;

import jakarta.persistence.EntityManager;
import jakarta.persistence.EntityManagerFactory;
import jakarta.persistence.Persistence;

/** Una única EntityManagerFactory para toda la aplicación. */
public final class JpaUtil {

    private static final EntityManagerFactory EMF =
            Persistence.createEntityManagerFactory("empresa");

    private JpaUtil() { }

    public static EntityManagerFactory getEmf() { return EMF; }

    public static EntityManager crearEntityManager() { return EMF.createEntityManager(); }

    public static void cerrar() { EMF.close(); }
}
💻 Ejemplo: Primer programa: abre la fábrica, crea un
EntityManagery busca por clave primaria. Ambos objetos implementanAutoCloseable, así que se pueden usar en untry-with-resources.
package es.curso.empresa;

import es.curso.empresa.modelo.Departamento;
import es.curso.empresa.modelo.Empleado;
import jakarta.persistence.EntityManager;
import jakarta.persistence.EntityManagerFactory;
import jakarta.persistence.Persistence;

public class Ejemplo01Conexion {

    public static void main(String[] args) {
        // 1. Crear la fábrica (una vez por aplicación): lee META-INF/persistence.xml
        try (EntityManagerFactory emf = Persistence.createEntityManagerFactory("empresa");
             // 2. Crear un EntityManager (uno por unidad de trabajo)
             EntityManager em = emf.createEntityManager()) {

            // 3. Buscar por clave primaria
            Departamento ventas = em.find(Departamento.class, 20);
            System.out.println(ventas);

            Empleado ana = em.find(Empleado.class, 100);
            System.out.println(ana);
            System.out.println("Nombre completo: " + ana.getNombreCompleto());
        }
    }
}
Para ejecutarlo desde la terminal: mvn -q compile exec:java -Dexec.mainClass=es.curso.empresa.Ejemplo01Conexion (o con el botón ▶ de IntelliJ). Salida real, todavía sin hibernate-hikaricp:
WARN  o.hibernate.orm.connections.pooling - HHH10001002: Using built-in connection pool (not intended for production use)
Hibernate:
    select
        d1_0.dept_id,
        d1_0.localidad,
        d1_0.nombre,
        d1_0.presupuesto
    from
        departamentos d1_0
    where
        d1_0.dept_id=?
Departamento[id=20, nombre=VENTAS, localidad=Madrid, presupuesto=350000.00]
Hibernate:
    select
        e1_0.emp_id,
        e1_0.apellidos,
        e1_0.comision,
        e1_0.dept_id,
        e1_0.email,
        e1_0.fecha_alta,
        e1_0.jefe_id,
        e1_0.nombre,
        e1_0.oficio,
        e1_0.salario,
        e1_0.telefono
    from
        empleados e1_0
    where
        e1_0.emp_id=?
Empleado[id=100, Ana García López, oficio=DIRECTOR GENERAL, salario=6500.00, dept=10]
Nombre completo: Ana García López
💡 Consejo: A partir de aquí, los ejemplos omiten las líneas
packageeimportpara ahorrar espacio: son las dejakarta.persistence.*,java.math.BigDecimal,java.time.*y las entidades del paquetees.curso.empresa.modelo. IntelliJ las añade solo con Alt+Intro.
Observa que no hemos escrito ni una línea de SQL: Hibernate ha generado el SELECT con todas las columnas mapeadas, usando alias (d1_0, e1_0) y un parámetro ? (un PreparedStatement, como hacías en JDBC, así que no hay riesgo de inyección SQL). Además, como hbm2ddl.auto vale validate, antes de ejecutar nada Hibernate ha comprobado que todas las entidades de la unidad encajan con las tablas de EMPRESA.
8. Transacciones
Cualquier operación que modifique datos debe hacerse dentro de una transacción. Con RESOURCE_LOCAL las controlas tú con EntityTransaction, siguiendo el mismo patrón que en JDBC (módulo 13):
try (EntityManager em = JpaUtil.crearEntityManager()) {
    EntityTransaction tx = em.getTransaction();
    try {
        tx.begin();
        // ... operaciones ...
        tx.commit();
    } catch (RuntimeException e) {
        if (tx.isActive()) tx.rollback();     // deshacer si algo falla
        throw e;
    }
}
O, de forma mucho más compacta, con los métodos de Jakarta Persistence 3.2, que hacen exactamente eso por ti (crean el EntityManager, empiezan la transacción, hacen commit o rollback y lo cierran):
EntityManagerFactory emf = JpaUtil.getEmf();

emf.runInTransaction(em -> em.persist(nuevoDepartamento));             // sin resultado

long total = emf.callInTransaction(em ->                                 // con resultado
        em.createQuery("select count(e) from Empleado e", Long.class).getSingleResult());
📘 Concepto: Las lecturas (
find, consultas) pueden hacerse sin transacción explícita, pero las escrituras no: unpersistfuera de transacción no se envía a la base de datos y, en algunos casos, lanzaTransactionRequiredException. En Spring (módulos 17 y 19) no escribirásbeginnicommit: anotarás el método con@Transactional.
9. Operaciones CRUD
| Operación | Método | SQL que genera |
|---|---|---|
| Crear | em.persist(objeto) | INSERT (al hacer flush; con IDENTITY, inmediatamente) |
| Leer | em.find(Clase.class, id) | SELECT ... WHERE id = ? (o nada si ya está en caché) |
| Leer (referencia) | em.getReference(Clase.class, id) | Nada hasta que accedes a un atributo (devuelve un proxy) |
| Actualizar | Modificar un objeto gestionado | UPDATE automático al hacer flush |
| Actualizar (desconectado) | em.merge(objeto) | SELECT + UPDATE |
| Borrar | em.remove(objetoGestionado) | DELETE al hacer flush |
💻 Ejemplo: CRUD completo de un departamento nuevo (que al final se borra, así EMPRESA queda igual):
public class Ejemplo02Crud {

    public static void main(String[] args) {
        Integer id;

        // ---------- CREATE: persist ----------
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            EntityTransaction tx = em.getTransaction();
            try {
                tx.begin();
                Departamento formacion =
                        new Departamento("FORMACIÓN", "Granada", new BigDecimal("90000"));
                System.out.println("Antes de persist, id = " + formacion.getId());
                em.persist(formacion);
                System.out.println("Después de persist, id = " + formacion.getId());
                tx.commit();
                id = formacion.getId();
            } catch (RuntimeException e) {
                if (tx.isActive()) tx.rollback();
                throw e;
            }
        }

        // ---------- READ: find ----------
        Departamento copia;
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            copia = em.find(Departamento.class, id);
            System.out.println("Leído: " + copia);
        }   // al cerrar el EntityManager, 'copia' queda DESCONECTADA (detached)

        // ---------- UPDATE: merge de un objeto desconectado ----------
        copia.setLocalidad("Málaga");
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.getTransaction().begin();
            Departamento gestionado = em.merge(copia);
            System.out.println("¿merge devuelve el mismo objeto? " + (gestionado == copia));
            em.getTransaction().commit();
        }

        // ---------- DELETE: remove ----------
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.getTransaction().begin();
            Departamento d = em.find(Departamento.class, id);
            em.remove(d);
            em.getTransaction().commit();
            System.out.println("Borrado. ¿Existe todavía? " + (em.find(Departamento.class, id) != null));
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Antes de persist, id = null
Hibernate:
    insert
    into
        departamentos
        (localidad, nombre, presupuesto)
    values
        (?, ?, ?)
Después de persist, id = 71
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
Leído: Departamento[id=71, nombre=FORMACIÓN, localidad=Granada, presupuesto=90000.00]
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
¿merge devuelve el mismo objeto? false
Hibernate:
    update
        departamentos
    set
        localidad=?,
        nombre=?,
        presupuesto=?
    where
        dept_id=?
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
Hibernate:
    delete
    from
        departamentos
    where
        dept_id=?
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
Borrado. ¿Existe todavía? false
Analicemos la salida:
persist: elINSERTse ejecuta en el mismopersist()(estrategiaIDENTITY), y en ese momento el objeto recibe su id (71, el siguienteAUTO_INCREMENT).finden unEntityManagernuevo:SELECTpor clave primaria.merge: como elEntityManagerno conoce el objeto, primero lo lee (SELECT), copia sobre él los valores del objeto desconectado y, en elcommit, lanza elUPDATE.mergedevuelve otro objeto (el gestionado): el que le pasaste sigue desconectado.remove: solo funciona sobre un objeto gestionado, por eso primero hacemosfind. ElDELETEsale en elcommit.
⚠️ Importante: Error frecuente:
em.merge(copia); copia.setNombre("X");y esperar que se guardeX. El objeto gestionado es el devuelto pormerge; sigue trabajando con él:copia = em.merge(copia);.
9.1 find frente a getReference
find | getReference | |
|---|---|---|
| SQL | Inmediato (si no está en caché) | Ninguno hasta que accedes a un atributo que no sea el id |
| Si no existe | Devuelve null | Lanza EntityNotFoundException al usarlo |
| Uso típico | Necesitas los datos | Solo necesitas la referencia para asignarla en una relación (módulo 15) |
10. Ciclo de vida de una entidad
Un objeto de una entidad pasa por cuatro estados según su relación con el contexto de persistencia:
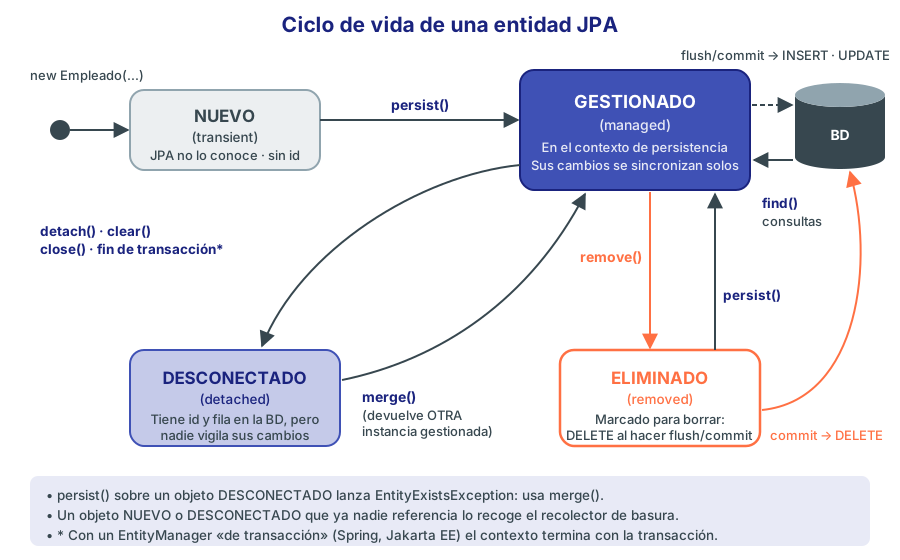
Figura 6. Estados y transiciones de una entidad JPA.
| Estado | ¿Tiene fila en la BD? | ¿Lo vigila el EntityManager? | Cómo se llega |
|---|---|---|---|
| Nuevo (transient) | No | No | new |
| Gestionado (managed) | Sí (o la tendrá al hacer flush) | Sí: sus cambios se guardan solos | persist, find, consultas, merge (el devuelto) |
| Desconectado (detached) | Sí | No | detach, clear, close, o al serializarlo |
| Eliminado (removed) | Sí, hasta el flush | Sí, marcado para borrar | remove |
💻 Ejemplo: Recorremos los estados usando
em.contains(objeto), que indica si el objeto está gestionado:
public class Ejemplo03CicloVida {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.getTransaction().begin();

            // 1. TRANSIENT (nuevo): un objeto Java normal, JPA no lo conoce
            Departamento d = new Departamento("CALIDAD", "Toledo", new BigDecimal("50000"));
            System.out.println("1. Nuevo      -> contains = " + em.contains(d) + ", id = " + d.getId());

            // 2. MANAGED (gestionado): persist lo mete en el contexto de persistencia
            em.persist(d);
            System.out.println("2. persist    -> contains = " + em.contains(d) + ", id = " + d.getId());

            // 3. DETACHED (desconectado): sigue existiendo en la BD, pero JPA ya no lo vigila
            em.detach(d);
            System.out.println("3. detach     -> contains = " + em.contains(d));
            d.setLocalidad("Cuenca");          // este cambio NO se guardará por sí solo

            // 4. merge: copia el estado del objeto desconectado en uno gestionado
            Departamento gestionado = em.merge(d);
            System.out.println("4. merge      -> contains(d) = " + em.contains(d)
                    + ", contains(gestionado) = " + em.contains(gestionado));

            // 5. REMOVED (eliminado): se borrará al hacer commit
            em.remove(gestionado);
            System.out.println("5. remove     -> contains = " + em.contains(gestionado));

            em.getTransaction().commit();
            System.out.println("6. commit     -> el DELETE ya se ha ejecutado");
        }

        // Error típico: persist de un objeto desconectado que ya tiene id
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            Departamento ventas = em.find(Departamento.class, 20);
            em.detach(ventas);
            em.getTransaction().begin();
            em.persist(ventas);
        } catch (RuntimeException e) {
            System.out.println("Error: " + e.getClass().getSimpleName() + ": " + e.getMessage());
        }
        JpaUtil.cerrar();
    }
}
Salida real:
1. Nuevo      -> contains = false, id = null
Hibernate: insert into departamentos (localidad, nombre, presupuesto) values (?, ?, ?)
2. persist    -> contains = true, id = 72
3. detach     -> contains = false
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
4. merge      -> contains(d) = false, contains(gestionado) = true
5. remove     -> contains = false
Hibernate: delete from departamentos where dept_id=?
6. commit     -> el DELETE ya se ha ejecutado
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
Error: EntityExistsException: Detached entity passed to persist: es.curso.empresa.modelo.Departamento
Hay un detalle muy interesante: entre el merge y el remove cambiamos la localidad a “Cuenca”, pero no aparece ningún UPDATE. Hibernate es lo bastante listo para no actualizar una fila que va a borrar en la misma transacción.
💡 Consejo: La regla práctica es sencilla:
persistpara objetos nuevos,mergepara objetos desconectados (por ejemplo, los que llegan de un formulario web o de una petición REST) y nada para objetos gestionados (basta con modificarlos).
11. El contexto de persistencia y la caché de primer nivel
📘 Concepto: El contexto de persistencia es el conjunto de entidades gestionadas por un
EntityManager. Funciona como un mapa(tipo, id) → objeto: dentro de un mismoEntityManager, un mismo id corresponde siempre al mismo objeto Java. A este mapa se le llama también caché de primer nivel; existe siempre, no se puede desactivar y dura lo que dura elEntityManager.
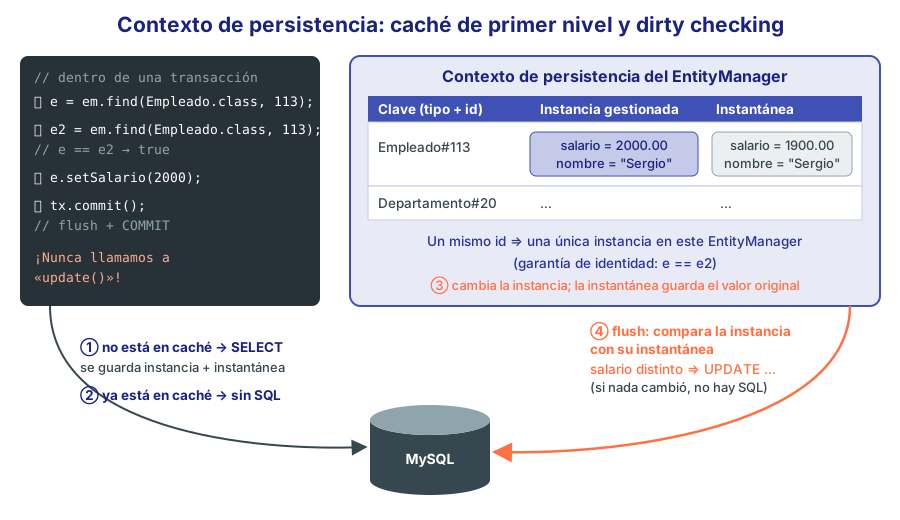
Figura 7. El contexto de persistencia: caché de primer nivel, instantáneas y dirty checking.
public class Ejemplo04CachePrimerNivel {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            System.out.println("--- Primer find(30) ---");
            Departamento a = em.find(Departamento.class, 30);
            System.out.println("--- Segundo find(30) en el MISMO EntityManager ---");
            Departamento b = em.find(Departamento.class, 30);
            System.out.println("¿Es el mismo objeto? " + (a == b));

            em.clear();     // vacía el contexto de persistencia
            System.out.println("--- find(30) después de clear() ---");
            Departamento c = em.find(Departamento.class, 30);
            System.out.println("¿a == c? " + (a == c));
        }

        try (EntityManager otro = JpaUtil.crearEntityManager()) {
            System.out.println("--- find(30) en OTRO EntityManager ---");
            otro.find(Departamento.class, 30);
        }
        JpaUtil.cerrar();
    }
}
Salida real:
--- Primer find(30) ---
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
--- Segundo find(30) en el MISMO EntityManager ---
¿Es el mismo objeto? true
--- find(30) después de clear() ---
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
¿a == c? false
--- find(30) en OTRO EntityManager ---
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
Conclusiones:
- El segundo
findno genera SQL: el objeto ya estaba en el contexto, y además es el mismo objeto (a == b). Es la garantía de identidad. - Tras
clear()el contexto está vacío y se vuelve a consultar; el objeto nuevo es distinto del anterior. - Otro
EntityManagertiene su propio contexto: no comparte la caché.
⚠️ Importante: La caché de primer nivel no es una caché global de la aplicación: vive dentro de cada
EntityManager, que normalmente dura una petición. Por eso no tiene problemas de datos obsoletos entre usuarios. La caché compartida entreEntityManageres la caché de segundo nivel, opcional, que verás en el módulo 16.
⚠️ Importante: Un
EntityManagerque se usa durante mucho tiempo (por ejemplo, para procesar 100 000 filas en un bucle) acumula todos los objetos en su contexto y puede agotar la memoria. En procesos por lotes, llama periódicamente aem.flush()yem.clear().
12. Dirty checking: actualizaciones automáticas
📘 Concepto: Cuando Hibernate carga una entidad, guarda una instantánea (snapshot) de sus valores. Al hacer flush compara cada entidad gestionada con su instantánea y, si algo ha cambiado (la entidad está “sucia”, dirty), genera el
UPDATE. Por eso en JPA no existe un métodoupdate(): basta con modificar el objeto gestionado.
public class Ejemplo05DirtyChecking {

    public static void main(String[] args) {
        BigDecimal original;
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.getTransaction().begin();
            Empleado sergio = em.find(Empleado.class, 113);
            original = sergio.getSalario();
            System.out.println("Salario actual: " + original);

            sergio.setSalario(new BigDecimal("2000.00"));   // ¡solo un setter!
            System.out.println("--- commit ---");
            em.getTransaction().commit();                   // Hibernate detecta el cambio
        }

        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.getTransaction().begin();
            Empleado sergio = em.find(Empleado.class, 113);
            sergio.setSalario(new BigDecimal("2000.00"));   // mismo valor que ya tiene
            System.out.println("--- commit sin cambios reales ---");
            em.getTransaction().commit();                   // no hay UPDATE

            em.getTransaction().begin();
            sergio.setSalario(original);                     // dejamos el dato como estaba
            System.out.println("--- commit restaurando el salario ---");
            em.getTransaction().commit();
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        e1_0.emp_id,
        e1_0.apellidos,
        ...
        e1_0.telefono
    from
        empleados e1_0
    where
        e1_0.emp_id=?
Salario actual: 1900.00
--- commit ---
Hibernate:
    update
        empleados
    set
        apellidos=?,
        comision=?,
        dept_id=?,
        email=?,
        fecha_alta=?,
        jefe_id=?,
        nombre=?,
        oficio=?,
        salario=?,
        telefono=?
    where
        emp_id=?
Hibernate:
    select
        e1_0.emp_id,
        ...
    from
        empleados e1_0
    where
        e1_0.emp_id=?
--- commit sin cambios reales ---
--- commit restaurando el salario ---
Hibernate:
    update
        empleados
    set
        apellidos=?,
        ...
        salario=?,
        telefono=?
    where
        emp_id=?
Tres observaciones importantes:
- Hemos cambiado el salario con un simple setter y Hibernate ha generado el
UPDATEen elcommit. - Si el nuevo valor es igual al anterior (
2000.00→2000.00), no hayUPDATE: Hibernate compara valores, no llamadas a setters. - El
UPDATEincluye todas las columnas, no solosalario. Hibernate lo hace así para poder reutilizar siempre la misma sentencia preparada (más eficiente en la mayoría de casos).
💡 Consejo: Si una tabla tiene muchas columnas o columnas muy grandes, la anotación de Hibernate
@DynamicUpdate(en la clase de la entidad) hace que elUPDATEincluya solo las columnas modificadas. Pruébalo en el ejercicio propuesto 5.
13. El flush
📘 Concepto: Hacer flush es enviar a la base de datos las sentencias SQL pendientes (
INSERT,UPDATE,DELETE) que el contexto de persistencia ha ido acumulando. No es lo mismo quecommit: tras un flush los cambios están en la base de datos pero dentro de la transacción; si después se hacerollback, se deshacen.
¿Cuándo hace flush Hibernate?
| Momento | Modo AUTO (por defecto) | Modo COMMIT |
|---|---|---|
Al hacer commit() | Sí | Sí |
| Antes de una consulta JPQL/SQL cuyo resultado podría depender de cambios pendientes | Sí | No |
Al llamar a em.flush() | Sí | Sí |
public class Ejemplo06Flush {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.getTransaction().begin();
            Empleado tomas = em.find(Empleado.class, 160);      // becario: 900 €
            tomas.setSalario(new BigDecimal("1200.00"));

            // FlushMode AUTO (por defecto): antes de una consulta que puede verse
            // afectada por cambios pendientes, Hibernate hace flush automáticamente
            System.out.println("--- Consulta JPQL con FlushMode AUTO ---");
            Long n = em.createQuery(
                    "select count(e) from Empleado e where e.salario < 1000", Long.class)
                    .getSingleResult();
            System.out.println("Empleados con salario < 1000: " + n);

            // flush explícito: envía el SQL pendiente, pero NO confirma la transacción
            tomas.setTelefono("600100160");
            System.out.println("--- flush() explícito ---");
            em.flush();

            System.out.println("--- rollback ---");
            em.getTransaction().rollback();     // se deshace TODO, también lo ya enviado
        }

        try (EntityManager em = JpaUtil.crearEntityManager()) {
            Empleado tomas = em.find(Empleado.class, 160);
            System.out.println("Tras el rollback: salario = " + tomas.getSalario()
                    + ", teléfono = " + tomas.getTelefono());

            em.setFlushMode(FlushModeType.COMMIT);   // solo flush al hacer commit
            em.getTransaction().begin();
            tomas.setSalario(new BigDecimal("1200.00"));
            System.out.println("--- Consulta JPQL con FlushMode COMMIT ---");
            Long n = em.createQuery(
                    "select count(e) from Empleado e where e.salario < 1000", Long.class)
                    .getSingleResult();
            System.out.println("Empleados con salario < 1000: " + n + "  (¡la BD aún no lo sabe!)");
            em.getTransaction().rollback();
        }
        JpaUtil.cerrar();
    }
}
Salida real (hemos abreviado las listas de columnas con ...):
Hibernate:
    select
        e1_0.emp_id,
        ...
    from
        empleados e1_0
    where
        e1_0.emp_id=?
--- Consulta JPQL con FlushMode AUTO ---
Hibernate:
    update
        empleados
    set
        apellidos=?,
        ...
    where
        emp_id=?
Hibernate:
    select
        count(e1_0.emp_id)
    from
        empleados e1_0
    where
        e1_0.salario<1000
Empleados con salario < 1000: 0
--- flush() explícito ---
Hibernate:
    update
        empleados
    set
        apellidos=?,
        ...
    where
        emp_id=?
--- rollback ---
Hibernate:
    select
        e1_0.emp_id,
        ...
    from
        empleados e1_0
    where
        e1_0.emp_id=?
Tras el rollback: salario = 900.00, teléfono = null
--- Consulta JPQL con FlushMode COMMIT ---
Hibernate: select ... from empleados e1_0 where e1_0.salario<1000
Empleados con salario < 1000: 1  (¡la BD aún no lo sabe!)
- Con
AUTO, elUPDATEsale justo antes de la consulta, que así devuelve 0 (Tomás ya cobra 1200 dentro de la transacción). flush()envía el segundoUPDATE, pero elrollbacklo deshace todo: al releer, Tomás sigue cobrando 900 y sin teléfono.- Con
COMMIT, la consulta no ve el cambio pendiente y devuelve 1: el resultado es “incorrecto” desde el punto de vista del programa. Por esoAUTOes el valor por defecto y el recomendado.
14. Claves primarias compuestas
Dos tablas de EMPRESA tienen clave primaria compuesta:
lineas_pedido:(pedido_id, num_linea), la típica entidad débil.asignaciones:(emp_id, proyecto_id), la tabla de la relación N:M entre empleados y proyectos.
JPA ofrece dos formas de mapearlas. En ambas hace falta una clase de clave que sea Serializable e implemente equals y hashCode; un record cumple todo eso automáticamente (excepto Serializable, que hay que declarar).
14.1 @EmbeddedId: la clave es un objeto
package es.curso.empresa.modelo;

import jakarta.persistence.Column;
import jakarta.persistence.Embeddable;
import java.io.Serializable;

/** Clave primaria compuesta de lineas_pedido: (pedido_id, num_linea). */
@Embeddable
public record LineaPedidoId(
        @Column(name = "pedido_id") Integer pedidoId,
        @Column(name = "num_linea") Integer numLinea) implements Serializable {
}
@Entity
@Table(name = "lineas_pedido")
public class LineaPedido {

    @EmbeddedId                       // La clave es un objeto con dos columnas
    private LineaPedidoId id;

    @Column(name = "producto_id", nullable = false)
    private Integer productoId;

    @Column(nullable = false)
    private int cantidad;

    @Column(name = "precio_unitario", nullable = false, precision = 8, scale = 2)
    private BigDecimal precioUnitario;

    @Column(nullable = false, precision = 4, scale = 2)
    private BigDecimal descuento;

    protected LineaPedido() { }

    public LineaPedido(LineaPedidoId id, Integer productoId, int cantidad,
                       BigDecimal precioUnitario, BigDecimal descuento) {
        this.id = id;
        this.productoId = productoId;
        this.cantidad = cantidad;
        this.precioUnitario = precioUnitario;
        this.descuento = descuento;
    }

    /** Importe = cantidad * precio * (1 - descuento/100). */
    public BigDecimal getImporte() {
        BigDecimal bruto = precioUnitario.multiply(BigDecimal.valueOf(cantidad));
        BigDecimal factor = BigDecimal.ONE.subtract(descuento.movePointLeft(2));
        return bruto.multiply(factor).setScale(2, java.math.RoundingMode.HALF_UP);
    }
    // getters y toString
}
14.2 @IdClass: varios @Id en la entidad
/** Clase de clave para @IdClass: mismos nombres y tipos que los @Id de Asignacion. */
public record AsignacionId(Integer empId, Integer proyectoId) implements Serializable {
}
@Entity
@Table(name = "asignaciones")
@IdClass(AsignacionId.class)          // La clave se describe en otra clase
public class Asignacion {

    @Id
    @Column(name = "emp_id")
    private Integer empId;

    @Id
    @Column(name = "proyecto_id")
    private Integer proyectoId;

    @Column(name = "fecha_asignacion", nullable = false)
    private LocalDate fechaAsignacion;

    private Integer horas;

    @Column(length = 30)
    private String funcion;

    protected Asignacion() { }
    // getters, setHoras y toString
}
14.3 Usarlas
public class Ejemplo07ClavesCompuestas {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            // @EmbeddedId: la clave es un objeto LineaPedidoId
            LineaPedido linea = em.find(LineaPedido.class, new LineaPedidoId(5001, 3));
            System.out.println(linea);

            // @IdClass: la clave se pasa como un objeto AsignacionId
            Asignacion asig = em.find(Asignacion.class, new AsignacionId(120, 1));
            System.out.println(asig);

            // Alta de una línea nueva: la clave la asignamos nosotros
            em.getTransaction().begin();
            LineaPedidoId id = new LineaPedidoId(5024, 2);
            em.persist(new LineaPedido(id, 6, 3, new BigDecimal("19.90"), BigDecimal.ZERO));
            em.getTransaction().commit();

            em.getTransaction().begin();
            em.remove(em.find(LineaPedido.class, id));
            em.getTransaction().commit();
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        lp1_0.pedido_id,
        lp1_0.num_linea,
        ...
        lp1_0.producto_id
    from
        lineas_pedido lp1_0
    where
        (
            lp1_0.pedido_id, lp1_0.num_linea
        ) in ((?, ?))
LineaPedido[5001/3, producto=9, cantidad=2, importe=264.10]
Hibernate:
    select
        a1_0.emp_id,
        a1_0.proyecto_id,
        ...
        a1_0.horas
    from
        asignaciones a1_0
    where
        (
            a1_0.emp_id, a1_0.proyecto_id
        ) in ((?, ?))
Asignacion[emp=120, proyecto=1, horas=450, funcion=Jefe de proyecto]
Hibernate:
    insert
    into
        lineas_pedido
        (cantidad, descuento, precio_unitario, producto_id, pedido_id, num_linea)
    values
        (?, ?, ?, ?, ?, ?)
Hibernate:
    delete
    from
        lineas_pedido
    where
        pedido_id=?
        and num_linea=?
Fíjate en que, para buscar por clave compuesta, Hibernate genera una comparación de tuplas (pedido_id, num_linea) in ((?, ?)), que MySQL admite. En el INSERT no hay GeneratedValue: con claves compuestas, los valores los pones tú.
@EmbeddedId | @IdClass | |
|---|---|---|
| Dónde están las columnas de la clave | En la clase embebible | En la propia entidad (varios @Id) |
| Acceso al valor | linea.getId().pedidoId() | asignacion.getEmpId() |
| En JPQL | where l.id.pedidoId = 5001 | where a.empId = 120 |
| Cuándo elegirla | Cuando la clave es un concepto en sí mismo | Cuando quieres que la entidad “parezca” normal |
💡 Consejo: En el módulo 15 verás que la parte
pedido_idde la clave deLineaPedidotambién es una clave ajena haciapedidos. Lo resolveremos con@MapsId, que permite que la relación@ManyToOney la clave compartan columna.
15. Objetos embebibles: @Embeddable
No todo objeto de tu modelo necesita una tabla propia. La ciudad y la provincia de un cliente forman un concepto (Ubicacion) que no tiene identidad propia: solo existe como parte del cliente. JPA permite modelarlo como un objeto embebible, cuyas columnas están en la tabla de la entidad que lo contiene.
package es.curso.empresa.modelo;

import jakarta.persistence.Column;
import jakarta.persistence.Embeddable;

/** Objeto de valor: no tiene identidad propia, vive dentro de otra entidad. */
@Embeddable
public record Ubicacion(
        @Column(length = 40) String ciudad,
        @Column(length = 30) String provincia) {

    @Override
    public String toString() { return ciudad + " (" + provincia + ")"; }
}
@Entity
@Table(name = "clientes")
public class Cliente {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    @Column(name = "cliente_id")
    private Integer id;

    // ... nombre, nif (unique), email, telefono

    @Embedded                       // Sus columnas (ciudad, provincia) están en clientes
    private Ubicacion ubicacion;

    @Column(name = "fecha_alta", nullable = false)
    private LocalDate fechaAlta;

    @Column(name = "limite_credito", precision = 10, scale = 2)
    private BigDecimal limiteCredito;

    @Column(name = "comercial_id")
    private Integer comercialId;    // en el módulo 15: @ManyToOne Empleado comercial

    protected Cliente() { }

    public Cliente(String nombre, String nif, Ubicacion ubicacion) {
        this.nombre = nombre;
        this.nif = nif;
        this.ubicacion = ubicacion;
        this.fechaAlta = LocalDate.now();
        this.limiteCredito = new BigDecimal("3000");
    }
    // getters, setters y toString
}
⚠️ Importante: La columna
fecha_altadeclientestiene un valor por defecto en MySQL (DEFAULT (CURRENT_DATE)), pero Hibernate siempre incluye en elINSERTtodas las columnas mapeadas; si el atributo valenull, envíaNULLexplícitamente y el valor por defecto no se aplica (y como la columna esNOT NULL, elINSERTfalla). Por eso el constructor asigna la fecha y el límite de crédito.
public class Ejemplo08Embebible {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            Cliente c = em.find(Cliente.class, 1005);
            System.out.println(c);
            System.out.println("Ciudad: " + c.getUbicacion().ciudad());

            Pedido p = em.find(Pedido.class, 5022);
            System.out.println(p + " -> ¿pendiente? " + (p.getEstado() == EstadoPedido.PENDIENTE));

            Producto altavoz = em.find(Producto.class, 14);
            System.out.println(altavoz);

            em.getTransaction().begin();
            Cliente nuevo = new Cliente("Librería Cervantes", "B11223344",
                    new Ubicacion("Alcalá de Henares", "Madrid"));
            em.persist(nuevo);
            em.getTransaction().commit();

            em.getTransaction().begin();
            em.remove(nuevo);
            em.getTransaction().commit();
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        c1_0.cliente_id,
        c1_0.comercial_id,
        ...
        c1_0.provincia
    from
        clientes c1_0
    where
        c1_0.cliente_id=?
Cliente[id=1005, Clínica Dental Sonrisa, Sevilla (Sevilla)]
Ciudad: Sevilla
Hibernate:
    select
        p1_0.pedido_id,
        p1_0.cliente_id,
        ...
        p1_0.fecha_pedido
    from
        pedidos p1_0
    where
        p1_0.pedido_id=?
Pedido[id=5022, cliente=1012, fecha=2026-07-01, estado=PENDIENTE] -> ¿pendiente? true
Hibernate:
    select
        p1_0.producto_id,
        p1_0.categoria_id,
        ...
        p1_0.stock
    from
        productos p1_0
    where
        p1_0.producto_id=?
Producto[id=14, Altavoz Inteligente, precio=49.00, stock=0, descatalogado=true]
Hibernate:
    insert
    into
        clientes
        (comercial_id, email, fecha_alta, limite_credito, nif, nombre, telefono, ciudad, provincia)
    values
        (?, ?, ?, ?, ?, ?, ?, ?, ?)
Hibernate:
    delete
    from
        clientes
    where
        cliente_id=?
En una sola salida tienes los tres “trucos” de mapeo: las columnas ciudad y provincia del embebible aparecen en el SELECT de clientes, el texto 'PENDIENTE' se convierte en EstadoPedido.PENDIENTE y el 'S' del altavoz descatalogado se convierte en true.
15.1 Reutilizar un embebible: @AttributeOverride
Si una entidad contiene dos objetos del mismo tipo embebible (por ejemplo, dirección de facturación y de envío), sus columnas chocarían. @AttributeOverride cambia el nombre de columna para un uso concreto:
@Embedded
@AttributeOverride(name = "ciudad",    column = @Column(name = "ciudad_envio"))
@AttributeOverride(name = "provincia", column = @Column(name = "provincia_envio"))
private Ubicacion ubicacionEnvio;
| Concepto | Entidad | Embebible |
|---|---|---|
Identidad propia (@Id) | Sí | No |
| Tabla propia | Sí | No: sus columnas están en la tabla de la entidad |
| Ciclo de vida | Independiente | El de la entidad que lo contiene |
| Ejemplos | Cliente, Pedido | Ubicacion, Dinero, Periodo, LineaPedidoId |
16. Buenas prácticas y errores comunes
| Error o síntoma | Causa | Solución |
|---|---|---|
No Persistence provider for EntityManager named empresa | persistence.xml fuera de META-INF/, o nombre de unidad distinto | Comprueba la ruta src/main/resources/META-INF/persistence.xml y el name |
Unable to locate persister / Not an entity | La clase no tiene @Entity o no está listada en <class> | Añade la anotación o la línea <class> |
Schema validation: missing column [...] | El nombre de @Column no coincide con la tabla | Corrige el mapeo (¡validate ha hecho su trabajo!) |
No default constructor for entity | Falta el constructor sin argumentos | Añade un constructor protected vacío |
Detached entity passed to persist | persist sobre un objeto con id que viene de otro EntityManager | Usa merge |
| Cambios que no se guardan | El objeto está desconectado, o falta el commit | Modifica el objeto devuelto por merge y haz commit |
TransactionRequiredException | Operación de escritura sin transacción activa | Envuélvela en begin/commit o runInTransaction |
import javax.persistence no compila | Código antiguo (anterior a Jakarta EE 9) | Usa jakarta.persistence |
Datos de un enum “cambiados” | @Enumerated por defecto (ORDINAL) | Usa siempre EnumType.STRING |
| Memoria agotada en un proceso masivo | El contexto de persistencia acumula objetos | flush() y clear() cada N elementos |
💡 Consejo: Resumen de buenas prácticas de este módulo: una única
EntityManagerFactory; unEntityManagercorto por unidad de trabajo;validatecon bases de datos existentes;@Enumerated(EnumType.STRING);BigDecimalpara el dinero yjava.timepara fechas; identificadores con tipos envoltorio; y mira siempre el SQL generado mientras desarrollas.
17. Ejercicios
Los ejercicios usan el proyecto del módulo (JpaUtil y las entidades del paquete modelo). Recuerda restaurar los datos que modifiques o, al terminar, recargar los scripts de EMPRESA. En las salidas se han omitido las sentencias Hibernate: cuando no aportan nada al ejercicio.
Ejercicio 1: Mapear la tabla proyectos
Crea la entidad Proyecto para la tabla proyectos (por ahora con deptId como Integer). Añade un método diasDuracion(LocalDate hoy) que devuelva los días entre la fecha de inicio y la de fin, o hasta hoy si el proyecto sigue abierto (fecha_fin nula), y un método isAbierto(). Muestra los cinco proyectos con su estado y duración tomando como “hoy” el 4 de octubre de 2026. No olvides añadir la clase a persistence.xml y comprobar que validate la acepta.
Ver solución
@Entity
@Table(name = "proyectos")
public class Proyecto {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    @Column(name = "proyecto_id")
    private Integer id;

    @Column(nullable = false, length = 60, unique = true)
    private String nombre;

    @Column(name = "dept_id")
    private Integer deptId;

    @Column(name = "fecha_inicio", nullable = false)
    private LocalDate fechaInicio;

    @Column(name = "fecha_fin")
    private LocalDate fechaFin;

    @Column(precision = 12, scale = 2)
    private BigDecimal presupuesto;

    protected Proyecto() { }

    /** Días transcurridos: hasta la fecha de fin o, si sigue abierto, hasta 'hoy'. */
    public long diasDuracion(LocalDate hoy) {
        LocalDate fin = (fechaFin != null) ? fechaFin : hoy;
        return ChronoUnit.DAYS.between(fechaInicio, fin);
    }

    public boolean isAbierto() { return fechaFin == null; }

    public Integer getId() { return id; }
    public String getNombre() { return nombre; }
    public LocalDate getFechaInicio() { return fechaInicio; }
    public LocalDate getFechaFin() { return fechaFin; }
}
public class Ejercicio1 {

    public static void main(String[] args) {
        LocalDate hoy = LocalDate.of(2026, 10, 4);       // fecha fija para que la salida sea reproducible
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            for (int id = 1; id <= 5; id++) {
                Proyecto p = em.find(Proyecto.class, id);
                System.out.printf("%-26s %-9s %4d días%n", p.getNombre(),
                        p.isAbierto() ? "ABIERTO" : "CERRADO", p.diasDuracion(hoy));
            }
        }
        JpaUtil.cerrar();
    }
}
Salida real (sin las cinco sentencias select ... from proyectos p1_0 where p1_0.proyecto_id=?):
Migración a la nube        CERRADO    266 días
Nueva tienda online        ABIERTO    490 días
Campaña Navidad 2025       CERRADO     91 días
Optimización de almacén    ABIERTO    245 días
Plan estratégico 2027      ABIERTO     33 días
La lógica de negocio (diasDuracion, isAbierto) vive en la entidad: es Java normal, y como no hay atributo detrás, JPA no intenta guardarla. Se usa ChronoUnit.DAYS.between del módulo 05 y una fecha fija para que el resultado sea reproducible.
Ejercicio 2: La caché de primer nivel con categorías
Mapea la tabla categorias (con padreId como Integer) y añade un método isRaiz(). Después, con un único EntityManager: (a) busca las categorías 1, 2 y 3 dos veces seguidas y comprueba en el log cuántas consultas se lanzan; (b) construye la ruta completa de la categoría 5 subiendo por los padres (Informática > Periféricos > Ratones y teclados).
Ver solución
@Entity
@Table(name = "categorias")
public class Categoria {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    @Column(name = "categoria_id")
    private Integer id;

    @Column(nullable = false, length = 40, unique = true)
    private String nombre;

    @Column(name = "categoria_padre_id")
    private Integer padreId;

    protected Categoria() { }

    public boolean isRaiz() { return padreId == null; }

    public Integer getId() { return id; }
    public String getNombre() { return nombre; }
    public Integer getPadreId() { return padreId; }

    @Override
    public String toString() { return id + " " + nombre + (isRaiz() ? " (raíz)" : " -> padre " + padreId); }
}
public class Ejercicio2 {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            System.out.println("=== Primera pasada ===");
            for (int id = 1; id <= 3; id++) {
                System.out.println(em.find(Categoria.class, id));
            }
            System.out.println("=== Segunda pasada (mismo EntityManager) ===");
            for (int id = 1; id <= 3; id++) {
                System.out.println(em.find(Categoria.class, id));
            }
            // Ruta hasta la raíz de la categoría 5 (Ratones y teclados)
            System.out.println("=== Ruta de la categoría 5 ===");
            Categoria c = em.find(Categoria.class, 5);
            StringBuilder ruta = new StringBuilder(c.getNombre());
            while (!c.isRaiz()) {
                c = em.find(Categoria.class, c.getPadreId());
                ruta.insert(0, c.getNombre() + " > ");
            }
            System.out.println(ruta);
        }
        JpaUtil.cerrar();
    }
}
Salida real (se muestran solo las líneas del programa; las sentencias SQL se comentan debajo):
=== Primera pasada ===
1 Informática (raíz)
2 Portátiles -> padre 1
3 Ordenadores sobremesa -> padre 1
=== Segunda pasada (mismo EntityManager) ===
1 Informática (raíz)
2 Portátiles -> padre 1
3 Ordenadores sobremesa -> padre 1
=== Ruta de la categoría 5 ===
Informática > Periféricos > Ratones y teclados
En el log aparecen exactamente cinco select ... from categorias: tres en la primera pasada (categorías 1, 2 y 3), ninguno en la segunda (las tres están ya en el contexto de persistencia) y dos al construir la ruta (la 5 y la 4); la 1 ya estaba en caché. Es la caché de primer nivel trabajando a tu favor.
Ejercicio 3: CRUD de clientes con runInTransaction
Usando solo runInTransaction y callInTransaction, da de alta el cliente “Ferretería El Clavo” (NIF B99887766, Cuenca), auméntale el límite de crédito en 1500 € sin llamar a ningún método de actualización, muéstralo desde otra unidad de trabajo y, por último, bórralo.
Ver solución
public class Ejercicio3 {

    public static void main(String[] args) {
        EntityManagerFactory emf = JpaUtil.getEmf();

        // Alta
        Integer id = emf.callInTransaction(em -> {
            Cliente c = new Cliente("Ferretería El Clavo", "B99887766", new Ubicacion("Cuenca", "Cuenca"));
            c.setTelefono("969112233");
            em.persist(c);
            return c.getId();
        });
        System.out.println("Alta del cliente " + id);

        // Modificación: basta con cambiar el objeto gestionado
        emf.runInTransaction(em -> {
            Cliente c = em.find(Cliente.class, id);
            c.setLimiteCredito(c.getLimiteCredito().add(new BigDecimal("1500")));
        });

        // Consulta en otra unidad de trabajo
        emf.runInTransaction(em -> {
            Cliente c = em.find(Cliente.class, id);
            System.out.println(c + " límite = " + c.getLimiteCredito());
        });

        // Baja
        emf.runInTransaction(em -> em.remove(em.find(Cliente.class, id)));
        System.out.println("Baja realizada");
        JpaUtil.cerrar();
    }
}
Salida real (solo las líneas del programa):
Alta del cliente 1016
Cliente[id=1016, Ferretería El Clavo, Cuenca (Cuenca)] límite = 4500.00
Baja realizada
Entre esas líneas, el log muestra un insert into clientes, después un select y un update clientes set ... (la modificación, detectada por dirty checking en el commit de runInTransaction), otro select en la tercera unidad de trabajo y, por último, select + delete. El id 1016 es simplemente el siguiente valor del AUTO_INCREMENT en el momento de ejecutarlo: en tu base de datos puede ser otro. Observa que cada runInTransaction usa un EntityManager nuevo, así que el objeto de una lambda no está gestionado en la siguiente: por eso cada una vuelve a hacer find.
Ejercicio 4: Enviar un pedido (enumerados y reglas de negocio)
Escribe un método enviarPedido(int pedidoId, LocalDate fecha) que marque un pedido como ENVIADO y rellene su fecha de envío, pero solo si está PENDIENTE; en otro caso debe lanzar IllegalStateException y deshacer la transacción. Pruébalo con el pedido 5022 (pendiente) y con el 5001 (entregado), y deja después el 5022 como estaba.
Ver solución
public class Ejercicio4 {

    /** Marca un pedido como ENVIADO. Solo se pueden enviar pedidos PENDIENTES. */
    static void enviarPedido(int pedidoId, LocalDate fecha) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.getTransaction().begin();
            try {
                Pedido p = em.find(Pedido.class, pedidoId);
                if (p == null) {
                    throw new IllegalArgumentException("No existe el pedido " + pedidoId);
                }
                if (p.getEstado() != EstadoPedido.PENDIENTE) {
                    throw new IllegalStateException("El pedido " + pedidoId + " está " + p.getEstado());
                }
                p.setEstado(EstadoPedido.ENVIADO);
                p.setFechaEnvio(fecha);
                em.getTransaction().commit();
                System.out.println("Pedido " + pedidoId + " enviado el " + fecha);
            } catch (RuntimeException e) {
                em.getTransaction().rollback();
                throw e;
            }
        }
    }

    public static void main(String[] args) {
        enviarPedido(5022, LocalDate.of(2026, 10, 4));
        try {
            enviarPedido(5001, LocalDate.of(2026, 10, 4));
        } catch (IllegalStateException e) {
            System.out.println("Error: " + e.getMessage());
        }
        // Dejamos el pedido 5022 como estaba
        JpaUtil.getEmf().runInTransaction(em -> {
            Pedido p = em.find(Pedido.class, 5022);
            p.setEstado(EstadoPedido.PENDIENTE);
            p.setFechaEnvio(null);
        });
        JpaUtil.cerrar();
    }
}
Salida real (resumida):
Hibernate: select ... from pedidos p1_0 where p1_0.pedido_id=?
Hibernate: update pedidos set ... where pedido_id=?
Pedido 5022 enviado el 2026-10-04
Hibernate: select ... from pedidos p1_0 where p1_0.pedido_id=?
Error: El pedido 5001 está ENTREGADO
Hibernate: select ... from pedidos p1_0 where p1_0.pedido_id=?
Hibernate: update pedidos set ... where pedido_id=?
Comparar enumerados con == es correcto y seguro (cada constante es única). En el pedido 5001 no hay UPDATE: la excepción se lanza antes de modificar nada y el rollback cierra la transacción limpiamente.
Ejercicio 5: Claves compuestas en acción
(a) Calcula el total del pedido 5010 buscando sus líneas con find y LineaPedidoId (líneas 1, 2, 3… hasta que find devuelva null). (b) Suma 10 horas a la asignación del empleado 122 en el proyecto 2 usando AsignacionId, muéstralo y deshaz el cambio.
Ver solución
public class Ejercicio5 {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            // a) Total del pedido 5010 recorriendo sus líneas 1, 2, 3... hasta que no haya más
            BigDecimal total = BigDecimal.ZERO;
            int num = 1;
            LineaPedido linea;
            while ((linea = em.find(LineaPedido.class, new LineaPedidoId(5010, num))) != null) {
                total = total.add(linea.getImporte());
                num++;
            }
            System.out.println("Pedido 5010: " + (num - 1) + " líneas, total = " + total + " €");

            // b) Sumar 10 horas a la asignación (122, 2) y deshacerlo
            em.getTransaction().begin();
            Asignacion a = em.find(Asignacion.class, new AsignacionId(122, 2));
            int antes = a.getHoras();
            a.setHoras(antes + 10);
            em.getTransaction().commit();
            System.out.println("Horas de 122 en el proyecto 2: " + antes + " -> " + a.getHoras());

            em.getTransaction().begin();
            a.setHoras(antes);
            em.getTransaction().commit();
        }
        JpaUtil.cerrar();
    }
}
Salida real (resumida):
Hibernate: select ... from lineas_pedido lp1_0 where (lp1_0.pedido_id, lp1_0.num_linea) in ((?, ?))
   (... la misma consulta, 5 veces en total ...)
Pedido 5010: 4 líneas, total = 11657.50 €
Hibernate: select ... from asignaciones a1_0 where (a1_0.emp_id, a1_0.proyecto_id) in ((?, ?))
Hibernate:
    update
        asignaciones
    set
        fecha_asignacion=?,
        funcion=?,
        horas=?
    where
        emp_id=?
        and proyecto_id=?
Horas de 122 en el proyecto 2: 520 -> 530
Hibernate: update asignaciones set ... where emp_id=? and proyecto_id=?
Funciona, pero fíjate en el coste: cinco consultas para leer cuatro líneas (la quinta devuelve vacío). Es exactamente el tipo de patrón que resolverás en el módulo 15 con la colección pedido.getLineas() y en el 16 con una sola consulta JPQL. En el UPDATE de asignaciones las columnas de la clave van en el WHERE, nunca en el SET: la clave primaria de una entidad no se puede modificar.
Ejercicio 6: Transferencia de presupuesto (todo o nada)
Escribe transferir(origenId, destinoId, importe) que mueva presupuesto entre dos departamentos en una sola transacción. Para comprobar que el rollback deshace incluso lo ya modificado, suma primero al destino y comprueba después si el origen tiene saldo suficiente. Prueba a transferir 20 000 € de CONTABILIDAD (40) a INVESTIGACIÓN (70, presupuesto NULL) y luego 999 999 €. Restaura los valores originales.
Ver solución
public class Ejercicio6 {

    /** Mueve 'importe' del presupuesto de un departamento a otro, todo o nada. */
    static void transferir(int origenId, int destinoId, BigDecimal importe) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            EntityTransaction tx = em.getTransaction();
            try {
                tx.begin();
                Departamento origen = em.find(Departamento.class, origenId);
                Departamento destino = em.find(Departamento.class, destinoId);
                BigDecimal saldoDestino = destino.getPresupuesto() == null
                        ? BigDecimal.ZERO : destino.getPresupuesto();

                destino.setPresupuesto(saldoDestino.add(importe));          // primero sumamos...
                if (origen.getPresupuesto().compareTo(importe) < 0) {      // ...y luego comprobamos
                    throw new IllegalStateException("Presupuesto insuficiente en " + origen.getNombre());
                }
                origen.setPresupuesto(origen.getPresupuesto().subtract(importe));
                tx.commit();
                System.out.println("Transferidos " + importe + " de " + origen.getNombre()
                        + " a " + destino.getNombre());
            } catch (RuntimeException e) {
                if (tx.isActive()) tx.rollback();
                System.out.println("Operación anulada: " + e.getMessage());
            }
        }
    }

    static void mostrar(int... ids) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            for (int id : ids) {
                Departamento d = em.find(Departamento.class, id);
                System.out.println("  " + d.getNombre() + ": " + d.getPresupuesto());
            }
        }
    }

    public static void main(String[] args) {
        mostrar(40, 70);
        transferir(40, 70, new BigDecimal("20000"));
        mostrar(40, 70);
        transferir(40, 70, new BigDecimal("999999"));
        mostrar(40, 70);
        // Restauramos los datos originales
        JpaUtil.getEmf().runInTransaction(em -> {
            em.find(Departamento.class, 40).setPresupuesto(new BigDecimal("150000"));
            em.find(Departamento.class, 70).setPresupuesto(null);
        });
        JpaUtil.cerrar();
    }
}
Salida real (solo las líneas del programa; entre ellas aparecen los select y update de departamentos):
  CONTABILIDAD: 150000.00
  INVESTIGACIÓN: null
Transferidos 20000 de CONTABILIDAD a INVESTIGACIÓN
  CONTABILIDAD: 130000.00
  INVESTIGACIÓN: 20000.00
Operación anulada: Presupuesto insuficiente en CONTABILIDAD
  CONTABILIDAD: 130000.00
  INVESTIGACIÓN: 20000.00
En la transferencia fallida el destino sí se había modificado en memoria, pero como la excepción se produce antes del commit, no llega a haber flush: el rollback descarta el cambio y en el log no aparece ningún update. En la correcta aparecen dos update (uno por departamento) en el commit.
Ejercicios propuestos
Ejercicio 7: @IdClass frente a @EmbeddedId
Vuelve a mapear LineaPedido usando @IdClass en lugar de @EmbeddedId, y Asignacion usando @EmbeddedId en lugar de @IdClass. Comprueba con validate que ambas siguen encajando, compara el SQL que se genera al buscar por clave y escribe en un comentario qué versión te resulta más cómoda y por qué.
Ejercicio 8: Un embebible para el contacto
Crea un record embebible Contacto(String email, String telefono) y úsalo en Empleado y en Cliente en lugar de los dos atributos sueltos. Añade al record un método tieneTelefono(). Lista los empleados 120 a 124 indicando cuáles no tienen teléfono.
Ejercicio 9: Un DAO genérico con JPA
Recuerda el patrón DAO del módulo 13. Escribe una clase DaoJpa<T, ID> con los métodos Optional<T> buscar(ID id), T guardar(T entidad) (que use persist si es nueva y merge si no; pista: emf.getPersistenceUnitUtil().getIdentifier(entidad)) y void borrar(ID id). Úsala con Departamento y con Cliente y compara su tamaño con el DAO JDBC del módulo 13.
Ejercicio 10: Conversor para el estado del pedido
Escribe un AttributeConverter<EstadoPedido, String> que guarde los estados con su nombre, pero que al leer acepte el texto sin distinguir mayúsculas de minúsculas y lance una excepción con un mensaje claro si el valor no existe. Sustituye @Enumerated por @Convert en Pedido y comprueba que todo sigue funcionando.
Ejercicio 11: @DynamicUpdate
Anota Empleado con @org.hibernate.annotations.DynamicUpdate y repite el ejemplo de dirty checking. Compara el UPDATE generado con el de la sección 12. ¿Qué ventajas e inconvenientes tiene? Pista: piensa en cuántas sentencias preparadas distintas puede necesitar Hibernate.
Ejercicio 12: Laboratorio de hbm2ddl.auto
Crea una unidad de persistencia de laboratorio con una entidad nueva Nota (tabla notas). Prueba sucesivamente create, update (añade un atributo nuevo a la entidad entre dos ejecuciones), validate (quita la columna a mano con ALTER TABLE) y create-drop. Anota qué SQL genera Hibernate en cada caso y qué pasa con los datos. Al terminar, asegúrate de que la tabla notas no queda en la base de datos.
Resumen
| Concepto | Sintaxis / clave |
|---|---|
| ORM | Traduce automáticamente entre objetos y tablas; genera el SQL |
| Especificación / implementación | Jakarta Persistence 3.2 (jakarta.persistence) / Hibernate 7.4 (org.hibernate) |
| Dependencias | hibernate-core, hibernate-hikaricp, mysql-connector-j, logback-classic |
| Configuración | META-INF/persistence.xml o PersistenceConfiguration (JPA 3.2) |
| Esquema | hibernate.hbm2ddl.auto: validate con BD existente; create-drop en pruebas |
| Ver el SQL | hibernate.show_sql + format_sql, o loggers org.hibernate.SQL y org.hibernate.orm.jdbc.bind |
| Entidad | @Entity, @Table(name), constructor vacío, @Id |
| Identificador | @GeneratedValue(strategy = GenerationType.IDENTITY) en MySQL |
| Columnas | @Column(name, nullable, length, precision, scale, unique) |
| Enumerados | @Enumerated(EnumType.STRING) |
| Fechas | LocalDate, LocalDateTime, Instant (sin @Temporal) |
| No persistente | @Transient |
| Objetos grandes | @Lob (LONGTEXT, LONGBLOB) |
| Conversión a medida | AttributeConverter + @Convert |
| Fábrica | Persistence.createEntityManagerFactory("empresa") (una por aplicación) |
| Unidad de trabajo | emf.createEntityManager() (corta, no compartida entre hilos) |
| Transacciones | em.getTransaction().begin()/commit()/rollback(), emf.runInTransaction(...) |
| CRUD | persist, find, getReference, merge, remove |
| Estados | Nuevo, gestionado, desconectado, eliminado; em.contains(obj) |
| Contexto de persistencia | Caché de primer nivel; un id = un objeto por EntityManager |
| Dirty checking | Modificar un objeto gestionado genera el UPDATE en el flush |
| Flush | em.flush(); modo AUTO (antes de consultas y en commit) o COMMIT |
| Clave compuesta | @EmbeddedId + @Embeddable, o @IdClass + varios @Id |
| Embebible | @Embeddable + @Embedded, @AttributeOverride |