Módulo 16: Consultas y rendimiento
Objetivos del módulo
- Escribir consultas JPQL: sintaxis, parámetros con nombre y posicionales, navegación por relaciones
- Obtener proyecciones como valores,
Object[],Tupley records (DTO) con expresiones de constructor - Usar
JOIN,LEFT JOIN,JOIN ... ONyJOIN FETCH - Resolver informes con agregados,
GROUP BY,HAVINGy subconsultas sobre EMPRESA (ventas por cliente, empleados por departamento, productos más vendidos) - Paginar resultados con
setFirstResultysetMaxResults - Definir consultas con nombre (
@NamedQuery), construir consultas dinámicas con la Criteria API y conocer el metamodelo - Ejecutar SQL nativo y actualizaciones y borrados masivos
- Detectar el problema N+1 contando las consultas reales y resolverlo con
JOIN FETCH,@EntityGraphy batch fetching - Configurar la caché de segundo nivel
- Proteger los datos frente a escrituras concurrentes con bloqueo optimista (
@Version) y pesimista - Medir con las estadísticas de Hibernate y aplicar buenas prácticas de rendimiento
1. Formas de consultar en JPA
En los módulos 14 y 15 solo usamos find() y la navegación por relaciones. Para todo lo demás (filtros, informes, listados) JPA ofrece varias herramientas:
| Herramienta | Cuándo usarla | Ejemplo |
|---|---|---|
em.find(Clase, id) | Una entidad por su clave | em.find(Empleado.class, 121) |
JPQL (createQuery) | La opción por defecto: consultas sobre entidades | select e from Empleado e where e.salario > :min |
@NamedQuery | Consultas fijas que se reutilizan; se validan al arrancar | em.createNamedQuery("Empleado.porOficio") |
| Criteria API | Consultas que se construyen dinámicamente (filtros opcionales) | cb.equal(e.get("oficio"), oficio) |
SQL nativo (createNativeQuery) | Funciones propias de MySQL, consultas recursivas, tuning | WITH RECURSIVE ... |
📘 Concepto: JPQL (Jakarta Persistence Query Language) se parece mucho a SQL, pero trabaja con entidades y atributos, no con tablas y columnas. Hibernate lo traduce al SQL del dialecto de tu base de datos. Hibernate amplía JPQL con su propio lenguaje, HQL, que es un superconjunto: todo JPQL válido es HQL válido.
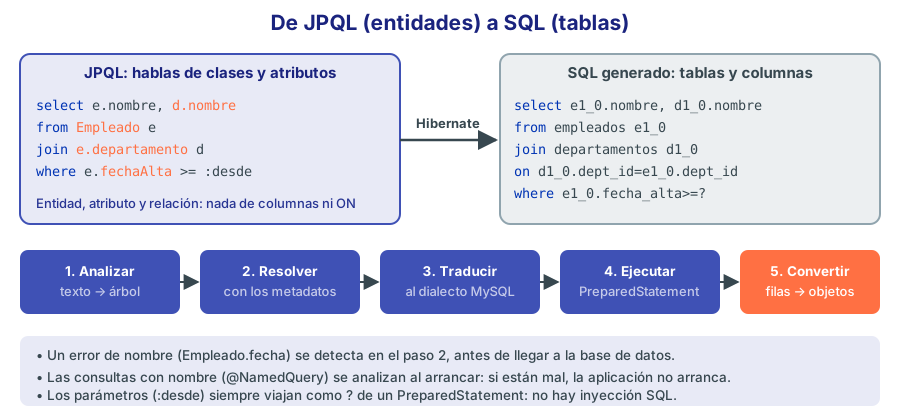
Figura 1. De JPQL (entidades) a SQL (tablas).
1.1 El proyecto de este módulo
Usamos el mismo modelo del módulo 15 (sin las entidades de laboratorio Habilidad y Credencial) con tres cambios:
Producto.categoriapasa a serLAZY(en el módulo 15 la dejamos EAGER a propósito para estudiarla).Productotiene un atributo@Versionpara el bloqueo optimista (sección 14). Necesita una columna nueva; ejecuta este script antes de empezar:
-- Módulo 16: columna para el bloqueo optimista (@Version) en productos
ALTER TABLE productos ADD COLUMN version INT NOT NULL DEFAULT 0;
-- Para dejar EMPRESA como estaba al terminar el módulo:
-- ALTER TABLE productos DROP COLUMN version;
- Se añaden al
pom.xmllas dependencias de la caché de segundo nivel (sección 13).
Los ejemplos omiten las líneas package e import (jakarta.persistence.*, jakarta.persistence.criteria.*, org.hibernate.SessionFactory, org.hibernate.stat.Statistics, java.util.*…). En las salidas de este módulo, cuando una sentencia SQL ya ha aparecido antes completa, se muestra abreviada en una línea (Hibernate: select ... from empleados e1_0 where ...).
2. JPQL: lo básico
public class Ejemplo01Jpql {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            // 1. Parámetros con nombre (:nombre)
            TypedQuery<Empleado> q = em.createQuery("""
                    select e
                    from Empleado e
                    where e.salario >= :minimo and e.oficio <> :excluido
                    order by e.salario desc""", Empleado.class);
            q.setParameter("minimo", new BigDecimal("4000"));
            q.setParameter("excluido", "DIRECTOR GENERAL");
            List<Empleado> directivos = q.getResultList();
            directivos.forEach(e -> System.out.println("  " + e.getNombreCompleto() + " " + e.getSalario()));

            // 2. Parámetros posicionales (?1, ?2) y getSingleResult
            Empleado ana = em.createQuery(
                    "select e from Empleado e where e.email = ?1", Empleado.class)
                    .setParameter(1, "ana.garcia@empresa.es")
                    .getSingleResult();
            System.out.println("Por email: " + ana.getNombreCompleto());

            // 3. Navegación por relaciones con el punto (JOIN implícito)
            List<String> nombres = em.createQuery("""
                    select e.nombre from Empleado e
                    where e.departamento.localidad = :loc
                    order by e.nombre""", String.class)
                    .setParameter("loc", "Valencia")
                    .getResultList();
            System.out.println("Trabajan en Valencia: " + nombres);
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        e1_0.emp_id,
        e1_0.apellidos,
        e1_0.comision,
        e1_0.dept_id,
        e1_0.email,
        e1_0.fecha_alta,
        e1_0.jefe_id,
        e1_0.nombre,
        e1_0.oficio,
        e1_0.salario,
        e1_0.telefono
    from
        empleados e1_0
    where
        e1_0.salario>=?
        and e1_0.oficio<>?
    order by
        e1_0.salario desc
  Marta Sánchez Gil 5000.00
  Luis Martínez Ruiz 4800.00
  Laura Fernández Moreno 4300.00
  Pedro Gómez Díaz 4200.00
  Javier López Navarro 4000.00
Hibernate:
    select
        e1_0.emp_id,
        ...
    from
        empleados e1_0
    where
        e1_0.email=?
Por email: Ana García López
Hibernate:
    select
        e1_0.nombre
    from
        empleados e1_0
    join
        departamentos d1_0
            on d1_0.dept_id=e1_0.dept_id
    where
        d1_0.localidad=?
    order by
        e1_0.nombre
Trabajan en Valencia: [Hugo, Iván, Marta, Pablo, Raquel, Sara]
Fíjate en la tercera consulta: e.departamento.localidad es una navegación por la relación, y Hibernate la convierte en un JOIN (implícito, de tipo inner: los empleados sin departamento quedan fuera).
| Elemento JPQL | Ejemplo | Notas |
|---|---|---|
select / from | select e from Empleado e | e es una variable de identificación (alias) obligatoria |
where | where e.salario between 2000 and 3000 | =, <>, <, >=, between, like, in, is null, is empty, member of |
| Parámetros | :minimo o ?1 | Siempre con setParameter; nunca concatenes valores (inyección) |
order by | order by e.salario desc, e.apellidos | |
| Funciones de texto | upper, lower, concat, length, substring, trim, locate | |
| Funciones numéricas | abs, sqrt, mod, round (JPA 3.1) | |
| Fechas | current_date, local date, extract(year from e.fechaAlta) (JPA 3.1) | |
| Condicionales | case when ... then ... else ... end, coalesce, nullif | |
| Resultado | getResultList(), getSingleResult(), getResultStream() | getSingleResult() lanza NoResultException si no hay filas |
⚠️ Importante:
getSingleResult()lanzaNoResultExceptionsi la consulta no devuelve nada yNonUniqueResultExceptionsi devuelve más de una fila. Para “buscar por email, si existe”, usagetResultStream().findFirst()(devuelve unOptional) o captura la excepción.
💡 Consejo: Escribe las consultas con bloques de texto (
""", Java 15): son mucho más legibles que una cadena concatenada en varias líneas.
3. Proyecciones: solo los datos que necesitas
Cargar entidades completas para mostrar dos columnas es un desperdicio (y además las mete en el contexto de persistencia, con sus instantáneas para el dirty checking). JPQL puede devolver valores sueltos, filas de valores o directamente DTO.
/** Proyección: solo los datos que necesita la pantalla, sin ser una entidad. */
public record EmpleadoResumen(String nombre, String departamento, BigDecimal salario) { }
public class Ejemplo02Proyecciones {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            // 1. Un solo valor escalar
            BigDecimal maximo = em.createQuery("select max(e.salario) from Empleado e", BigDecimal.class)
                    .getSingleResult();
            System.out.println("Salario máximo: " + maximo);

            // 2. Varias columnas como Object[]
            List<Object[]> filas = em.createQuery(
                    "select e.nombre, e.salario from Empleado e where e.oficio = 'ANALISTA'", Object[].class)
                    .getResultList();
            for (Object[] f : filas) System.out.println("  Object[] -> " + f[0] + " " + f[1]);

            // 3. Tuple: columnas con alias
            List<Tuple> tuplas = em.createQuery(
                    "select e.nombre as nombre, e.oficio as oficio from Empleado e where e.salario > 4500",
                    Tuple.class).getResultList();
            for (Tuple t : tuplas) System.out.println("  Tuple -> " + t.get("nombre") + " (" + t.get("oficio") + ")");

            // 4. Expresión de constructor: directamente a un record (DTO)
            List<EmpleadoResumen> resumen = em.createQuery("""
                    select new es.curso.empresa.dto.EmpleadoResumen(
                               concat(e.nombre, ' ', e.apellidos), d.nombre, e.salario)
                    from Empleado e join e.departamento d
                    where d.id = :dep
                    order by e.salario desc""", EmpleadoResumen.class)
                    .setParameter("dep", 20)
                    .getResultList();
            resumen.forEach(r -> System.out.println("  " + r));
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        max(e1_0.salario)
    from
        empleados e1_0
Salario máximo: 6500.00
Hibernate:
    select
        e1_0.nombre,
        e1_0.salario
    from
        empleados e1_0
    where
        e1_0.oficio='ANALISTA'
  Object[] -> Pablo 3500.00
  Object[] -> Álvaro 2700.00
Hibernate:
    select
        e1_0.nombre,
        e1_0.oficio
    from
        empleados e1_0
    where
        e1_0.salario>4500
  Tuple -> Ana (DIRECTOR GENERAL)
  Tuple -> Luis (DIRECTOR)
  Tuple -> Marta (DIRECTOR)
Hibernate:
    select
        concat(e1_0.nombre, ' ', e1_0.apellidos),
        d1_0.nombre,
        e1_0.salario
    from
        empleados e1_0
    join
        departamentos d1_0
            on d1_0.dept_id=e1_0.dept_id
    where
        d1_0.dept_id=?
    order by
        e1_0.salario desc
  EmpleadoResumen[nombre=Luis Martínez Ruiz, departamento=VENTAS, salario=4800.00]
  EmpleadoResumen[nombre=Elena Navarro Castro, departamento=VENTAS, salario=2300.00]
  EmpleadoResumen[nombre=Carmen Ruiz Ortega, departamento=VENTAS, salario=2200.00]
  EmpleadoResumen[nombre=David Torres Romero, departamento=VENTAS, salario=2100.00]
  EmpleadoResumen[nombre=Sergio Jiménez Vidal, departamento=VENTAS, salario=1900.00]
  EmpleadoResumen[nombre=Lucía Romero Serrano, departamento=VENTAS, salario=1700.00]
Observa el SQL de la proyección a record: solo pide las tres columnas necesarias, frente a las once de la entidad completa.
| Tipo de resultado | Ventajas | Inconvenientes |
|---|---|---|
| Entidad | Se puede modificar (dirty checking) | Carga todas las columnas; ocupa el contexto de persistencia |
Escalar / Object[] | Rápido | Acceso por posición (f[0]) propenso a errores |
Tuple | Acceso por alias | Sin tipado fuerte (get devuelve Object salvo que indiques la clase) |
DTO con select new | Tipado, inmutable, solo lo necesario | Hay que escribir la clase completa con su paquete en la consulta |
💡 Consejo: Para leer datos que vas a mostrar o devolver en una API, prefiere DTO (records). Para modificar, carga entidades. Así evitas además la
LazyInitializationException: un record no tiene proxies.
4. JOIN, LEFT JOIN, JOIN ... ON y JOIN FETCH
public class Ejemplo03Joins {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            // 1. LEFT JOIN: departamentos con su número de empleados (también los vacíos)
            System.out.println("--- LEFT JOIN ---");
            List<Object[]> filas = em.createQuery("""
                    select d.nombre, count(e)
                    from Departamento d left join d.empleados e
                    group by d.nombre
                    order by count(e) desc, d.nombre""", Object[].class)
                    .getResultList();
            filas.forEach(f -> System.out.println("  " + f[0] + ": " + f[1]));

            // 2. JOIN con condición sobre la entidad unida
            System.out.println("--- JOIN ... ON ---");
            List<String> conPedidosPendientes = em.createQuery("""
                    select distinct c.nombre
                    from Cliente c join c.pedidos p on p.estado = es.curso.empresa.modelo.EstadoPedido.PENDIENTE
                    order by c.nombre""", String.class)
                    .getResultList();
            System.out.println("  Con pedidos pendientes: " + conPedidosPendientes);

            // 3. JOIN FETCH: trae el pedido Y su cliente Y sus líneas en una sola consulta
            System.out.println("--- JOIN FETCH ---");
            Pedido p = em.createQuery("""
                    select p from Pedido p
                    join fetch p.cliente
                    left join fetch p.lineas l
                    left join fetch l.producto
                    where p.id = :id""", Pedido.class)
                    .setParameter("id", 5004)
                    .getSingleResult();
            System.out.println("  " + p.getCliente().getNombre() + ": " + p.getLineas().size()
                    + " líneas, total " + p.getTotal());
            p.getLineas().forEach(l -> System.out.println("    " + l));
        }
        JpaUtil.cerrar();
    }
}
Salida real (la lista de columnas del JOIN FETCH se ha abreviado):
--- LEFT JOIN ---
Hibernate:
    select
        d1_0.nombre,
        count(e1_0.emp_id)
    from
        departamentos d1_0
    left join
        empleados e1_0
            on d1_0.dept_id=e1_0.dept_id
    group by
        d1_0.nombre
    order by
        count(e1_0.emp_id) desc,
        d1_0.nombre
  INFORMÁTICA: 6
  VENTAS: 6
  LOGÍSTICA: 4
  CONTABILIDAD: 3
  MARKETING: 3
  DIRECCIÓN: 1
  INVESTIGACIÓN: 0
--- JOIN ... ON ---
Hibernate:
    select
        distinct c1_0.nombre
    from
        clientes c1_0
    join
        pedidos p1_0
            on c1_0.cliente_id=p1_0.cliente_id
            and p1_0.estado='PENDIENTE'
    order by
        c1_0.nombre
  Con pedidos pendientes: [Diseños Creativos S.L., Gestoría Delta, Laura Benítez Sanz]
--- JOIN FETCH ---
Hibernate:
    select
        p1_0.pedido_id,
        p1_0.cliente_id,
        c1_0.cliente_id,
        c1_0.ciudad,
        ...
        l1_0.pedido_id,
        l1_0.num_linea,
        ...
        p2_0.producto_id,
        p2_0.nombre,
        ...
    from
        pedidos p1_0
    join
        clientes c1_0
            on c1_0.cliente_id=p1_0.cliente_id
    left join
        lineas_pedido l1_0
            on p1_0.pedido_id=l1_0.pedido_id
    left join
        productos p2_0
            on p2_0.producto_id=l1_0.producto_id
    where
        p1_0.pedido_id=?
    order by
        l1_0.num_linea
  Academia Nova: 3 líneas, total 6232.50
    Linea 1: 5 x Portátil UltraBook 14 = 4270.25
    Linea 2: 5 x Monitor 27 4K = 1562.75
    Linea 3: 5 x Teclado mecánico = 399.50
| Tipo | Qué hace | Resultado |
|---|---|---|
join e.departamento d | Inner join por la relación | Solo los que tienen departamento; d se puede usar en where/select |
left join d.empleados e | Outer join | Incluye los departamentos sin empleados (INVESTIGACIÓN aparece con 0) |
join ... on condición | Añade una condición al ON (JPA 2.1) | Útil con left join para filtrar sin perder filas |
join fetch | Además de unir, carga la relación en las entidades devueltas | La relación queda inicializada: sin consultas extra ni LazyInitializationException |
📘 Concepto: La diferencia clave: un
joinnormal sirve para filtrar o seleccionar datos de la entidad unida, pero no rellena la relación en los objetos devueltos.join fetchsí la rellena. Aquí la consulta ha traído pedido, cliente, líneas y productos en una sentencia, y el@OrderBy("id.numLinea")de la colección se ha convertido enorder by l1_0.num_linea.
⚠️ Importante: No combines
join fetchde una colección con paginación (setMaxResults): como cada fila del resultado SQL es una línea, Hibernate no puede aplicar elLIMITen la base de datos; carga todo y pagina en memoria (y avisa con unWARN). Para listados paginados, pagina la entidad principal y carga las colecciones con batch fetching (sección 12).
5. Agregados y GROUP BY: los informes de EMPRESA
Para los informes necesitamos tres records:
public record EstadisticaDepartamento(String departamento, Long empleados, Double salarioMedio,
                                      BigDecimal salarioMaximo) { }
public record VentasCliente(String cliente, Long pedidos, BigDecimal total) { }
public record ProductoVendido(String producto, Long unidades, BigDecimal importe) { }
⚠️ Importante: Los tipos de los componentes deben coincidir con lo que devuelve cada función:
countdevuelveLong,avgdevuelveDouble, ysum/maxel tipo del atributo (BigDecimalpara importes). Si no coinciden, Hibernate no encuentra el constructor.
public class Ejemplo04Informes {

    // Importe de una línea: cantidad * precio * (1 - descuento / 100)
    static final String IMPORTE = "l.cantidad * l.precioUnitario * (1 - l.descuento / 100)";

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            System.out.println("=== Empleados por departamento ===");
            List<EstadisticaDepartamento> deps = em.createQuery("""
                    select new es.curso.empresa.dto.EstadisticaDepartamento(
                               d.nombre, count(e), avg(e.salario), max(e.salario))
                    from Empleado e join e.departamento d
                    group by d.nombre
                    having count(e) >= 2
                    order by count(e) desc""", EstadisticaDepartamento.class)
                    .getResultList();
            deps.forEach(d -> System.out.printf("  %-13s %2d  media %8.2f  máx %s%n",
                    d.departamento(), d.empleados(), d.salarioMedio(), d.salarioMaximo()));

            System.out.println("=== Ventas por cliente (sin cancelados) ===");
            List<VentasCliente> ventas = em.createQuery("""
                    select new es.curso.empresa.dto.VentasCliente(
                               c.nombre, count(distinct p), sum(%s))
                    from LineaPedido l join l.pedido p join p.cliente c
                    where p.estado <> es.curso.empresa.modelo.EstadoPedido.CANCELADO
                    group by c.nombre
                    order by sum(%s) desc""".formatted(IMPORTE, IMPORTE), VentasCliente.class)
                    .setMaxResults(5)
                    .getResultList();
            ventas.forEach(v -> System.out.printf("  %-28s %2d pedidos %10.2f €%n",
                    v.cliente(), v.pedidos(), v.total()));

            System.out.println("=== Productos más vendidos ===");
            List<ProductoVendido> top = em.createQuery("""
                    select new es.curso.empresa.dto.ProductoVendido(pr.nombre, sum(l.cantidad), sum(%s))
                    from LineaPedido l join l.producto pr
                    group by pr.nombre
                    order by sum(l.cantidad) desc, pr.nombre""".formatted(IMPORTE), ProductoVendido.class)
                    .setMaxResults(5)
                    .getResultList();
            top.forEach(t -> System.out.printf("  %-24s %3d uds %10.2f €%n", t.producto(), t.unidades(), t.importe()));
        }
        JpaUtil.cerrar();
    }
}
Salida real:
=== Empleados por departamento ===
Hibernate:
    select
        d1_0.nombre,
        count(e1_0.emp_id),
        avg(e1_0.salario),
        max(e1_0.salario)
    from
        empleados e1_0
    join
        departamentos d1_0
            on d1_0.dept_id=e1_0.dept_id
    group by
        d1_0.nombre
    having
        count(e1_0.emp_id)>=2
    order by
        count(e1_0.emp_id) desc
  INFORMÁTICA    6  media  3133.33  máx 5000.00
  VENTAS         6  media  2500.00  máx 4800.00
  LOGÍSTICA      4  media  2237.50  máx 4000.00
  CONTABILIDAD   3  media  2816.67  máx 4200.00
  MARKETING      3  media  3100.00  máx 4300.00
=== Ventas por cliente (sin cancelados) ===
Hibernate:
    select
        c1_0.nombre,
        count(distinct p1_0.pedido_id),
        sum(((lp1_0.cantidad*lp1_0.precio_unitario)*(1-(lp1_0.descuento/100))))
    from
        lineas_pedido lp1_0
    join
        pedidos p1_0
            on p1_0.pedido_id=lp1_0.pedido_id
    join
        clientes c1_0
            on c1_0.cliente_id=p1_0.cliente_id
    where
        p1_0.estado<>'CANCELADO'
    group by
        c1_0.nombre
    order by
        sum(((lp1_0.cantidad*lp1_0.precio_unitario)*(1-(lp1_0.descuento/100)))) desc
    limit
        ?
  Instituto Tecnológico Sur     2 pedidos   20602.55 €
  Construcciones Levante S.A.   3 pedidos   14260.19 €
  Academia Nova                 2 pedidos    7891.30 €
  Talleres Martín S.L.          3 pedidos    4704.15 €
  Hotel Mar Azul S.L.           2 pedidos    4202.77 €
=== Productos más vendidos ===
Hibernate:
    select
        p1_0.nombre,
        sum(lp1_0.cantidad),
        sum(((lp1_0.cantidad*lp1_0.precio_unitario)*(1-(lp1_0.descuento/100))))
    from
        lineas_pedido lp1_0
    join
        productos p1_0
            on p1_0.producto_id=lp1_0.producto_id
    group by
        p1_0.nombre
    order by
        sum(lp1_0.cantidad) desc,
        p1_0.nombre
    limit
        ?
  Monitor 24 FHD            40 uds    4934.50 €
  Pack teclado y ratón      30 uds     897.00 €
  Portátil Básico 15        24 uds   10479.00 €
  Portátil UltraBook 14     15 uds   12361.25 €
  Teclado mecánico          15 uds    1166.54 €
Son las mismas consultas que escribirías en SQL (módulos de JDBC y Curso de Bases de Datos), pero expresadas sobre el modelo de objetos: l.pedido.cliente en lugar de dos JOIN ... ON con claves ajenas. Y setMaxResults(5) se traduce en el LIMIT de MySQL. Los resultados no son entidades, así que no ocupan el contexto de persistencia.
6. Subconsultas y funciones
public class Ejemplo05Subconsultas {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            // 1. Subconsulta escalar: ganan más que la media de SU departamento (correlacionada)
            List<String> sobreMedia = em.createQuery("""
                    select concat(e.nombre, ' (', e.departamento.nombre, ')')
                    from Empleado e
                    where e.salario > (select avg(e2.salario) from Empleado e2
                                       where e2.departamento = e.departamento)
                    order by e.departamento.nombre, e.nombre""", String.class)
                    .getResultList();
            System.out.println("Por encima de la media de su departamento: " + sobreMedia);

            // 2. NOT EXISTS: clientes que nunca han hecho un pedido
            List<String> sinPedidos = em.createQuery("""
                    select c.nombre from Cliente c
                    where not exists (select p from Pedido p where p.cliente = c)""", String.class)
                    .getResultList();
            System.out.println("Clientes sin pedidos: " + sinPedidos);

            // 3. NOT IN: productos que nunca se han vendido
            List<String> sinVentas = em.createQuery("""
                    select pr.nombre from Producto pr
                    where pr.id not in (select l.producto.id from LineaPedido l)""", String.class)
                    .getResultList();
            System.out.println("Productos sin ventas: " + sinVentas);

            // 4. Funciones: extract (JPA 3.1), upper, length, coalesce
            List<Object[]> altas = em.createQuery("""
                    select extract(year from e.fechaAlta), count(e)
                    from Empleado e
                    where extract(year from e.fechaAlta) >= 2020
                    group by extract(year from e.fechaAlta)
                    order by 1""", Object[].class)
                    .getResultList();
            altas.forEach(a -> System.out.println("Altas en " + a[0] + ": " + a[1]));
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        concat(e1_0.nombre, ' (', d1_0.nombre, ')')
    from
        empleados e1_0
    join
        departamentos d1_0
            on d1_0.dept_id=e1_0.dept_id
    where
        e1_0.salario>(
            select
                avg(e2_0.salario)
            from
                empleados e2_0
            where
                e2_0.dept_id=e1_0.dept_id
        )
    order by
        d1_0.nombre,
        e1_0.nombre
Por encima de la media de su departamento: [Pedro (CONTABILIDAD), Marta (INFORMÁTICA), Pablo (INFORMÁTICA), Javier (LOGÍSTICA), Laura (MARKETING), Luis (VENTAS)]
Hibernate:
    select
        c1_0.nombre
    from
        clientes c1_0
    where
        not exists(select
            p1_0.pedido_id from pedidos p1_0
        where
            p1_0.cliente_id=c1_0.cliente_id)
Clientes sin pedidos: [Carlos Ibáñez Rey, Farmacia Central]
Hibernate:
    select
        p1_0.nombre
    from
        productos p1_0
    where
        p1_0.producto_id not in (select
            lp1_0.producto_id from lineas_pedido lp1_0)
Productos sin ventas: [Altavoz Inteligente]
Hibernate:
    select
        year(e1_0.fecha_alta),
        count(e1_0.emp_id)
    from
        empleados e1_0
    where
        year(e1_0.fecha_alta)>=2020
    group by
        year(e1_0.fecha_alta)
    order by
        1
Altas en 2020: 2
Altas en 2021: 2
Altas en 2022: 2
Altas en 2023: 1
Altas en 2025: 1
La función estándar extract(year from ...) se ha traducido a la función year() de MySQL: esa es la ventaja de escribir en JPQL y dejar que el dialecto haga el resto. Comparar entidades (e2.departamento = e.departamento, p.cliente = c) se traduce en comparar sus claves.
💡 Consejo: Las subconsultas en JPQL pueden ir en
whereyhaving(y enselectyfromcon Hibernate 6+). Conexists,in,all,anyysomecubres prácticamente todos los casos del SQL que ya conoces.
7. Paginación
public class Ejemplo06Paginacion {

    static List<Empleado> pagina(EntityManager em, int numPagina, int tamano) {
        return em.createQuery("select e from Empleado e order by e.apellidos, e.id", Empleado.class)
                .setFirstResult(numPagina * tamano)    // filas que se saltan (OFFSET)
                .setMaxResults(tamano)                 // filas que se devuelven (LIMIT)
                .getResultList();
    }

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            long total = em.createQuery("select count(e) from Empleado e", Long.class).getSingleResult();
            int tamano = 10;
            long paginas = (total + tamano - 1) / tamano;
            System.out.println(total + " empleados en " + paginas + " páginas");

            List<Empleado> tercera = pagina(em, 2, tamano);       // páginas numeradas desde 0
            System.out.println("Página 3: ");
            tercera.forEach(e -> System.out.println("  " + e.getApellidos() + ", " + e.getNombre()));
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        count(e1_0.emp_id)
    from
        empleados e1_0
24 empleados en 3 páginas
Hibernate:
    select
        e1_0.emp_id,
        ...
    from
        empleados e1_0
    order by
        e1_0.apellidos,
        e1_0.emp_id
    limit
        ?, ?
Página 3:
  Ruiz Ortega, Carmen
  Sánchez Gil, Marta
  Torres Romero, David
  Vázquez Ramos, Jorge
⚠️ Importante: Ordena siempre al paginar, y por un criterio único (aquí apellidos y, en caso de empate, id). Sin
order by, la base de datos puede devolver las filas en cualquier orden y un mismo empleado podría aparecer en dos páginas o en ninguna. En Spring Data JPA (módulo 19) la paginación se simplifica conPageableyPage, pero por debajo es exactamente esto.
8. Consultas con nombre: @NamedQuery
Las consultas que se usan en varios sitios pueden declararse en la entidad con un nombre:
@Entity
@Table(name = "empleados")
@NamedQuery(name = "Empleado.porOficio",
        query = "select e from Empleado e where e.oficio = :oficio order by e.salario desc")
@NamedQuery(name = "Empleado.contarPorDepartamento",
        query = "select count(e) from Empleado e where e.departamento.id = :deptId")
public class Empleado { /* ... */ }
public class Ejemplo07NamedQuery {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.createNamedQuery("Empleado.porOficio", Empleado.class)
                    .setParameter("oficio", "VENDEDOR")
                    .getResultList()
                    .forEach(e -> System.out.println("  " + e.getNombreCompleto() + " " + e.getSalario()));

            Long n = em.createNamedQuery("Empleado.contarPorDepartamento", Long.class)
                    .setParameter("deptId", 60)
                    .getSingleResult();
            System.out.println("Empleados de LOGÍSTICA: " + n);
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        e1_0.emp_id,
        ...
    from
        empleados e1_0
    where
        e1_0.oficio=?
    order by
        e1_0.salario desc
  Elena Navarro Castro 2300.00
  Carmen Ruiz Ortega 2200.00
  David Torres Romero 2100.00
  Sergio Jiménez Vidal 1900.00
Hibernate:
    select
        count(e1_0.emp_id)
    from
        empleados e1_0
    where
        e1_0.dept_id=?
Empleados de LOGÍSTICA: 4
Hibernate analiza las consultas con nombre al arrancar: si una tiene un error (un atributo mal escrito), la aplicación no llega a iniciarse. Además, e.departamento.id se traduce directamente en la columna dept_id, sin JOIN: Hibernate sabe que el id del departamento ya está en empleados.
💡 Consejo: Usa el convenio
Entidad.descripcionpara los nombres. En Spring Data JPA, una@NamedQueryllamadaEmpleado.porOficiose asocia automáticamente al métodoporOficiodel repositorio.
9. Criteria API: consultas dinámicas
¿Cómo escribirías un buscador de empleados con filtros opcionales (oficio, salario mínimo, localidad)? Concatenando trozos de JPQL según los filtros que vengan rellenos… algo frágil y propenso a errores. La Criteria API construye la consulta con objetos Java:
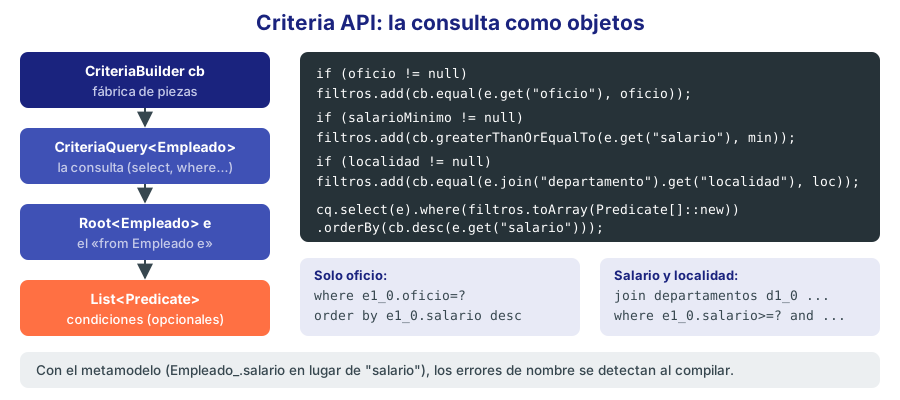
Figura 2. Construcción de una consulta con la Criteria API.
public class Ejemplo08Criteria {

    /** Búsqueda con filtros OPCIONALES: solo se añaden los que no son null. */
    static List<Empleado> buscar(EntityManager em, String oficio, BigDecimal salarioMinimo, String localidad) {
        CriteriaBuilder cb = em.getCriteriaBuilder();
        CriteriaQuery<Empleado> cq = cb.createQuery(Empleado.class);
        Root<Empleado> e = cq.from(Empleado.class);                          // from Empleado e

        List<Predicate> filtros = new ArrayList<>();
        if (oficio != null) {
            filtros.add(cb.equal(e.get("oficio"), oficio));                  // e.oficio = ?
        }
        if (salarioMinimo != null) {
            filtros.add(cb.greaterThanOrEqualTo(e.get("salario"), salarioMinimo));
        }
        if (localidad != null) {
            Join<Empleado, Departamento> d = e.join("departamento");          // join e.departamento d
            filtros.add(cb.equal(d.get("localidad"), localidad));
        }
        cq.select(e)
          .where(filtros.toArray(Predicate[]::new))
          .orderBy(cb.desc(e.get("salario")));
        return em.createQuery(cq).getResultList();
    }

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            System.out.println("--- Solo oficio ---");
            buscar(em, "PROGRAMADOR", null, null)
                    .forEach(x -> System.out.println("  " + x.getNombreCompleto()));
            System.out.println("--- Salario mínimo y localidad ---");
            buscar(em, null, new BigDecimal("2500"), "Valencia")
                    .forEach(x -> System.out.println("  " + x.getNombreCompleto() + " " + x.getSalario()));
        }
        JpaUtil.cerrar();
    }
}
Salida real:
--- Solo oficio ---
Hibernate: select ... from empleados e1_0 where e1_0.oficio=? order by e1_0.salario desc
  Raquel Molina Prieto
  Iván Castro Méndez
  Sara Ortiz Delgado
--- Salario mínimo y localidad ---
Hibernate:
    select
        e1_0.emp_id,
        ...
    from
        empleados e1_0
    join
        departamentos d1_0
            on d1_0.dept_id=e1_0.dept_id
    where
        e1_0.salario>=?
        and d1_0.localidad=?
    order by
        e1_0.salario desc
  Marta Sánchez Gil 5000.00
  Pablo Moreno Herrera 3500.00
  Raquel Molina Prieto 2800.00
  Iván Castro Méndez 2600.00
  Hugo Rubio Marín 2500.00
La primera búsqueda genera exactamente el mismo SQL que la @NamedQuery de la sección anterior. La segunda solo añade el JOIN porque se pidió un filtro por localidad.
9.1 El metamodelo: Criteria sin cadenas
e.get("salario") tiene un punto débil: si te equivocas en el nombre, el error aparece al ejecutar. El metamodelo estático de JPA son unas clases generadas al compilar (Empleado_, Departamento_…) con un atributo por cada atributo de la entidad, de modo que escribes e.get(Empleado_.salario) y el compilador comprueba el nombre y el tipo. Con Hibernate las genera el procesador de anotaciones hibernate-processor:
<plugin>
    <groupId>org.apache.maven.plugins</groupId>
    <artifactId>maven-compiler-plugin</artifactId>
    <version>3.16.0</version>
    <configuration>
        <annotationProcessorPaths>
            <path>
                <groupId>org.hibernate.orm</groupId>
                <artifactId>hibernate-processor</artifactId>
                <version>${hibernate.version}</version>
            </path>
        </annotationProcessorPaths>
    </configuration>
</plugin>
| JPQL | Criteria API | |
|---|---|---|
| Legibilidad | Alta: parece SQL | Baja: mucho código |
| Consultas dinámicas | Concatenando cadenas (frágil) | Natural |
| Errores de nombre | Al ejecutar (o al arrancar, con @NamedQuery) | Al compilar, con el metamodelo |
| Uso típico | La mayoría de consultas | Buscadores con filtros opcionales |
10. SQL nativo
Cuando necesitas algo propio de MySQL que JPQL no expresa (consultas recursivas, funciones de ventana específicas, hints del optimizador…), puedes escribir SQL directamente:
public class Ejemplo09Nativa {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            // 1. SQL nativo que devuelve entidades
            List<Producto> sinStock = em.createNativeQuery(
                    "SELECT * FROM productos WHERE stock = 0 ORDER BY nombre", Producto.class)
                    .getResultList();
            sinStock.forEach(p -> System.out.println("Sin stock: " + p.getNombre()));

            // 2. SQL propio de MySQL: consulta recursiva (WITH RECURSIVE) sobre el árbol de categorías
            @SuppressWarnings("unchecked")
            List<Object[]> arbol = em.createNativeQuery("""
                    WITH RECURSIVE arbol (categoria_id, nombre, nivel, ruta) AS (
                        SELECT categoria_id, nombre, 0, CAST(nombre AS CHAR(200))
                        FROM categorias WHERE categoria_padre_id IS NULL
                        UNION ALL
                        SELECT c.categoria_id, c.nombre, a.nivel + 1, CONCAT(a.ruta, ' > ', c.nombre)
                        FROM categorias c JOIN arbol a ON c.categoria_padre_id = a.categoria_id
                    )
                    SELECT nivel, ruta FROM arbol WHERE nivel = 2 ORDER BY ruta""")
                    .getResultList();
            arbol.forEach(f -> System.out.println("Nivel " + f[0] + ": " + f[1]));

            // 3. Parámetros en SQL nativo
            Number total = (Number) em.createNativeQuery(
                    "SELECT COUNT(*) FROM pedidos WHERE YEAR(fecha_pedido) = ?1")
                    .setParameter(1, 2026)
                    .getSingleResult();
            System.out.println("Pedidos de 2026: " + total);
        }
        JpaUtil.cerrar();
    }
}
Salida real (el formateador de Hibernate parte de forma curiosa la consulta recursiva, pero es exactamente el texto que escribimos):
Hibernate:
    SELECT
        *
    FROM
        productos
    WHERE
        stock = 0
    ORDER BY
        nombre
Sin stock: Altavoz Inteligente
Sin stock: Pack teclado y ratón
Hibernate:
    WITH RECURSIVE arbol (categoria_id, nombre, nivel, ruta) AS (     SELECT
        categoria_id, nombre, 0, CAST(nombre AS CHAR(200))     FROM categorias
    WHERE
        categoria_padre_id IS NULL
    UNION
    ALL     SELECT
        c.categoria_id, c.nombre, a.nivel + 1, CONCAT(a.ruta, ' > ', c.nombre)     FROM categorias c
    JOIN
        arbol a
            ON c.categoria_padre_id = a.categoria_id ) SELECT
            nivel,
            ruta
    FROM
        arbol
    WHERE
        nivel = 2
    ORDER BY
        ruta
Nivel 2: Informática > Periféricos > Monitores
Nivel 2: Informática > Periféricos > Ratones y teclados
Hibernate:
    SELECT
        COUNT(*)
    FROM
        pedidos
    WHERE
        YEAR(fecha_pedido) = ?
Pedidos de 2026: 9
⚠️ Importante: El SQL nativo ata tu código a MySQL y Hibernate no lo valida: los errores aparecen al ejecutar. Úsalo solo cuando JPQL no llegue. Y aunque devuelva entidades, ten en cuenta que antes de ejecutarlo Hibernate hace flush de todo lo pendiente, porque no puede saber qué tablas lee tu SQL.
11. Actualizaciones y borrados masivos
Para cambiar muchas filas, cargar cada entidad y modificarla generaría un SELECT y un UPDATE por fila. JPQL permite update y delete masivos, que se ejecutan con una sola sentencia:
public class Ejemplo10Masivas {

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            em.getTransaction().begin();
            Producto raton = em.find(Producto.class, 6);
            System.out.println("Antes: " + raton);

            // UPDATE masivo: una sola sentencia para muchas filas, sin cargar entidades
            int n = em.createQuery("""
                    update Producto p set p.precio = p.precio * 1.10
                    where p.categoria.id = :cat""")
                    .setParameter("cat", 5)
                    .executeUpdate();
            System.out.println("Filas actualizadas: " + n);

            // ¡El contexto de persistencia NO se entera!
            System.out.println("En memoria: " + raton);
            em.refresh(raton);                         // relee la fila de la base de datos
            System.out.println("Tras refresh: " + raton);

            em.getTransaction().rollback();            // deshacemos para no tocar EMPRESA
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        p1_0.producto_id,
        p1_0.categoria_id,
        ...
        p1_0.version
    from
        productos p1_0
    where
        p1_0.producto_id=?
Antes: Producto[6, Ratón inalámbrico, precio=19.90, stock=200, v0]
Hibernate:
    update
        productos p1_0
    set
        precio=(p1_0.precio*1.10)
    where
        p1_0.categoria_id=?
Filas actualizadas: 3
En memoria: Producto[6, Ratón inalámbrico, precio=19.90, stock=200, v0]
Hibernate: select ... from productos p1_0 where p1_0.producto_id=?
Tras refresh: Producto[6, Ratón inalámbrico, precio=21.89, stock=200, v0]
Tres conclusiones:
- Un solo
UPDATEha cambiado los tres productos de la categoría “Ratones y teclados”. - El objeto
ratonque ya estaba en memoria sigue con el precio antiguo: las operaciones masivas van directas a la base de datos y se saltan el contexto de persistencia (y el dirty checking, los callbacks y las cascadas). Hay que releer conrefresh, o hacerem.clear(). - La versión no ha cambiado (
v0): una actualización masiva JPQL no incrementa@Version. Si lo necesitas, en HQL existeupdate versioned Producto ..., o inclúyelo a mano:set p.version = p.version + 1.
Un borrado masivo es igual de sencillo: em.createQuery("delete from Asignacion a where a.horas = 0").executeUpdate().
⚠️ Importante: Ejecuta las operaciones masivas al principio de la transacción o seguidas de
em.clear(), para no mezclar objetos en memoria desactualizados con los datos reales. Y recuerda quedeletemasivo no aplicaCascadeType.REMOVEniorphanRemoval: solo las restriccionesON DELETE CASCADEde la base de datos.
12. El problema N+1
📘 Concepto: El problema N+1 ocurre cuando una consulta devuelve N entidades (1 consulta) y luego, al recorrerlas, el acceso a una relación perezosa de cada una dispara una consulta más (N consultas). Es el problema de rendimiento más frecuente con cualquier ORM.
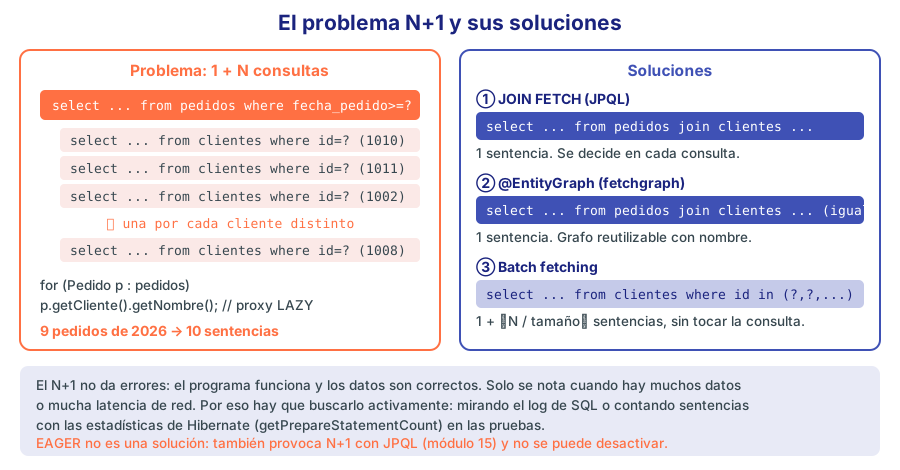
Figura 3. El problema N+1 y sus tres soluciones.
Para demostrarlo contamos las sentencias reales con las estadísticas de Hibernate (sección 16) y quitamos format_sql para que cada sentencia ocupe una línea. Para el entity graph declaramos uno con nombre en Pedido:
@Entity
@Table(name = "pedidos")
@NamedEntityGraph(name = "Pedido.conCliente",
        attributeNodes = @NamedAttributeNode("cliente"))
public class Pedido { /* ... */ }
public class Ejemplo11NMasUno {

    static final LocalDate DESDE = LocalDate.of(2026, 1, 1);

    static void listar(List<Pedido> pedidos) {
        for (Pedido p : pedidos) {
            System.out.println("  " + p.getId() + " " + p.getCliente().getNombre());   // ¡acceso LAZY!
        }
    }

    static void probar(EntityManagerFactory emf, String titulo, String jpql, String grafo) {
        Statistics stats = emf.unwrap(SessionFactory.class).getStatistics();
        stats.clear();
        System.out.println("===== " + titulo + " =====");
        try (EntityManager em = emf.createEntityManager()) {
            var q = em.createQuery(jpql, Pedido.class).setParameter("desde", DESDE);
            if (grafo != null) {
                q.setHint("jakarta.persistence.fetchgraph", em.getEntityGraph(grafo));
            }
            listar(q.getResultList());
        }
        System.out.println("  >> Sentencias SQL ejecutadas: " + stats.getPrepareStatementCount());
    }

    public static void main(String[] args) {
        Map<String, Object> props = Map.of(
                "hibernate.format_sql", "false",              // una línea por sentencia
                "hibernate.generate_statistics", "true");      // para contar las sentencias
        String jpql = "select p from Pedido p where p.fechaPedido >= :desde order by p.id";

        try (EntityManagerFactory emf = Persistence.createEntityManagerFactory("empresa", props)) {
            probar(emf, "1. Problema N+1", jpql, null);
            probar(emf, "2. JOIN FETCH",
                    "select p from Pedido p join fetch p.cliente where p.fechaPedido >= :desde order by p.id", null);
            probar(emf, "3. @NamedEntityGraph", jpql, "Pedido.conCliente");
        }

        // 4. Batch fetching: los proxies se inicializan en bloques con IN (...)
        Map<String, Object> batch = Map.of(
                "hibernate.format_sql", "false",
                "hibernate.generate_statistics", "true",
                "hibernate.default_batch_fetch_size", "10");
        try (EntityManagerFactory emf = Persistence.createEntityManagerFactory("empresa", batch)) {
            probar(emf, "4. Batch fetching (default_batch_fetch_size = 10)", jpql, null);
        }
    }
}
Salida real (las listas de columnas de cada select se han sustituido por ...):
===== 1. Problema N+1 =====
Hibernate: select p1_0.pedido_id,... from pedidos p1_0 where p1_0.fecha_pedido>=? order by p1_0.pedido_id
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5016 Instituto Tecnológico Sur
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5017 Panadería La Espiga
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5018 Construcciones Levante S.A.
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5019 Clínica Dental Sonrisa
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5020 Hotel Mar Azul S.L.
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5021 Talleres Martín S.L.
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5022 Diseños Creativos S.L.
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5023 Laura Benítez Sanz
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id=?
  5024 Gestoría Delta
  >> Sentencias SQL ejecutadas: 10
===== 2. JOIN FETCH =====
Hibernate: select p1_0.pedido_id,p1_0.cliente_id,c1_0.cliente_id,c1_0.ciudad,...,p1_0.fecha_pedido from pedidos p1_0 join clientes c1_0 on c1_0.cliente_id=p1_0.cliente_id where p1_0.fecha_pedido>=? order by p1_0.pedido_id
  5016 Instituto Tecnológico Sur
  (... los 9 pedidos ...)
  5024 Gestoría Delta
  >> Sentencias SQL ejecutadas: 1
===== 3. @NamedEntityGraph =====
Hibernate: select p1_0.pedido_id,p1_0.cliente_id,c1_0.cliente_id,c1_0.ciudad,...,p1_0.fecha_pedido from pedidos p1_0 join clientes c1_0 on c1_0.cliente_id=p1_0.cliente_id where p1_0.fecha_pedido>=? order by p1_0.pedido_id
  5016 Instituto Tecnológico Sur
  (... los 9 pedidos ...)
  >> Sentencias SQL ejecutadas: 1
===== 4. Batch fetching (default_batch_fetch_size = 10) =====
Hibernate: select p1_0.pedido_id,... from pedidos p1_0 where p1_0.fecha_pedido>=? order by p1_0.pedido_id
Hibernate: select c1_0.cliente_id,... from clientes c1_0 where c1_0.cliente_id in (?,?,?,?,?,?,?,?,?,?)
  5016 Instituto Tecnológico Sur
  (... los 9 pedidos ...)
  >> Sentencias SQL ejecutadas: 2
- N+1: 1 consulta de pedidos + 9 de clientes (los 9 pedidos de 2026 son de 9 clientes distintos; si se repitiera alguno, el contexto de persistencia evitaría su segunda consulta). Con 10 000 pedidos serían 10 001 viajes a la base de datos.
JOIN FETCH: una sola sentencia. Hay que escribirlo en cada consulta que lo necesite.@NamedEntityGraph+ la pistajakarta.persistence.fetchgraph: el mismo SQL que elJOIN FETCH, pero el grafo se define una vez y se aplica a cualquier consulta (o afind, pasando el grafo en el mapa de propiedades). Spring Data JPA lo usa con la anotación@EntityGraphen los métodos del repositorio.- Batch fetching: la consulta original no cambia; cuando se accede al primer proxy, Hibernate inicializa de golpe hasta 10 proxies pendientes con un
IN (...). Fíjate en que rellena la lista hasta 10 parámetros aunque solo haya 9 ids, para reutilizar la misma sentencia preparada. Se configura globalmente conhibernate.default_batch_fetch_sizeo por relación con la anotación de Hibernate@BatchSize(size = 10).
| Solución | SQL | Cuándo usarla |
|---|---|---|
join fetch | 1 consulta con JOIN | Cuando una consulta concreta siempre necesita la relación |
@EntityGraph / fetchgraph | 1 consulta con JOIN | El mismo grafo en varias consultas; Spring Data |
| Batch fetching | 1 + ⌈N / tamaño⌉ consultas | Colecciones, listados paginados, cuando no controlas las consultas |
| Proyección a DTO | 1 consulta, solo columnas necesarias | Listados de solo lectura (lo más eficiente) |
⚠️ Importante: No intentes
join fetchde dos colecciones a la vez (por ejemplo,Departamento.empleadosyDepartamento.proyectos): el resultado sería un producto cartesiano y, conList, Hibernate lanzaMultipleBagFetchException. Haz fetch de una y usa batch fetching (o una segunda consulta) para la otra.
13. La caché de segundo nivel
La caché de primer nivel (módulo 14) vive dentro de cada EntityManager. La caché de segundo nivel (L2) es compartida por todos los EntityManager de la EntityManagerFactory: si un usuario ya cargó el departamento 10, el siguiente no necesita ir a la base de datos.
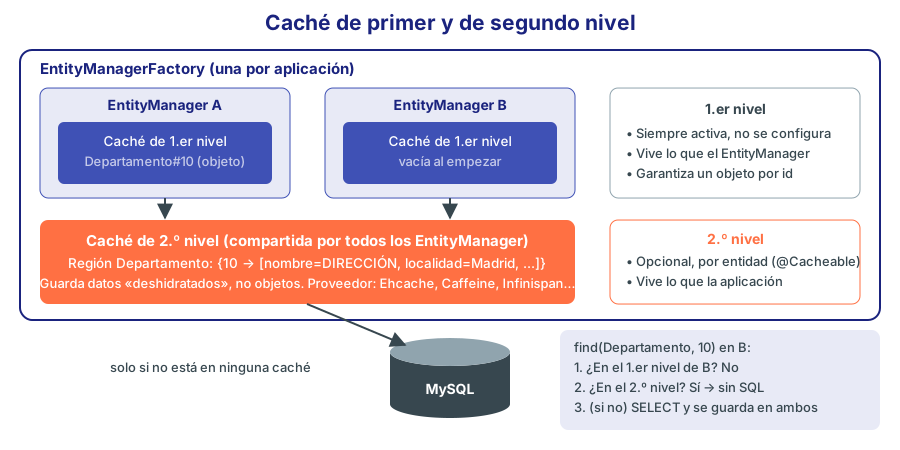
Figura 4. Cachés de primer y segundo nivel.
13.1 Configuración
Hibernate no implementa la caché: se integra con un proveedor a través del estándar JCache (JSR-107). Usaremos Ehcache 3:
<!-- Caché de segundo nivel: integración JCache + proveedor Ehcache 3 -->
<dependency>
    <groupId>org.hibernate.orm</groupId>
    <artifactId>hibernate-jcache</artifactId>
    <version>${hibernate.version}</version>
</dependency>
<dependency>
    <groupId>org.ehcache</groupId>
    <artifactId>ehcache</artifactId>
    <version>3.12.0</version>
    <classifier>jakarta</classifier>
    <exclusions>
        <!-- trae una versión antigua (javax) de JAXB; Hibernate ya incluye la de Jakarta -->
        <exclusion>
            <groupId>org.glassfish.jaxb</groupId>
            <artifactId>jaxb-runtime</artifactId>
        </exclusion>
    </exclusions>
</dependency>
⚠️ Importante: Usa el clasificador
jakartade Ehcache y la exclusión dejaxb-runtime: sin ellos, Maven intenta descargar artefactosjavaxantiguos de repositorios que ya no existen y la compilación falla con Could not collect dependencies … javax.xml.bind:jaxb-api.
En persistence.xml creamos una unidad empresa-cache (igual que empresa, con estas propiedades), y en la unidad normal desactivamos la caché explícitamente, porque con hibernate-jcache en el classpath Hibernate la activaría sola:
<persistence-unit name="empresa-cache" transaction-type="RESOURCE_LOCAL">
    <!-- ... las mismas <class> ... -->
    <shared-cache-mode>ENABLE_SELECTIVE</shared-cache-mode>
    <properties>
        <!-- ... conexión como siempre ... -->
        <property name="hibernate.cache.use_second_level_cache" value="true"/>
        <property name="hibernate.cache.region.factory_class" value="jcache"/>
        <property name="hibernate.javax.cache.provider" value="org.ehcache.jsr107.EhcacheCachingProvider"/>
        <property name="hibernate.javax.cache.missing_cache_strategy" value="create"/>
        <property name="hibernate.generate_statistics" value="true"/>
    </properties>
</persistence-unit>

<!-- en la unidad "empresa": -->
<property name="hibernate.cache.use_second_level_cache" value="false"/>
Con ENABLE_SELECTIVE, solo se cachean las entidades marcadas con @Cacheable. Elegimos Departamento, que cambia muy poco:
@Entity
@Table(name = "departamentos")
@Cacheable                                      // candidata a la caché de segundo nivel
@org.hibernate.annotations.Cache(usage = org.hibernate.annotations.CacheConcurrencyStrategy.READ_WRITE)
public class Departamento { /* ... */ }
13.2 La caché en acción
public class Ejemplo12CacheSegundoNivel {

    public static void main(String[] args) {
        try (EntityManagerFactory emf = Persistence.createEntityManagerFactory("empresa-cache")) {
            Statistics stats = emf.unwrap(SessionFactory.class).getStatistics();

            System.out.println("--- EntityManager 1 ---");
            emf.runInTransaction(em -> System.out.println(em.find(Departamento.class, 10)));
            System.out.println("--- EntityManager 2 (otro contexto de persistencia) ---");
            emf.runInTransaction(em -> System.out.println(em.find(Departamento.class, 10)));

            System.out.println("Aciertos L2: " + stats.getSecondLevelCacheHitCount()
                    + ", fallos: " + stats.getSecondLevelCacheMissCount()
                    + ", guardados: " + stats.getSecondLevelCachePutCount());
            System.out.println("¿Está en caché? " + emf.getCache().contains(Departamento.class, 10));

            emf.getCache().evict(Departamento.class);       // vaciamos la región de Departamento
            System.out.println("--- EntityManager 3 (tras evict) ---");
            emf.runInTransaction(em -> System.out.println(em.find(Departamento.class, 10)));
        }
    }
}
Salida real:
WARNING: A terminally deprecated method in sun.misc.Unsafe has been called
WARNING: sun.misc.Unsafe::objectFieldOffset has been called by org.ehcache.impl.internal.concurrent.ThreadLocalRandomUtil (file:/root/.m2/repository/org/ehcache/ehcache/3.12.0/ehcache-3.12.0-jakarta.jar)
WARNING: Please consider reporting this to the maintainers of class org.ehcache.impl.internal.concurrent.ThreadLocalRandomUtil
WARNING: sun.misc.Unsafe::objectFieldOffset will be removed in a future release
--- EntityManager 1 ---
Hibernate:
    select
        d1_0.dept_id,
        d1_0.localidad,
        d1_0.nombre,
        d1_0.presupuesto
    from
        departamentos d1_0
    where
        d1_0.dept_id=?
Departamento[10, DIRECCIÓN]
--- EntityManager 2 (otro contexto de persistencia) ---
Departamento[10, DIRECCIÓN]
Aciertos L2: 1, fallos: 1, guardados: 1
¿Está en caché? true
--- EntityManager 3 (tras evict) ---
Hibernate: select ... from departamentos d1_0 where d1_0.dept_id=?
Departamento[10, DIRECCIÓN]
El segundo EntityManager no ha ejecutado ningún SQL: el departamento ha salido de la caché compartida (1 acierto). Tras vaciarla con evict, vuelve a consultar. Las cuatro líneas WARNING iniciales las escribe la JVM (desde Java 24 avisa cuando una biblioteca usa métodos de sun.misc.Unsafe que se van a eliminar); no afectan al funcionamiento, pero indican que esa versión de Ehcache aún no está adaptada.
| Estrategia de concurrencia | Uso |
|---|---|
READ_ONLY | Datos que nunca cambian (catálogos fijos): la más rápida |
NONSTRICT_READ_WRITE | Cambian poco y se toleran lecturas ligeramente obsoletas |
READ_WRITE | Cambian a veces y se necesita coherencia (usa bloqueos ligeros) |
TRANSACTIONAL | Solo con proveedores transaccionales (JTA) |
⚠️ Importante: La caché L2 no es “gratis”: consume memoria, puede servir datos obsoletos si otra aplicación modifica la base de datos directamente (Hibernate no se entera) y en un despliegue con varios servidores hace falta una caché distribuida. Úsala solo para entidades muy leídas y poco modificadas (departamentos, categorías, provincias…), y mide antes y después. Existe también una caché de consultas (
hibernate.cache.use_query_cache+ la pistaorg.hibernate.cacheableen la consulta) que guarda los ids que devuelve una consulta; úsala con aún más cuidado.
14. Bloqueo optimista con @Version
Dos empleados de almacén abren a la vez la ficha del portátil UltraBook (stock 25). El primero vende 1 unidad y guarda (24). El segundo, que sigue viendo 25, vende 2 y guarda 23. Resultado: se ha perdido la venta del primero. Es el problema de la actualización perdida (lost update).
📘 Concepto: El bloqueo optimista supone que los conflictos son raros y no bloquea nada al leer. Cada fila tiene un número de versión; al guardar, Hibernate comprueba que la versión sigue siendo la que leyó (
... where id = ? and version = ?) y la incrementa. Si otro la cambió entretanto, elUPDATEno afecta a ninguna fila y Hibernate lanzaOptimisticLockException.
@Entity
@Table(name = "productos")
public class Producto {
    // ... resto de atributos (ahora con @ManyToOne(fetch = LAZY) categoria)

    @Version                          // bloqueo optimista (columna añadida con el script de la sección 1)
    private Integer version;
}
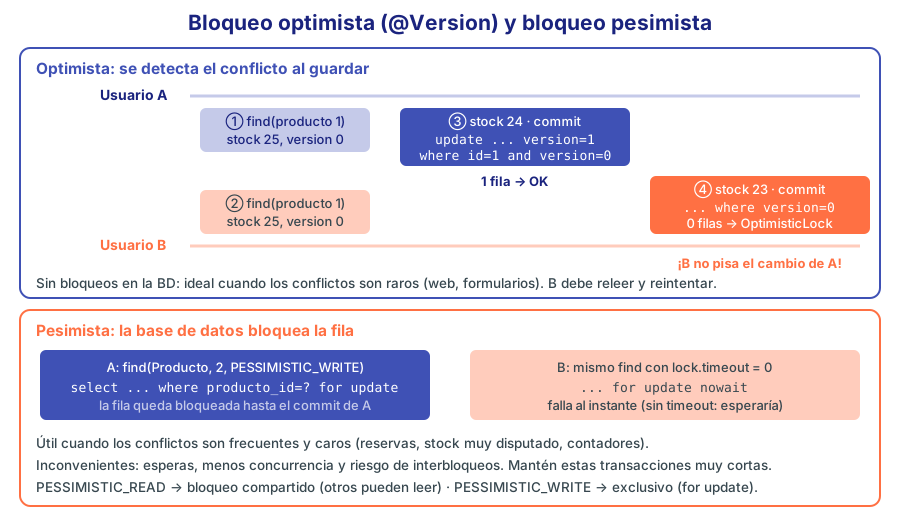
Figura 5. Bloqueo optimista (arriba) y pesimista (abajo).
public class Ejemplo13Optimista {

    public static void main(String[] args) {
        try (EntityManager em1 = JpaUtil.crearEntityManager();     // usuario A
             EntityManager em2 = JpaUtil.crearEntityManager()) {   // usuario B

            em1.getTransaction().begin();
            em2.getTransaction().begin();
            Producto pA = em1.find(Producto.class, 1);
            Producto pB = em2.find(Producto.class, 1);
            System.out.println("A lee: " + pA);
            System.out.println("B lee: " + pB);

            pA.setStock(pA.getStock() - 1);                // A vende 1 unidad
            System.out.println("--- commit de A ---");
            em1.getTransaction().commit();
            System.out.println("A guarda: " + pA);

            pB.setStock(pB.getStock() - 2);                // B vende 2, pero con datos ANTIGUOS
            System.out.println("--- commit de B ---");
            try {
                em2.getTransaction().commit();
            } catch (RuntimeException e) {
                System.out.println("B falla: " + e.getClass().getSimpleName());
                System.out.println("  causa: " + e.getCause().getClass().getName());
            }
        }

        // Restauramos el stock original (25)
        JpaUtil.getEmf().runInTransaction(em -> {
            Producto p = em.find(Producto.class, 1);
            p.setStock(25);
            System.out.println("Restaurado: " + p);
        });
        JpaUtil.cerrar();
    }
}
Salida real (de la primera ejecución, con la columna version recién creada):
Hibernate:
    select
        p1_0.producto_id,
        ...
        p1_0.version
    from
        productos p1_0
    where
        p1_0.producto_id=?
Hibernate: select ... from productos p1_0 where p1_0.producto_id=?
A lee: Producto[1, Portátil UltraBook 14, precio=899.00, stock=25, v0]
B lee: Producto[1, Portátil UltraBook 14, precio=899.00, stock=25, v0]
--- commit de A ---
Hibernate:
    update
        productos
    set
        categoria_id=?,
        descatalogado=?,
        descripcion=?,
        fecha_alta=?,
        nombre=?,
        precio=?,
        stock=?,
        version=?
    where
        producto_id=?
        and version=?
A guarda: Producto[1, Portátil UltraBook 14, precio=899.00, stock=24, v1]
--- commit de B ---
Hibernate: update productos set ... where producto_id=? and version=?
B falla: RollbackException
  causa: jakarta.persistence.OptimisticLockException
Hibernate: select ... from productos p1_0 where p1_0.producto_id=?
Restaurado: Producto[1, Portátil UltraBook 14, precio=899.00, stock=25, v1]
Hibernate: update productos set ... where producto_id=? and version=?
El UPDATE de A lleva and version=? (0) y pone version=? (1). El de B busca la versión 0, que ya no existe: 0 filas afectadas, OptimisticLockException y rollback. La venta de A no se pierde. Lo que debe hacer la aplicación con B es releer el producto y reintentar (o avisar al usuario de que alguien modificó los datos): lo implementarás en el ejercicio 6.
💡 Consejo: El bloqueo optimista es la opción recomendada en aplicaciones web: no bloquea nada en la base de datos y el coste es una columna y una condición en el
WHERE. El campo@Versionpuede serint,Integer,long,Long,shorto unInstant/LocalDateTime(marca de tiempo); los enteros son más fiables. No lo modifiques nunca a mano.
15. Bloqueo pesimista
📘 Concepto: El bloqueo pesimista supone que el conflicto es probable y bloquea la fila en la base de datos al leerla (
SELECT ... FOR UPDATE). Otras transacciones que intenten bloquearla esperan hasta que la primera termine (o fallan si se indica un tiempo de espera).
public class Ejemplo14Pesimista {

    public static void main(String[] args) {
        try (EntityManager em1 = JpaUtil.crearEntityManager();
             EntityManager em2 = JpaUtil.crearEntityManager()) {

            em1.getTransaction().begin();
            System.out.println("--- A bloquea el producto 2 ---");
            Producto p = em1.find(Producto.class, 2, LockModeType.PESSIMISTIC_WRITE);
            System.out.println("A tiene el bloqueo: " + p);

            em2.getTransaction().begin();
            System.out.println("--- B intenta bloquearlo sin esperar (timeout 0) ---");
            try {
                em2.find(Producto.class, 2, LockModeType.PESSIMISTIC_WRITE,
                        Map.of("jakarta.persistence.lock.timeout", 0));
            } catch (RuntimeException e) {
                System.out.println("B no puede: " + e.getClass().getSimpleName());
            }
            em2.getTransaction().rollback();

            p.setStock(p.getStock() - 1);
            em1.getTransaction().commit();               // libera el bloqueo
            System.out.println("A termina: " + p);

            em1.getTransaction().begin();                // restauramos el stock (10)
            em1.find(Producto.class, 2).setStock(10);
            em1.getTransaction().commit();
        }
        JpaUtil.cerrar();
    }
}
Salida real (de la primera ejecución):
--- A bloquea el producto 2 ---
Hibernate:
    select
        p1_0.producto_id,
        ...
        p1_0.version
    from
        productos p1_0
    where
        p1_0.producto_id=?
    for
        updateof p1_0
A tiene el bloqueo: Producto[2, Portátil Gaming 16, precio=1499.00, stock=10, v0]
--- B intenta bloquearlo sin esperar (timeout 0) ---
Hibernate:
    select
        ...
    where
        p1_0.producto_id=?
    for
        updateof p1_0 nowait
WARN  org.hibernate.orm.jdbc.error - HHH000247: ErrorCode: 3572, SQLState: HY000
WARN  org.hibernate.orm.jdbc.error - Statement aborted because lock(s) could not be acquired immediately and NOWAIT is set.
B no puede: LockTimeoutException
Hibernate: update productos set ... where producto_id=? and version=?
A termina: Producto[2, Portátil Gaming 16, precio=1499.00, stock=9, v1]
Hibernate: update productos set ... where producto_id=? and version=?
La sentencia real es select ... for update of p1_0 (el formateador de Hibernate pega update y of en la salida: updateof). Con lock.timeout = 0, Hibernate añade nowait y MySQL responde al instante con el error 3572, que Hibernate traduce a LockTimeoutException. Sin esa pista, B se quedaría esperando hasta que A hiciera commit (o hasta el innodb_lock_wait_timeout de MySQL, 50 segundos por defecto).
LockModeType | Efecto |
|---|---|
OPTIMISTIC | Comprueba la versión al final de la transacción aunque la entidad no se modifique |
OPTIMISTIC_FORCE_INCREMENT | Además, incrementa la versión |
PESSIMISTIC_READ | Bloqueo compartido: otros pueden leer, nadie puede modificar |
PESSIMISTIC_WRITE | Bloqueo exclusivo (for update) |
PESSIMISTIC_FORCE_INCREMENT | Exclusivo + incrementa la versión |
⚠️ Importante: Los bloqueos pesimistas reducen la concurrencia y pueden provocar interbloqueos (deadlocks) si dos transacciones bloquean filas en distinto orden (lo viste con hilos en el módulo 06). Mantén esas transacciones muy cortas, bloquea siempre en el mismo orden y usa un tiempo de espera. Para un simple descuento de stock, a menudo basta con un
UPDATEatómico:update ... set stock = stock - ? where id = ? and stock >= ?(lo verás en el módulo 17).
16. Estadísticas de Hibernate
Con hibernate.generate_statistics = true, Hibernate cuenta todo lo que hace. Es la forma más fiable de detectar problemas como el N+1 en las pruebas automáticas (por ejemplo, comprobar con AssertJ que un listado ejecuta como mucho 2 sentencias).
public class Ejemplo15Estadisticas {

    public static void main(String[] args) {
        Map<String, Object> props = Map.of(
                "hibernate.show_sql", "false",
                "hibernate.generate_statistics", "true");
        try (EntityManagerFactory emf = Persistence.createEntityManagerFactory("empresa", props)) {
            Statistics st = emf.unwrap(SessionFactory.class).getStatistics();

            // Una pequeña "carga de trabajo"
            emf.runInTransaction(em -> {
                for (Departamento d : em.createQuery("select d from Departamento d", Departamento.class)
                        .getResultList()) {
                    d.getEmpleados().size();                        // inicializa cada colección
                }
                em.createQuery("select e from Empleado e where e.salario > 3000", Empleado.class)
                        .getResultList();
                em.find(Empleado.class, 100).setSalario(em.find(Empleado.class, 100).getSalario());
            });

            System.out.println("Sesiones abiertas ............ " + st.getSessionOpenCount());
            System.out.println("Transacciones ................ " + st.getTransactionCount());
            System.out.println("Sentencias JDBC preparadas ... " + st.getPrepareStatementCount());
            System.out.println("Consultas JPQL ejecutadas .... " + st.getQueryExecutionCount());
            System.out.println("Entidades cargadas ........... " + st.getEntityLoadCount());
            System.out.println("Colecciones cargadas ......... " + st.getCollectionLoadCount());
            System.out.println("Entidades actualizadas ....... " + st.getEntityUpdateCount());
            System.out.println("Consulta más lenta ........... " + st.getQueryExecutionMaxTimeQueryString());
        }
    }
}
Salida real:
Sesiones abiertas ............ 1
Transacciones ................ 1
Sentencias JDBC preparadas ... 9
Consultas JPQL ejecutadas .... 2
Entidades cargadas ........... 30
Colecciones cargadas ......... 7
Entidades actualizadas ....... 0
Consulta más lenta ........... select d from Departamento d
Interpretación: 2 consultas JPQL, pero 9 sentencias: las 7 restantes son la carga de la colección de empleados de cada departamento (otro N+1, esta vez con una colección). 30 entidades cargadas = 7 departamentos + 23 empleados con departamento. Ningún UPDATE, porque asignar el mismo salario no ensucia la entidad. Y el find del empleado 100 no generó sentencia: ya estaba en el contexto.
💡 Consejo: Activa las estadísticas en desarrollo y pruebas, no en producción (tienen un pequeño coste). Además de estos contadores,
st.getQueryStatistics("select ...")da el tiempo medio y máximo de cada consulta, y con el loggerorg.hibernate.SQL_SLOWHibernate puede avisar de las consultas que superen un umbral (hibernate.log_slow_query, en milisegundos).
17. Buenas prácticas de rendimiento
| Práctica | Por qué |
|---|---|
Todas las relaciones LAZY y cargar lo necesario por consulta (join fetch, entity graph) | Evita cargar datos que no se usan y el N+1 de EAGER |
| Proyecciones a DTO para listados e informes | Solo las columnas necesarias, sin contexto de persistencia ni dirty checking |
hibernate.default_batch_fetch_size (10-50) | Red de seguridad contra el N+1 en colecciones y relaciones |
| Paginar siempre los listados, con orden único | Nunca cargar tablas enteras |
No paginar con join fetch de colecciones | Hibernate paginaría en memoria |
Operaciones masivas con update/delete JPQL | Una sentencia en lugar de N |
flush() + clear() cada N elementos en procesos por lotes | Evita que el contexto de persistencia crezca sin límite |
Transacciones de solo lectura donde proceda (@Transactional(readOnly = true) en Spring) | Hibernate se ahorra el dirty checking |
Índices en las columnas de where, join y order by | El ORM no sustituye al diseño de la base de datos |
| Caché L2 solo para datos muy leídos y poco modificados | La caché mal usada sirve datos obsoletos y consume memoria |
@Version en las entidades que se editan concurrentemente | Evita actualizaciones perdidas sin bloquear |
| Mirar el SQL y contar sentencias en las pruebas | Los problemas de rendimiento no dan errores: hay que buscarlos |
18. Ejercicios
Los ejercicios 3 y 4 crean la fábrica sin el log de SQL para que la salida sea breve; en el resto se muestra solo la sentencia principal.
Ejercicio 1: Altas recientes con un record anidado
Lista los empleados dados de alta desde el 1 de enero de 2021 (fecha, nombre completo y departamento, o “(sin departamento)” si no tienen) ordenados por fecha, proyectando a un record declarado dentro de la clase del ejercicio.
Ver solución
public class Ejercicio1 {

    record Alta(String empleado, String departamento, LocalDate fecha) { }

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            List<Alta> altas = em.createQuery("""
                    select new es.curso.empresa.ejercicios.Ejercicio1$Alta(
                               concat(e.nombre, ' ', e.apellidos),
                               coalesce(d.nombre, '(sin departamento)'),
                               e.fechaAlta)
                    from Empleado e left join e.departamento d
                    where e.fechaAlta >= :desde
                    order by e.fechaAlta""", Alta.class)
                    .setParameter("desde", LocalDate.of(2021, 1, 1))
                    .getResultList();
            altas.forEach(a -> System.out.printf("%s  %-22s %s%n", a.fecha(), a.empleado(), a.departamento()));
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        concat(e1_0.nombre, ' ', e1_0.apellidos),
        coalesce(d1_0.nombre, '(sin departamento)'),
        e1_0.fecha_alta
    from
        empleados e1_0
    left join
        departamentos d1_0
            on d1_0.dept_id=e1_0.dept_id
    where
        e1_0.fecha_alta>=?
    order by
        e1_0.fecha_alta
2021-04-12  Álvaro Peña Cano       MARKETING
2021-09-01  Sergio Jiménez Vidal   VENTAS
2022-06-01  Sara Ortiz Delgado     INFORMÁTICA
2022-10-17  Manuel Herrero Lozano  LOGÍSTICA
2023-01-09  Jorge Vázquez Ramos    CONTABILIDAD
2025-09-01  Tomás Reyes Fuentes    (sin departamento)
Dos detalles: el left join explícito es imprescindible para que aparezca Tomás (con e.departamento.nombre el join implícito sería inner y lo perderíamos), y un record anidado se nombra en select new con $ (Ejercicio1$Alta), igual que su nombre binario en Java.
Ejercicio 2: Ventas mensuales de 2025
Calcula, para cada mes de 2025, el número de pedidos y el importe vendido (excluyendo los cancelados), y el total del año. Usa extract en JPQL y una proyección a record.
Ver solución
public class Ejercicio2 {

    record VentasMes(Integer mes, Long pedidos, BigDecimal importe) { }

    public static void main(String[] args) {
        try (EntityManager em = JpaUtil.crearEntityManager()) {
            List<VentasMes> meses = em.createQuery("""
                    select new es.curso.empresa.ejercicios.Ejercicio2$VentasMes(
                               extract(month from p.fechaPedido),
                               count(distinct p),
                               sum(l.cantidad * l.precioUnitario * (1 - l.descuento / 100)))
                    from LineaPedido l join l.pedido p
                    where extract(year from p.fechaPedido) = :anio
                      and p.estado <> es.curso.empresa.modelo.EstadoPedido.CANCELADO
                    group by extract(month from p.fechaPedido)
                    order by 1""", VentasMes.class)
                    .setParameter("anio", 2025)
                    .getResultList();
            BigDecimal total = BigDecimal.ZERO;
            for (VentasMes m : meses) {
                System.out.printf("Mes %2d: %d pedidos  %10.2f €%n", m.mes(), m.pedidos(), m.importe());
                total = total.add(m.importe());
            }
            System.out.printf("Total 2025:        %10.2f €%n", total);
        }
        JpaUtil.cerrar();
    }
}
Salida real:
Hibernate:
    select
        month(p1_0.fecha_pedido),
        count(distinct p1_0.pedido_id),
        sum(((lp1_0.cantidad*lp1_0.precio_unitario)*(1-(lp1_0.descuento/100))))
    from
        lineas_pedido lp1_0
    join
        pedidos p1_0
            on p1_0.pedido_id=lp1_0.pedido_id
    where
        year(p1_0.fecha_pedido)=?
        and p1_0.estado<>'CANCELADO'
    group by
        month(p1_0.fecha_pedido)
    order by
        1
Mes  1: 2 pedidos     9205.40 €
Mes  2: 2 pedidos     6791.40 €
Mes  3: 2 pedidos     1375.20 €
Mes  4: 1 pedidos     2539.13 €
Mes  5: 1 pedidos     4772.44 €
Mes  6: 2 pedidos    12656.50 €
Mes  9: 1 pedidos     1658.80 €
Mes 10: 1 pedidos     1555.00 €
Mes 11: 2 pedidos      358.80 €
Total 2025:          40912.67 €
En mayo solo cuenta un pedido: el 5008 está cancelado. extract(month ...) devuelve Integer, por eso el primer componente del record es Integer. Julio y agosto no aparecen porque no hubo pedidos; si el informe debiera mostrar los doce meses, habría que rellenar los huecos en Java.
Ejercicio 3: Buscador de productos con Criteria
Escribe un buscador de productos no descatalogados con cuatro filtros opcionales: texto contenido en el nombre (sin distinguir mayúsculas), precio máximo, categoría y “solo con stock”. Debe devolver los resultados ordenados por precio y el número total de coincidencias (con una segunda consulta count). Reutiliza la construcción de los predicados para ambas consultas.
Ver solución
public class Ejercicio3 {

    /** Filtros opcionales del buscador de productos (null = sin filtro). */
    record Filtro(String texto, BigDecimal precioMaximo, Integer categoriaId, boolean soloConStock) { }

    static List<Predicate> predicados(CriteriaBuilder cb, Root<Producto> p, Filtro f) {
        List<Predicate> lista = new ArrayList<>();
        lista.add(cb.isFalse(p.get("descatalogado")));
        if (f.texto() != null) {
            lista.add(cb.like(cb.lower(p.get("nombre")), "%" + f.texto().toLowerCase() + "%"));
        }
        if (f.precioMaximo() != null) {
            lista.add(cb.le(p.get("precio"), f.precioMaximo()));
        }
        if (f.categoriaId() != null) {
            lista.add(cb.equal(p.get("categoria").get("id"), f.categoriaId()));
        }
        if (f.soloConStock()) {
            lista.add(cb.gt(p.get("stock"), 0));
        }
        return lista;
    }

    static void buscar(EntityManager em, Filtro f) {
        CriteriaBuilder cb = em.getCriteriaBuilder();

        CriteriaQuery<Producto> cq = cb.createQuery(Producto.class);
        Root<Producto> p = cq.from(Producto.class);
        cq.where(predicados(cb, p, f).toArray(Predicate[]::new)).orderBy(cb.asc(p.get("precio")));
        List<Producto> resultado = em.createQuery(cq).getResultList();

        CriteriaQuery<Long> cuenta = cb.createQuery(Long.class);
        Root<Producto> pc = cuenta.from(Producto.class);
        cuenta.select(cb.count(pc)).where(predicados(cb, pc, f).toArray(Predicate[]::new));
        Long total = em.createQuery(cuenta).getSingleResult();

        System.out.println(f + " -> " + total + " productos");
        resultado.forEach(x -> System.out.println("   " + x.getNombre() + " " + x.getPrecio() + " (stock " + x.getStock() + ")"));
    }

    public static void main(String[] args) {
        try (var emf = Persistence.createEntityManagerFactory("empresa", Map.of("hibernate.show_sql", "false"));
             EntityManager em = emf.createEntityManager()) {
            buscar(em, new Filtro("portátil", null, null, false));
            buscar(em, new Filtro(null, new BigDecimal("100"), 5, true));
            buscar(em, new Filtro("monitor", new BigDecimal("200"), null, true));
        }
    }
}
Salida real:
Filtro[texto=portátil, precioMaximo=null, categoriaId=null, soloConStock=false] -> 3 productos
   Portátil Básico 15 499.00 (stock 40)
   Portátil UltraBook 14 899.00 (stock 25)
   Portátil Gaming 16 1499.00 (stock 10)
Filtro[texto=null, precioMaximo=100, categoriaId=5, soloConStock=true] -> 2 productos
   Ratón inalámbrico 19.90 (stock 200)
   Teclado mecánico 79.90 (stock 60)
Filtro[texto=monitor, precioMaximo=200, categoriaId=null, soloConStock=true] -> 1 productos
   Monitor 24 FHD 139.00 (stock 35)
El pack de teclado y ratón (categoría 5, 34,50 €) no aparece en la segunda búsqueda porque tiene stock 0. Los predicados se construyen dos veces porque cada Root pertenece a su propia CriteriaQuery. El filtro descatalogado funciona con isFalse gracias al conversor SiNoConverter: Hibernate compara con 'N'. p.get("categoria").get("id") no genera JOIN: compara directamente la columna categoria_id.
Ejercicio 4: Paginación con un record Pagina
Crea un record genérico Pagina<T>(List<T> contenido, int numero, int tamano, long totalElementos) con los métodos totalPaginas() y hayMas(), y un método que devuelva una página de clientes ordenados por provincia y nombre. Recorre todas las páginas de 4 en 4.
Ver solución
public class Ejercicio4 {

    record Pagina<T>(List<T> contenido, int numero, int tamano, long totalElementos) {
        long totalPaginas() { return (totalElementos + tamano - 1) / tamano; }
        boolean hayMas() { return numero + 1 < totalPaginas(); }
    }

    static Pagina<Cliente> clientes(EntityManager em, int numero, int tamano) {
        long total = em.createQuery("select count(c) from Cliente c", Long.class).getSingleResult();
        List<Cliente> lista = em.createQuery(
                "select c from Cliente c order by c.provincia, c.nombre", Cliente.class)
                .setFirstResult(numero * tamano)
                .setMaxResults(tamano)
                .getResultList();
        return new Pagina<>(lista, numero, tamano, total);
    }

    public static void main(String[] args) {
        try (var emf = Persistence.createEntityManagerFactory("empresa", Map.of("hibernate.show_sql", "false"));
             EntityManager em = emf.createEntityManager()) {
            int n = 0;
            Pagina<Cliente> pag;
            do {
                pag = clientes(em, n, 4);
                System.out.println("Página " + (pag.numero() + 1) + " de " + pag.totalPaginas() + ":");
                pag.contenido().forEach(c -> System.out.println("   " + c.getProvincia() + " - " + c.getNombre()));
                n++;
            } while (pag.hayMas());
        }
    }
}
Salida real:
Página 1 de 4:
   Alicante - Construcciones Levante S.A.
   Asturias - Farmacia Central
   Barcelona - Diseños Creativos S.L.
   Bizkaia - Laura Benítez Sanz
Página 2 de 4:
   Granada - Instituto Tecnológico Sur
   Illes Balears - Hotel Mar Azul S.L.
   Madrid - Academia Nova
   Madrid - María José Herrera
Página 3 de 4:
   Sevilla - Antonio Ruiz Pérez
   Sevilla - Clínica Dental Sonrisa
   Valencia - Carlos Ibáñez Rey
   Valencia - Talleres Martín S.L.
Página 4 de 4:
   Valladolid - Panadería La Espiga
   Zaragoza - Gestoría Delta
Es, en pequeño, lo que hacen Pageable y Page de Spring Data (módulo 19). El orden por provincia y nombre garantiza que no haya empates que muevan filas entre páginas. En una aplicación real, la consulta count se puede evitar en las páginas siguientes a la primera si el total no cambia.
Ejercicio 5: De 10 sentencias a 1
Muestra para cada proyecto su departamento, el número de personas asignadas y las horas totales. Hazlo primero navegando por las relaciones y después con una única consulta de agregación con left join, y compara el número de sentencias con las estadísticas.
Ver solución
public class Ejercicio5 {

    record ResumenProyecto(String proyecto, String departamento, Long personas, Long horas) { }

    public static void main(String[] args) {
        try (EntityManagerFactory emf = Persistence.createEntityManagerFactory("empresa",
                Map.of("hibernate.show_sql", "false", "hibernate.generate_statistics", "true"))) {
            Statistics st = emf.unwrap(SessionFactory.class).getStatistics();

            // Versión ingenua: navegar por las relaciones perezosas
            st.clear();
            try (EntityManager em = emf.createEntityManager()) {
                for (Proyecto p : em.createQuery("select p from Proyecto p order by p.id", Proyecto.class)
                        .getResultList()) {
                    int horas = p.getAsignaciones().stream().mapToInt(a -> a.getHoras()).sum();
                    System.out.println("  " + p.getNombre() + " | " + p.getDepartamento().getNombre()
                            + " | " + p.getAsignaciones().size() + " personas | " + horas + " h");
                }
            }
            System.out.println("Versión ingenua: " + st.getPrepareStatementCount() + " sentencias");

            // Versión optimizada: una sola consulta de agregación con proyección a record
            st.clear();
            try (EntityManager em = emf.createEntityManager()) {
                List<ResumenProyecto> lista = em.createQuery("""
                        select new es.curso.empresa.ejercicios.Ejercicio5$ResumenProyecto(
                                   p.nombre, d.nombre, count(a), coalesce(sum(a.horas), 0))
                        from Proyecto p join p.departamento d left join p.asignaciones a
                        group by p.id, p.nombre, d.nombre
                        order by p.id""", ResumenProyecto.class).getResultList();
                lista.forEach(r -> System.out.println("  " + r.proyecto() + " | " + r.departamento()
                        + " | " + r.personas() + " personas | " + r.horas() + " h"));
            }
            System.out.println("Versión optimizada: " + st.getPrepareStatementCount() + " sentencia(s)");
        }
    }
}
Salida real:
  Migración a la nube | INFORMÁTICA | 3 personas | 1430 h
  Nueva tienda online | INFORMÁTICA | 4 personas | 1350 h
  Campaña Navidad 2025 | MARKETING | 4 personas | 480 h
  Optimización de almacén | LOGÍSTICA | 3 personas | 300 h
  Plan estratégico 2027 | DIRECCIÓN | 0 personas | 0 h
Versión ingenua: 10 sentencias
  Migración a la nube | INFORMÁTICA | 3 personas | 1430 h
  Nueva tienda online | INFORMÁTICA | 4 personas | 1350 h
  Campaña Navidad 2025 | MARKETING | 4 personas | 480 h
  Optimización de almacén | LOGÍSTICA | 3 personas | 300 h
  Plan estratégico 2027 | DIRECCIÓN | 0 personas | 0 h
Versión optimizada: 1 sentencia(s)
Mismo resultado, una décima parte de sentencias. Las 10 de la versión ingenua son: 1 de proyectos + 5 colecciones de asignaciones + 4 departamentos (INFORMÁTICA se repite y sale del contexto de persistencia). El left join mantiene el proyecto 5 aunque no tenga asignaciones, y coalesce(sum(...), 0) evita el null de sumar un conjunto vacío.
Ejercicio 6: Reintento ante un conflicto de versión
Escribe retirarStock(productoId, cantidad) que use el bloqueo optimista y, si se produce un conflicto de versión, reintente hasta tres veces leyendo de nuevo el producto. Simula que, durante el primer intento, otro usuario retira una unidad del mismo producto. Si no hay stock suficiente, lanza IllegalStateException. Restaura el stock al terminar.
Ver solución
public class Ejercicio6 {

    static EntityManagerFactory emf;
    static boolean simularConflicto = true;     // solo en el primer intento

    /** Retira unidades del stock; si otro usuario modificó el producto, reintenta (máx. 3 veces). */
    static void retirarStock(int productoId, int cantidad) {
        for (int intento = 1; intento <= 3; intento++) {
            try (EntityManager em = emf.createEntityManager()) {
                em.getTransaction().begin();
                Producto p = em.find(Producto.class, productoId);
                if (p.getStock() < cantidad) {
                    em.getTransaction().rollback();
                    throw new IllegalStateException("Stock insuficiente de " + p.getNombre());
                }
                if (simularConflicto) {                 // otro "usuario" se adelanta
                    simularConflicto = false;
                    emf.runInTransaction(otro -> otro.find(Producto.class, productoId)
                            .setStock(otro.find(Producto.class, productoId).getStock() - 1));
                    System.out.println("  (otro usuario ha retirado 1 unidad mientras tanto)");
                }
                p.setStock(p.getStock() - cantidad);
                em.getTransaction().commit();
                System.out.println("Intento " + intento + ": OK, stock = " + p.getStock() + ", versión " + p.getVersion());
                return;
            } catch (RollbackException e) {
                if (!(e.getCause() instanceof OptimisticLockException)) throw e;
                System.out.println("Intento " + intento + ": conflicto de versión, se reintenta");
            }
        }
        throw new IllegalStateException("No se pudo retirar el stock tras 3 intentos");
    }

    public static void main(String[] args) {
        emf = Persistence.createEntityManagerFactory("empresa", Map.of("hibernate.show_sql", "false"));
        try {
            Producto antes = emf.callInTransaction(em -> em.find(Producto.class, 9));
            System.out.println("Antes: stock = " + antes.getStock() + ", versión " + antes.getVersion());
            retirarStock(9, 5);
            try {
                retirarStock(9, 1000);
            } catch (IllegalStateException e) {
                System.out.println("Error: " + e.getMessage());
            }
        } finally {
            emf.runInTransaction(em -> em.find(Producto.class, 9).setStock(35));   // stock original
            emf.close();
        }
    }
}
Salida real:
Antes: stock = 35, versión 0
  (otro usuario ha retirado 1 unidad mientras tanto)
Intento 1: conflicto de versión, se reintenta
Intento 2: OK, stock = 29, versión 2
Error: Stock insuficiente de Monitor 24 FHD
El primer intento leyó la versión 0; el “otro usuario” la subió a 1, así que el commit falló. El segundo intento empieza con un EntityManager nuevo, lee los datos actuales (stock 34, versión 1) y guarda 29 con versión 2: ninguna de las dos retiradas se pierde. Es imprescindible un EntityManager nuevo en cada intento: el anterior queda inservible tras el rollback. Spring ofrece este patrón con anotaciones (@Retryable, módulo 17).
Ejercicios propuestos
Ejercicio 7: Ranking de comerciales
Con una sola consulta JPQL, obtén para cada vendedor (empleado con pedidos asignados) el número de pedidos, el número de clientes distintos y el importe total vendido en 2025 y 2026 por separado (pista: sum(case when extract(year from p.fechaPedido) = 2025 then ... else 0 end)). Ordena por el total y proyecta a un record.
Ejercicio 8: @NamedEntityGraph con subgrafo
Define un grafo Pedido.completo que cargue el cliente, las líneas y el producto de cada línea (@NamedSubgraph). Úsalo con em.find(Pedido.class, 5010, Map.of("jakarta.persistence.fetchgraph", grafo)) y comprueba en el log que se genera una sola consulta. ¿Qué diferencia hay entre fetchgraph y loadgraph?
Ejercicio 9: Metamodelo
Añade hibernate-processor al pom.xml, compila y localiza las clases generadas en target/generated-sources/annotations. Reescribe el buscador del ejercicio 3 usando Producto_.nombre, Producto_.precio, etc. Introduce a propósito un error de tipo (comparar Producto_.stock con un String) y observa que ahora falla al compilar.
Ejercicio 10: Procesamiento por lotes
Escribe un programa que inserte 2000 clientes de prueba (NIF T0000001 a T0002000) haciendo flush() y clear() cada 50, mida el tiempo y cuente las sentencias con las estadísticas. Repite con hibernate.jdbc.batch_size = 50. ¿Cambia algo con la estrategia IDENTITY? Borra después los clientes con un delete masivo.
Ejercicio 11: Caché de categorías
Marca Categoria como @Cacheable con READ_ONLY y escribe un programa que recorra el árbol de categorías tres veces, cada vez con un EntityManager nuevo, mostrando los aciertos y fallos de la caché L2 tras cada recorrido. ¿Se cachean también las colecciones hijas? Investiga @Cache sobre una colección.
Ejercicio 12: Bloqueo pesimista con espera
Modifica el ejemplo 14 para que B espere con jakarta.persistence.lock.timeout = 3000 (3 segundos) en un hilo virtual (módulo 07) mientras A mantiene el bloqueo 1 segundo antes de hacer commit. Muestra los instantes en que B pide y obtiene el bloqueo. ¿Qué ocurre si A tarda 5 segundos?
Resumen
| Concepto | Sintaxis / clave |
|---|---|
| JPQL | em.createQuery("select e from Empleado e where ...", Empleado.class) |
| Parámetros | :nombre + setParameter("nombre", v), ?1 + setParameter(1, v) |
| Resultados | getResultList(), getSingleResult(), getResultStream() |
| Proyecciones | Escalares, Object[], Tuple, select new paquete.Dto(...) |
| Joins | join, left join, join ... on, navegación con . (inner implícito) |
| Carga en la consulta | join fetch, left join fetch |
| Agregados | count, sum, avg, min, max, group by, having |
| Subconsultas | exists, not exists, in, not in, escalares en where |
| Funciones | concat, upper, coalesce, case, extract(year from ...) |
| Paginación | setFirstResult(pagina * tamano), setMaxResults(tamano) + order by único |
| Consultas con nombre | @NamedQuery(name, query) + createNamedQuery (validadas al arrancar) |
| Criteria API | CriteriaBuilder, CriteriaQuery, Root, Predicate; metamodelo Entidad_ |
| SQL nativo | createNativeQuery(sql[, Entidad.class]) |
| Masivas | update ... set ... where, delete from ... where + executeUpdate(); luego clear()/refresh() |
| N+1 | 1 + N consultas al acceder a relaciones LAZY en un bucle |
| Soluciones N+1 | join fetch, @NamedEntityGraph + jakarta.persistence.fetchgraph, default_batch_fetch_size/@BatchSize, DTO |
| Caché L2 | hibernate-jcache + proveedor, use_second_level_cache, @Cacheable + @Cache(usage = ...) |
| Bloqueo optimista | @Version; update ... where id = ? and version = ?; OptimisticLockException → reintentar |
| Bloqueo pesimista | LockModeType.PESSIMISTIC_WRITE (for update), jakarta.persistence.lock.timeout |
| Estadísticas | hibernate.generate_statistics, emf.unwrap(SessionFactory.class).getStatistics() |